做 AI 视频时,很多人最先研究的就是提示词。人物怎么写、运镜怎么写、电影感怎么写,恨不得把能想到的内容全部塞进一条 Prompt。但真正开始做连续视频以后,很快就会发现:
提示词写得很长,不代表视频就更可控。有时候你写了人物外貌、场景、动作、光线、构图、镜头和风格,最后模型反而不知道这一镜到底应该重点完成什么。尤其是剧情短视频、漫剧和小说改编视频,真正重要的已经不是“会不会写一句漂亮的 Prompt”,而是:
这一镜到底要发生什么。如果只记住一个原则,可以理解成:角色、场景和参考图负责固定“不应该变化的东西”,视频提示词负责描述“这一镜真正要发生的变化”。 前面的资料越稳定,Prompt 反而可以越短、越具体。
AI 视频提示词到底是用来控制什么的?
可以先把视频 Prompt 理解成:告诉视频模型,这几秒钟里应该发生什么变化。
这里的“变化”通常包括几类:
- 人物做什么动作
- 人物的表情和状态怎么变化
- 镜头怎么移动
- 画面中的物体怎么运动
- 环境有没有变化
- 这一镜最后停在什么状态
比如:
女生站在门口,先低头看了一眼手机,停顿片刻后缓慢抬头,看向走廊尽头。镜头从中景缓慢推进到近景,人物动作自然克制。
这就比:
一个女生站在走廊里,电影感,高级光影,氛围感,情绪压抑。
更接近一个真正可以执行的视频镜头,因为前者告诉模型:谁在动、怎么动、镜头怎么动。
写视频提示词之前,先把这一镜确定下来
如果连这一镜要拍什么都没有想清楚,Prompt 通常也很难写好。例如一段剧情是:
“男生带女朋友走到饭店包间门口,推开门以后,女生发现里面坐满了家人。”
不要直接把整段剧情塞进一个视频 Prompt。更适合先拆成几个镜头:
镜头 01:两人在走廊向包间走。
镜头 02:女生边走边问男生今天来了多少人。
镜头 03:男生推开包间门。
镜头 04:包间全景,一桌人同时看向门口。
镜头 05:女生表情僵住。
这时候,每个 Prompt 只需要解决一个镜头里的动作。这也是分镜和视频提示词最基本的关系:分镜决定拍什么,视频提示词负责告诉模型这一镜怎么动起来。
相关阅读:分镜怎么生成 AI 视频?从分镜脚本到可灵生成视频的完整流程
文生视频和参考图生视频,提示词不要用同一种写法
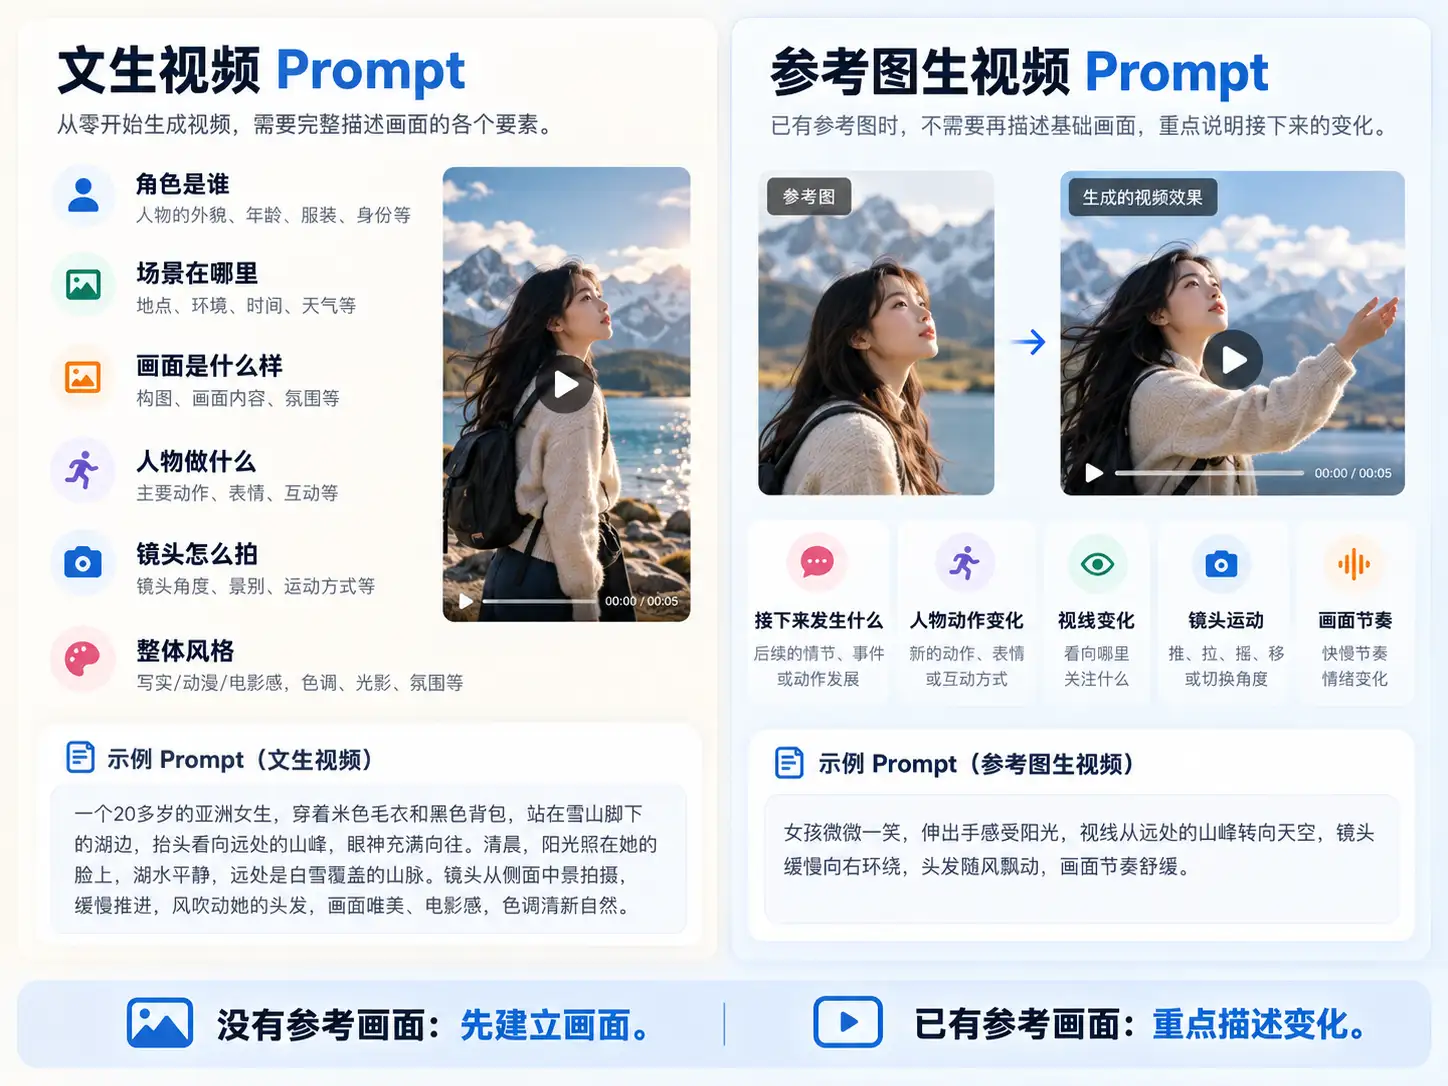
这是现在做 AI 视频时很容易忽略的一点。如果使用的是纯文生视频,模型一开始什么都不知道。这时候 Prompt 往往需要承担更多信息,例如:
人物是谁
人物在哪里
画面是什么样
人物做什么
镜头怎么拍
整体风格是什么
例如:
年轻女性站在昏暗的饭店走廊里,黑色长发,深色上衣,她停下脚步转头看向身旁的男生,中近景,镜头缓慢向前推进,暖黄色室内灯光,写实电影感。
但如果已经给了角色参考图、场景图或者当前镜头的起始画面,情况就不一样了。画面里已经能够看到:
人物长什么样。
穿什么衣服。
在哪里。
当前构图是什么。
这时候再把所有静态信息重新写一遍,不一定更好。Prompt 应该更集中在:接下来发生什么。例如:
女生先看向男生,短暂停顿后轻轻皱眉,再把视线转向前方。两人继续缓慢向前走,镜头保持同速跟拍,人物动作自然。
这就是两种 Prompt 非常重要的区别:
- 没有参考画面时,提示词需要建立画面。
- 已经有参考画面时,提示词更应该描述画面如何变化。
一条实用的视频 Prompt,重点可以拆成四部分
如果已经有分镜,视频提示词其实不用写得特别复杂。我更建议重点看下面四件事:
1. 主体动作
先说清楚这一镜谁在做什么。例如:
女生缓慢回头。
男人从椅子上站起来。
小孩提着灯笼向前跑。
两个人一边交谈一边沿走廊向前走。
尽量使用可以直接看到的动作,而不是只写:
悲伤。
紧张。
高兴。
有压迫感。
“紧张”可以转成:手指轻轻攥紧衣角,视线短暂移开。
“犹豫”可以转成:人物伸手准备推门,动作停顿片刻后才继续。
对于视频模型来说,这些才是真正能够表现出来的东西。
2. 动作过程
视频不是一张静态图。所以除了“人物做什么”,还可以交代动作怎么发生。例如:
男生抬起右手握住门把手,停顿约一秒,然后将门缓慢推开。
这里其实包含三个连续状态:抬手、停顿、推门。
但也不要在一个很短的视频里塞进太多动作。如果一条 5 秒左右的视频 Prompt 同时要求:
走路 → 停下 → 回头 → 说话 → 推门 → 进入房间 → 坐下
模型很难稳定完成。这种情况下,更适合继续拆镜头。
3. 镜头运动
接下来才是摄像机怎么拍。例如:
- 固定镜头。
- 缓慢推进。
- 镜头后退。
- 横向移动。
- 跟随人物向前。
- 围绕人物轻微移动。
镜头运动不要为了“有电影感”而硬加。如果这一镜的重点是人物表情,一个稳定的近景可能比复杂运镜更有效。如果这一镜包含摄影机运动,也可以把运镜理解成一个从 A 到 B 的变化过程:A 是镜头开始时摄影机和人物的位置,B 是镜头结束时的位置。 与其只写“缓慢推进”“跟拍”或“环绕”,不如进一步说明摄影机从哪里开始、往哪里移动、最后停在哪里,以及人物本身是否同时移动。
例如:
女生看到房间里坐满人后愣住,表情从微笑变成错愕。镜头保持稳定,近景拍摄。
这也是成立的视频 Prompt。相关阅读:漫剧分镜中的运镜设计方法
4. 需要保持的状态
如果是连续视频,还要考虑:哪些东西在这一镜里不能乱变。例如:
人物身份不能变。
服装不能突然改变。
当前环境不能突然换地方。
上一镜人物站在门外,下一镜不能莫名其妙已经坐在房间里。但这些内容不一定全部要靠 Prompt 重复描述。如果生成方式支持角色参考、场景参考、首帧图片或者其他参考资料,就可以让这些资料承担一部分一致性控制。提示词继续专注于当前镜头的变化。
这也是为什么做连续 AI 视频以后,提示词往往会和角色资产、场景资产、分镜以及参考图结合起来,而不是孤立存在。
角色一致性不是靠每条 Prompt 重写人物长相
很多人在做连续镜头时,会在每条提示词里重新写:
年轻女性,长黑发,白皙皮肤,黑色上衣……
下一镜再写一次。再下一镜继续写。问题是,只要每次描述稍微不同,模型对这个角色的理解就可能发生变化。更稳定的方法是:
- 先建立角色。
- 准备稳定的角色参考。
- 不同镜头继续引用同一个人物资料。
- Prompt 再负责当前镜头的动作。
简单来说:
角色资料告诉模型“这个人是谁”。视频 Prompt 告诉模型“这个人现在做什么”。
相关阅读:AI视频如何保证角色一致性?
场景也是一样
场景一致性也不应该完全靠每一条 Prompt 从头描述。
如果上一镜写:现代高级餐厅,暖黄色灯光,木质墙面。
下一镜变成:温馨饭店包间,柔和灯光。
第三镜又变成:中式餐厅室内,豪华装修。
人看起来觉得差不多,但模型可能把它们理解成三个不同地方。如果已经有稳定的场景参考,Prompt 就可以把注意力留给当前镜头。例如:
镜头从门口缓慢向房间内部推进,桌边的所有人陆续抬头看向门外。
环境仍然使用同一个场景参考。相关阅读:AI视频如何保证场景一致性?
一个实际的视频提示词怎么写?
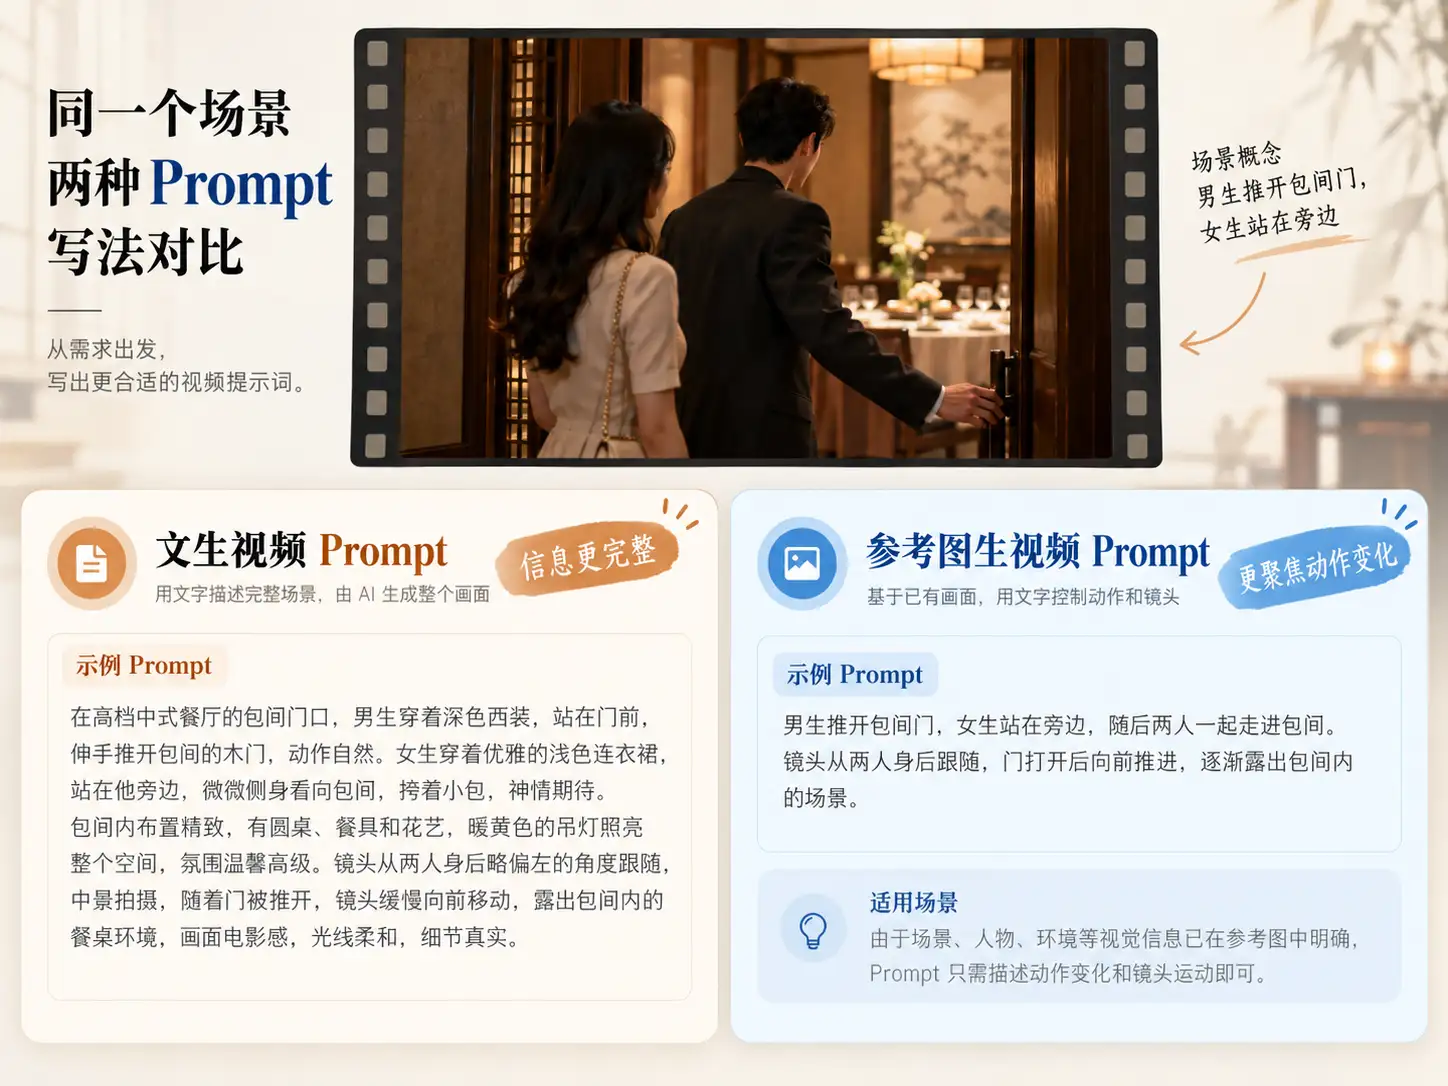
还是用刚才“第一次见男朋友家人”的例子。这一镜的分镜是:男生推开包间门,女生站在旁边。如果是文生视频,可以写得相对完整:
饭店包间门口,一男一女站在门外。男生抬手握住门把手,短暂停顿后缓慢将门推开,女生站在他身旁看向门内。中景,平视镜头,摄像机轻微向前推进,室内暖黄色灯光,人物动作自然真实。
但如果已经有这一镜的参考图,可以简化成:
男生抬起右手握住门把手,停顿片刻后缓慢把门推开。女生保持站在他身旁,视线逐渐转向房间内部。镜头轻微向前推进,动作自然平稳。
后一个 Prompt 没有重新解释两个人长什么样,也没有重新描述整个饭店。因为这些信息已经在画面里。它把生成资源集中在了:推门、转移视线和镜头推进。
Prompt 不要替代分镜
如果每次做视频都要从一整段故事重新思考:
- 人物是谁。
- 场景是什么。
- 这一镜做什么。
- 镜头怎么运动。
- 上一镜发生了什么。
那真正的问题其实已经不是 Prompt 了。而是缺少一套分镜结构。反过来,如果你已经有了完整分镜,也不代表可以马上进入视频生成。角色、场景、关键道具、参考图、生图提示词和前后镜头状态,往往还需要继续整理。关于已有分镜进入 AI 视频制作前还缺哪些资料,可以继续看《已有分镜脚本还不够:做 AI 视频前还要补齐哪些资料?》。对于多镜头剧情,我更推荐这样的工作流:
故事
↓
拆成分镜
↓
确定角色、场景和镜头关系
↓
准备需要的画面或参考资料
↓
为每个镜头生成视频提示词
↓
进入视频模型生成
↓
最后剪辑成完整内容
在小镜故事板里,视频提示词就是跟着具体镜头管理的。不需要一开始把所有视频提示词全部摆出来。到了需要使用的时候,可以根据当前镜头内容生成对应的视频提示词,再根据实际使用的视频模型继续修改。这样一条 Prompt 始终对应一条具体镜头,而不是把几十条 Prompt 单独放在文档里,做到后面连自己都不知道对应哪张图、哪个角色和哪个场景。
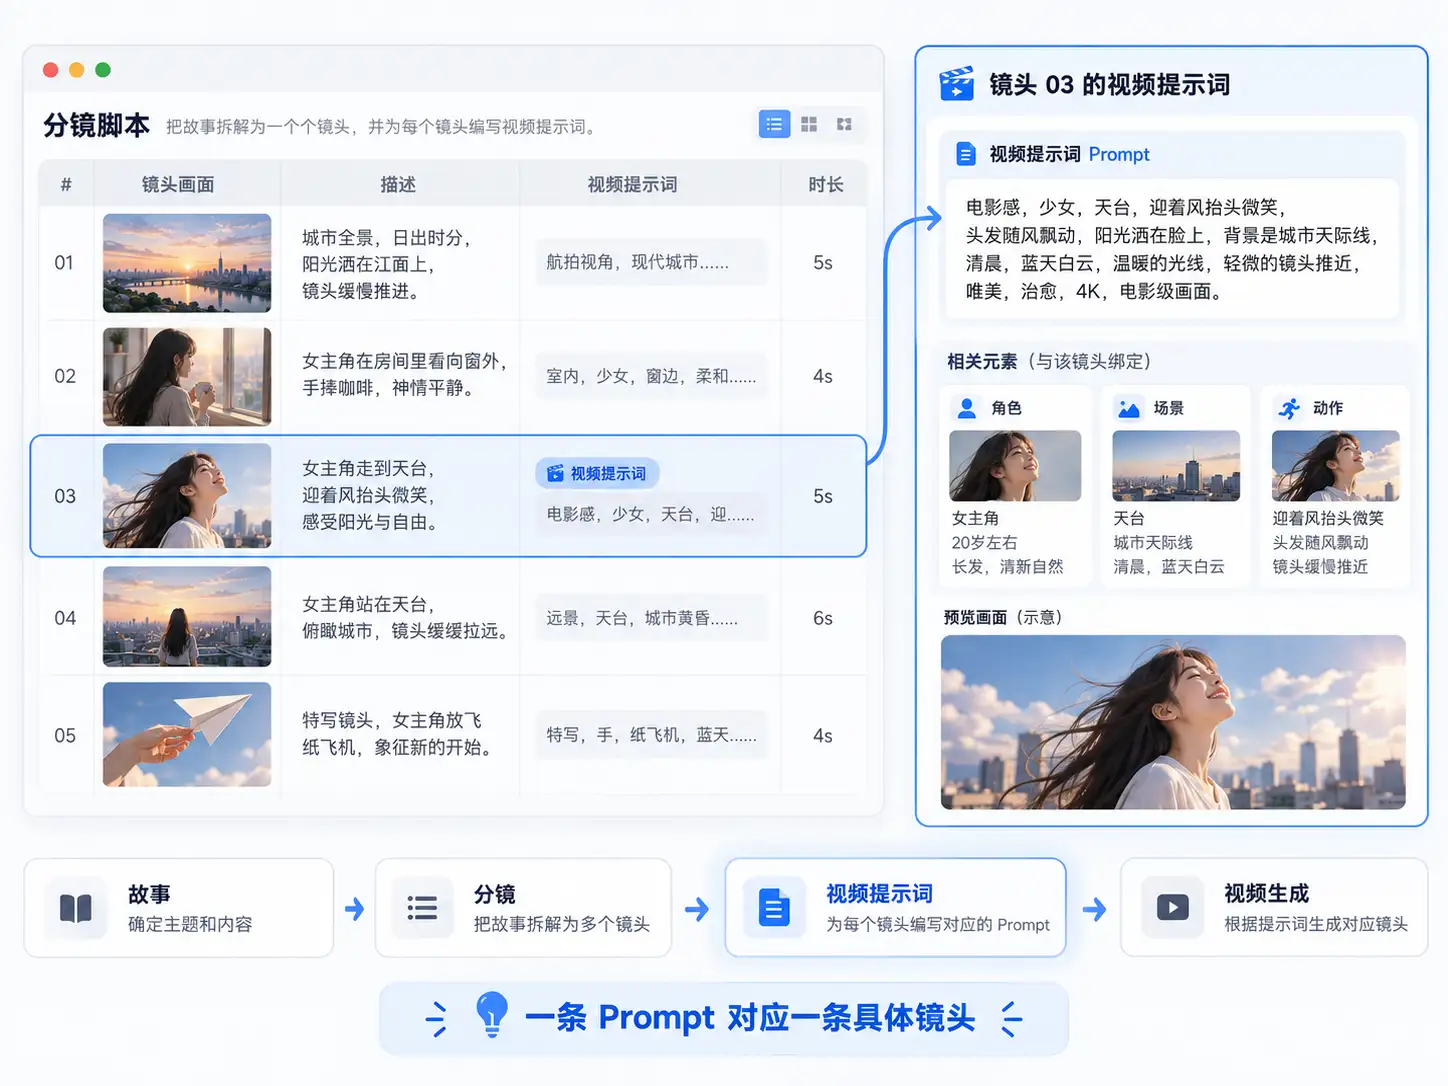
AI 视频提示词常见的几个问题
第一种,是一条 Prompt 塞太多剧情。如果短短几秒钟要求人物连续完成六七个动作,首先应该考虑的不是继续优化词,而是拆镜头。
第二种是只写画面,不写变化。“一个女孩坐在咖啡馆里,电影感,暖色光。”这更像一条生图 Prompt。视频 Prompt 应该继续回答:
她接下来做什么?
镜头接下来怎么动?
第三种是把抽象情绪当成动作。
“她非常紧张。”
不如写:
“她短暂低下视线,右手下意识握紧杯子。”
第四种是每一镜都重新创造角色和场景。
连续剧情里,这会让角色和环境越来越容易漂移。
第五种则是为了运镜而运镜。
一个镜头如果本身只需要看清人物反应,就不一定要同时加入推进、环绕、变焦和旋转。
总结
AI 视频提示词并不是一套万能公式。真正好用的 Prompt,应该服务于一个已经明确的镜头。
可以先记住几个原则:
- 先有分镜,再写视频提示词。
- 文生视频需要更多画面信息,参考图生视频更关注动作和变化。
- 角色和场景的稳定,尽量交给稳定资产和参考资料。
- Prompt 重点告诉模型:这一镜谁在动、怎么动、镜头怎么动。
- 一条 Prompt 做不完的剧情,就继续拆镜头。
当角色、场景、分镜和提示词各自承担清楚的任务以后,AI 视频 Prompt 就不再是一段不断堆关键词的文字。它会真正变成:一条镜头的执行说明。