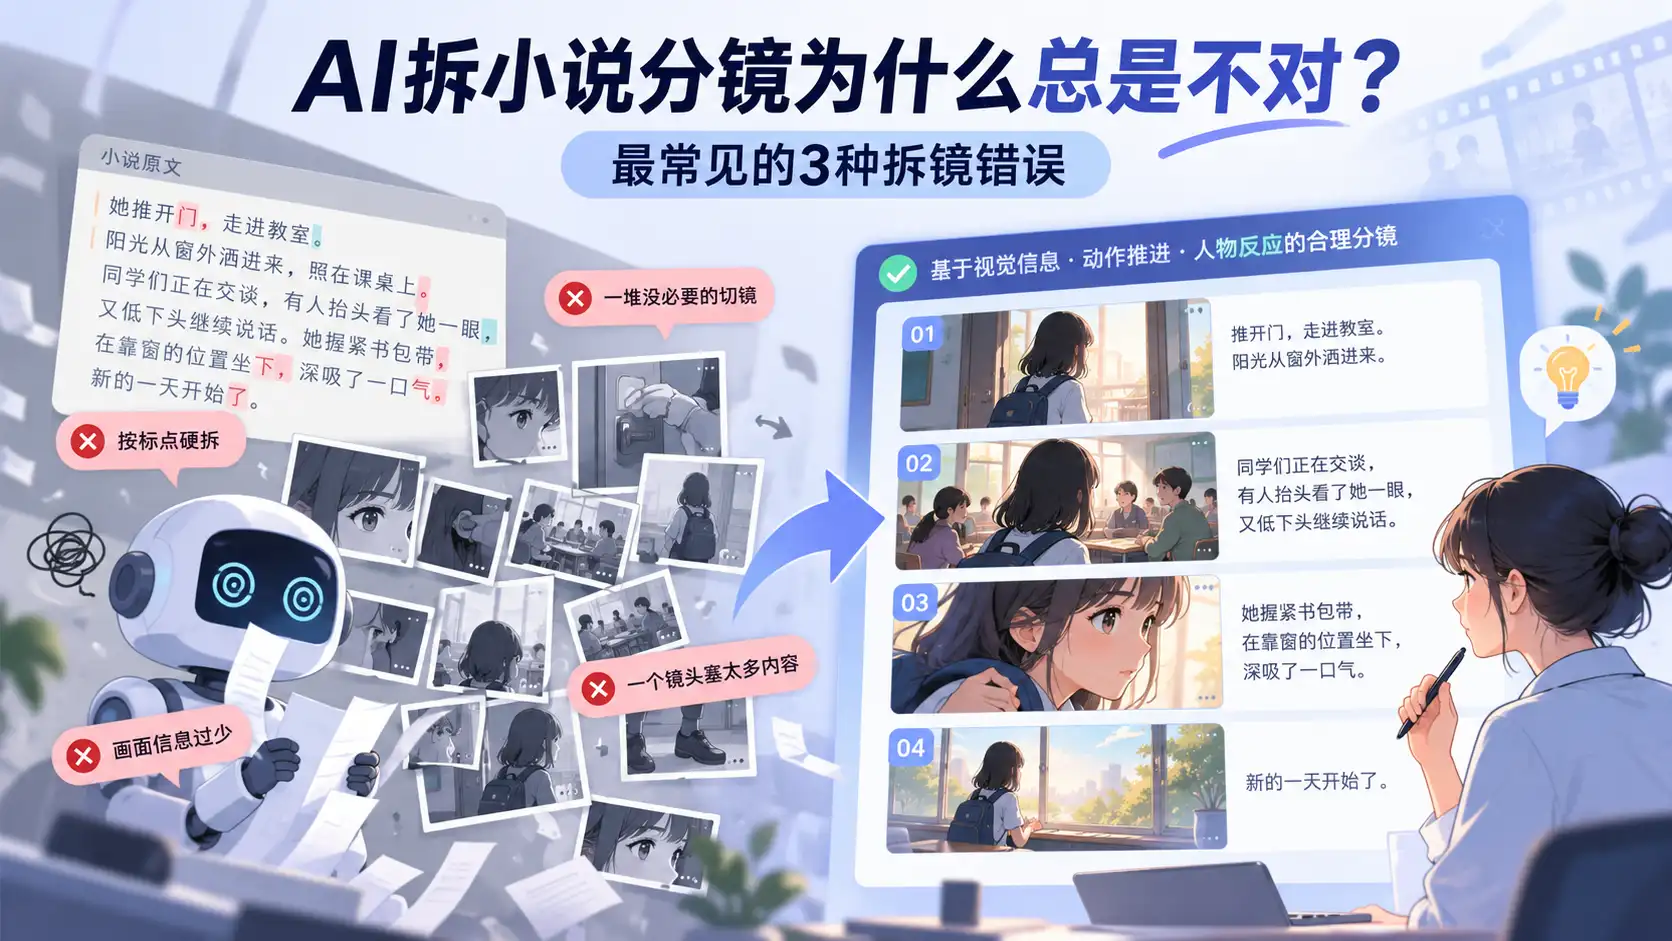
拿一段小说让 AI 生成分镜,现在已经不算难。难的是生成出来以后,你经常会发现一种情况:
镜头数量看起来不少,格式也很完整,但真正拿去画图、做视频时,就是觉得哪里不对。
有些地方本来应该切镜,却全部挤在一个镜头里。
有些地方只是人物说了一句话,AI 又拆成了三四个镜头。
还有一种最常见:
小说有几句话,AI 就拆几个镜头。
表面看像是在“拆分镜”,实际上只是把文本切开了。
而小说转分镜真正要解决的,并不是一句话应该对应几个镜头,而是:
观众接下来需要看到什么。
如果你刚开始接触漫剧分镜,可以先看《漫剧分镜脚本是什么?完整结构解析》,先了解一个真正可制作的分镜脚本通常包含哪些信息。
下面直接看 AI 拆小说分镜时最常见的 3 种错误。
错误一:把句号当成切镜点
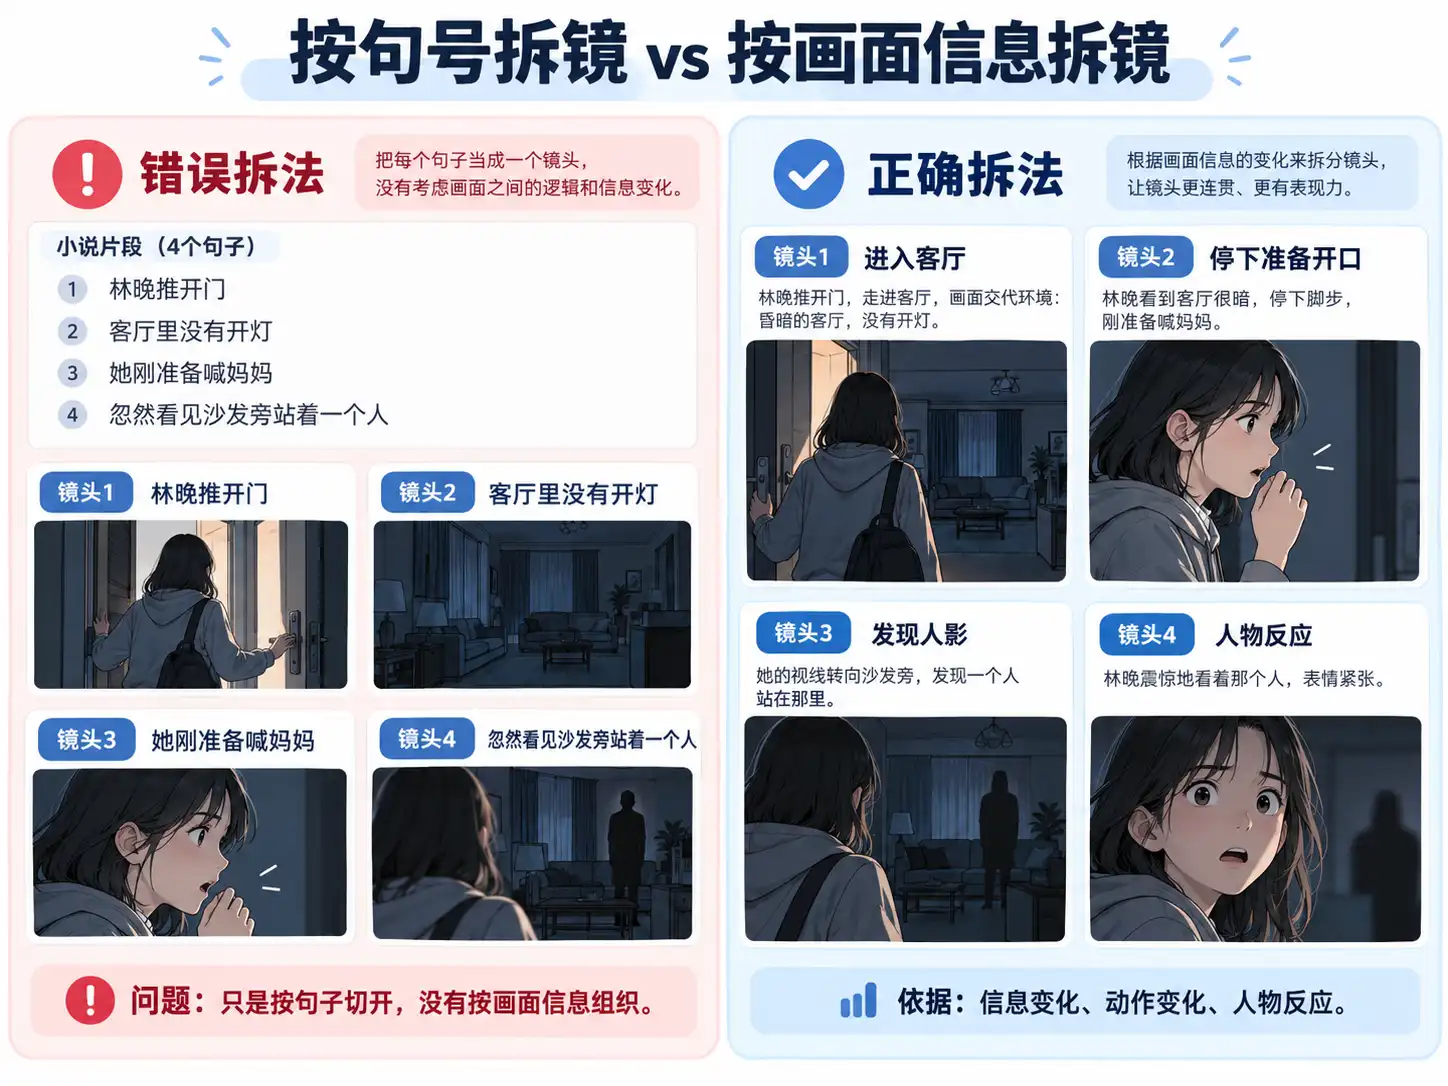
先看一个很简单的小说片段:
林晚推开门。
客厅里没有开灯。
她刚准备喊妈妈,忽然看见沙发旁站着一个人。
如果机械按照句号拆,可能变成:
镜头 1:林晚推开门。
镜头 2:客厅里没有开灯。
镜头 3:林晚准备喊妈妈。
镜头 4:林晚看见沙发旁站着一个人。
这样不能说完全错误,但问题在于:切镜依据只是文字断句,而不是画面需要。比如前两句其实完全可能属于同一个镜头:门被推开,镜头跟着林晚进入昏暗的客厅。这里既交代了人物动作,也交代了环境。真正值得切镜的地方,反而可能是最后一句。因为“沙发旁站着一个人”出现了新的关键信息。这时候可以切成:
镜头 1:林晚推开门进入昏暗的客厅。
镜头 2:林晚停下,刚准备开口。
镜头 3:切她的视线方向,沙发旁站着一个模糊的人影。
镜头 4:切回林晚的反应。
你会发现,同样一段小说,真正决定切镜的不是标点,而是:信息发生了什么变化:
人物有没有进入新的空间。
有没有出现新的动作。
有没有新的视觉信息。
有没有重要反应需要让观众看到。
这些才是切镜依据。所以小说转分镜时,第一个需要摆脱的就是:
一句话 = 一个镜头。
它们之间根本不是一一对应关系。
错误二:一个镜头里塞了太多事情
和“拆太碎”相反,AI 还有一种很常见的问题:舍不得切。比如小说里有这样一段:
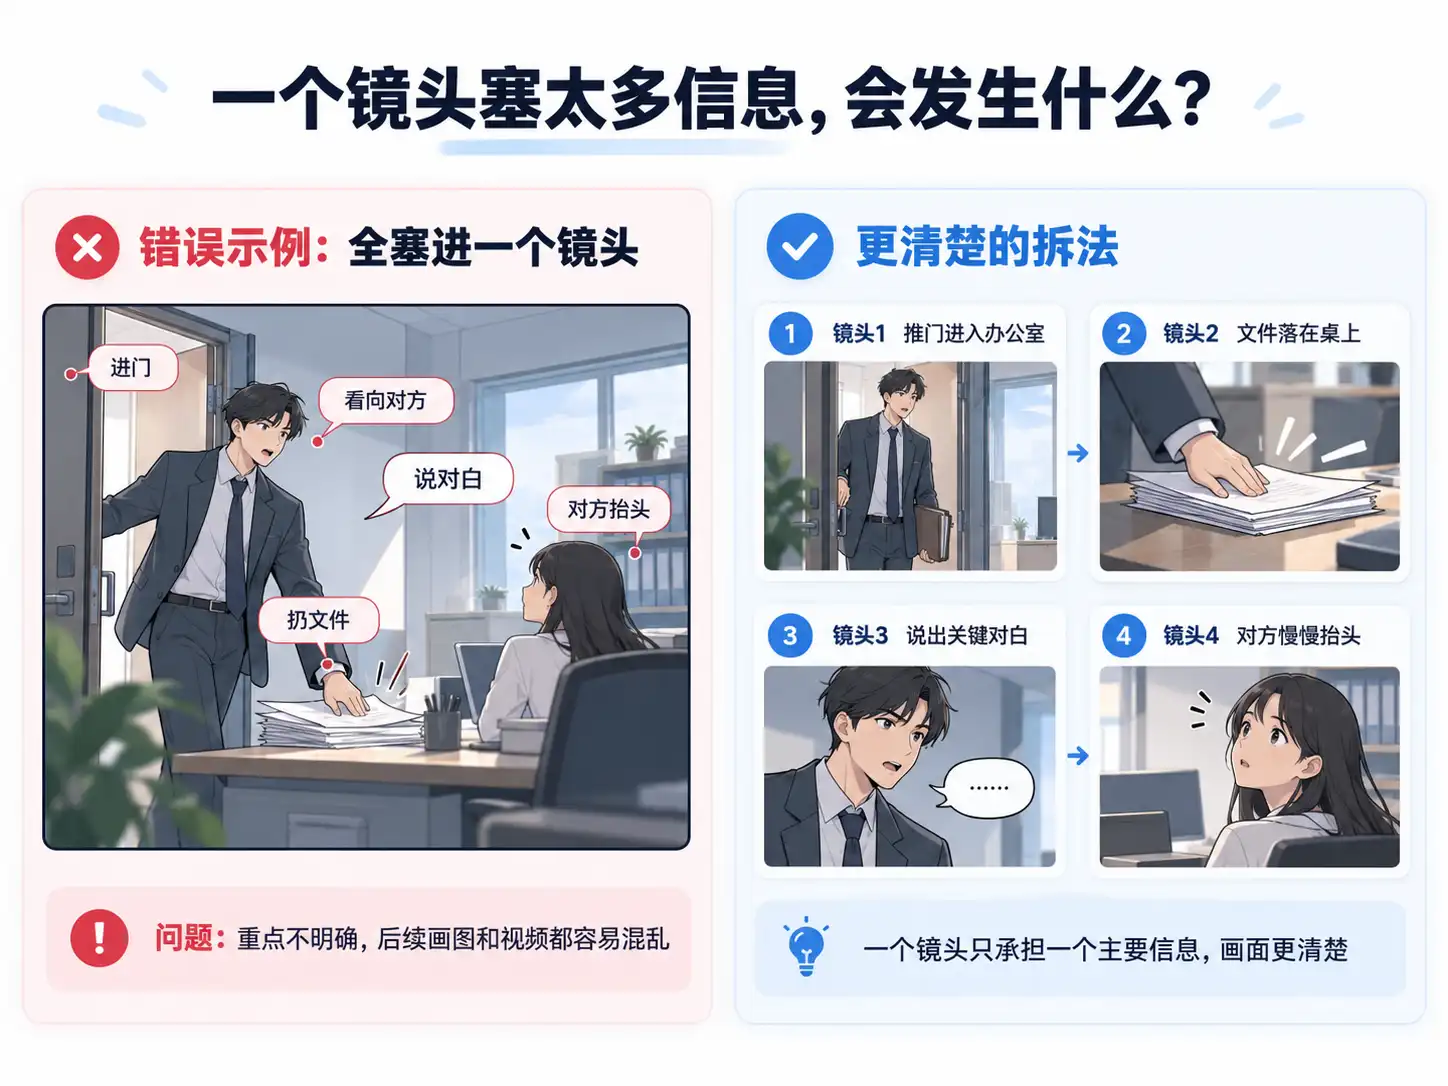
周野走进办公室,把文件扔到桌上,看了一眼坐在窗边的陈宁,冷冷地说:“这就是你给我的结果?”陈宁没有回答,只是慢慢抬起头。
如果整个内容只拆成一个镜头:
周野进入办公室,把文件扔到桌上,与陈宁对话,陈宁抬头看向他。
文本上好像全写到了。但真正制作时问题很大。一个镜头同时承担了:
进入空间。
扔文件。
建立两个人的位置。
对白。
陈宁的反应。
五件事情全部发生在一起。结果通常就是:
画面重点不明确。
如果拿去 AI 画图,只能画出其中某一个瞬间。如果拿去生成视频,又容易让短短几秒钟里塞进太多动作。更合理的拆法可能是:
镜头 1:周野推门进入办公室。
镜头 2:文件被重重扔到桌上。
镜头 3:周野看向窗边的陈宁,说出那句话。
镜头 4:陈宁沉默片刻,慢慢抬头。
这里并不是为了增加镜头数量。而是因为每个镜头承担的信息变得清楚了。你可以把它理解成一个简单判断:如果一个镜头里同时有多个重要动作、重要信息或者重要反应,就应该考虑是不是需要拆开。尤其是人物反应。小说里一句:
她愣住了。
可能只有四个字。但在视频里,这四个字有时候反而值得单独一个镜头。因为观众需要看到这个反应。这也是小说转影视语言时非常重要的变化:文字篇幅不等于镜头重要程度。
一大段环境描写可能只需要一个镜头。一句人物反应,反而可能需要一个特写。如果你想看一段小说实际能拆出多少镜头,可以继续看《500字小说片段可拆多少分镜?完整案例解析》。
错误三:没有新信息,也一直切镜
第三种错误恰好又走到了另一个极端:为了让分镜看起来丰富,不停切。比如两个人坐在咖啡厅聊天:
A 说一句。
切 A。
B 回一句。
切 B。
A 再说一句。
继续切 A。
服务员经过。
切服务员。
杯子放下。
切杯子。
人物点头。
再切一个特写。
结果 20 秒内容拆了十几个镜头。形式上很像分镜。但真正做成视频以后,会特别碎。判断一个镜头该不该切,其实可以问一个问题:切过去以后,观众获得了什么新的东西?
如果没有新的信息,没有新的情绪,没有新的空间关系,也没有需要强调的动作,那么这个切镜可能就没有必要。比如:
A 一直在解释一件事情。如果他的情绪、动作和画面关系都没有明显变化,完全可以让一个镜头保持几秒。直到:
B 的表情发生变化。
桌下有人悄悄握紧拳头。
门外突然出现一个人。
A 说到真正关键的一句话。
这时候再切,镜头才有意义。所以分镜不是:镜头越多越专业。而是:每一次切镜最好都有理由。这和镜头数量本身也是同一个问题。如果你经常纠结一段内容到底应该拆多少镜头,可以继续看《漫剧分镜一般多少个镜头?》。
那什么情况下应该切镜?
不需要记非常复杂的理论。做小说转分镜时,可以先检查下面几种变化。
空间发生变化
人物从卧室来到客厅。
从室内走到室外。
从现实进入回忆。
通常需要重新建立画面。
关键动作发生变化
坐着变成站起来。
走路变成突然停下。
手里原本没有东西,接下来拿出了重要道具。
如果动作本身承载剧情信息,就值得单独处理。
新的重要信息出现
门后站着一个人。
手机上出现一条关键消息。
桌上多了一张照片。
镜头需要让观众真正看到这些信息。
人物反应值得被看见
惊讶。
迟疑。
愤怒。
突然意识到什么。
小说可以一句带过,视频往往需要把它变成画面。
观看重点发生变化
前一秒我们需要看整个房间。
下一秒需要看人物手里的钥匙。
即使人物和地点都没变,观看重点变了,也可能需要换镜头。
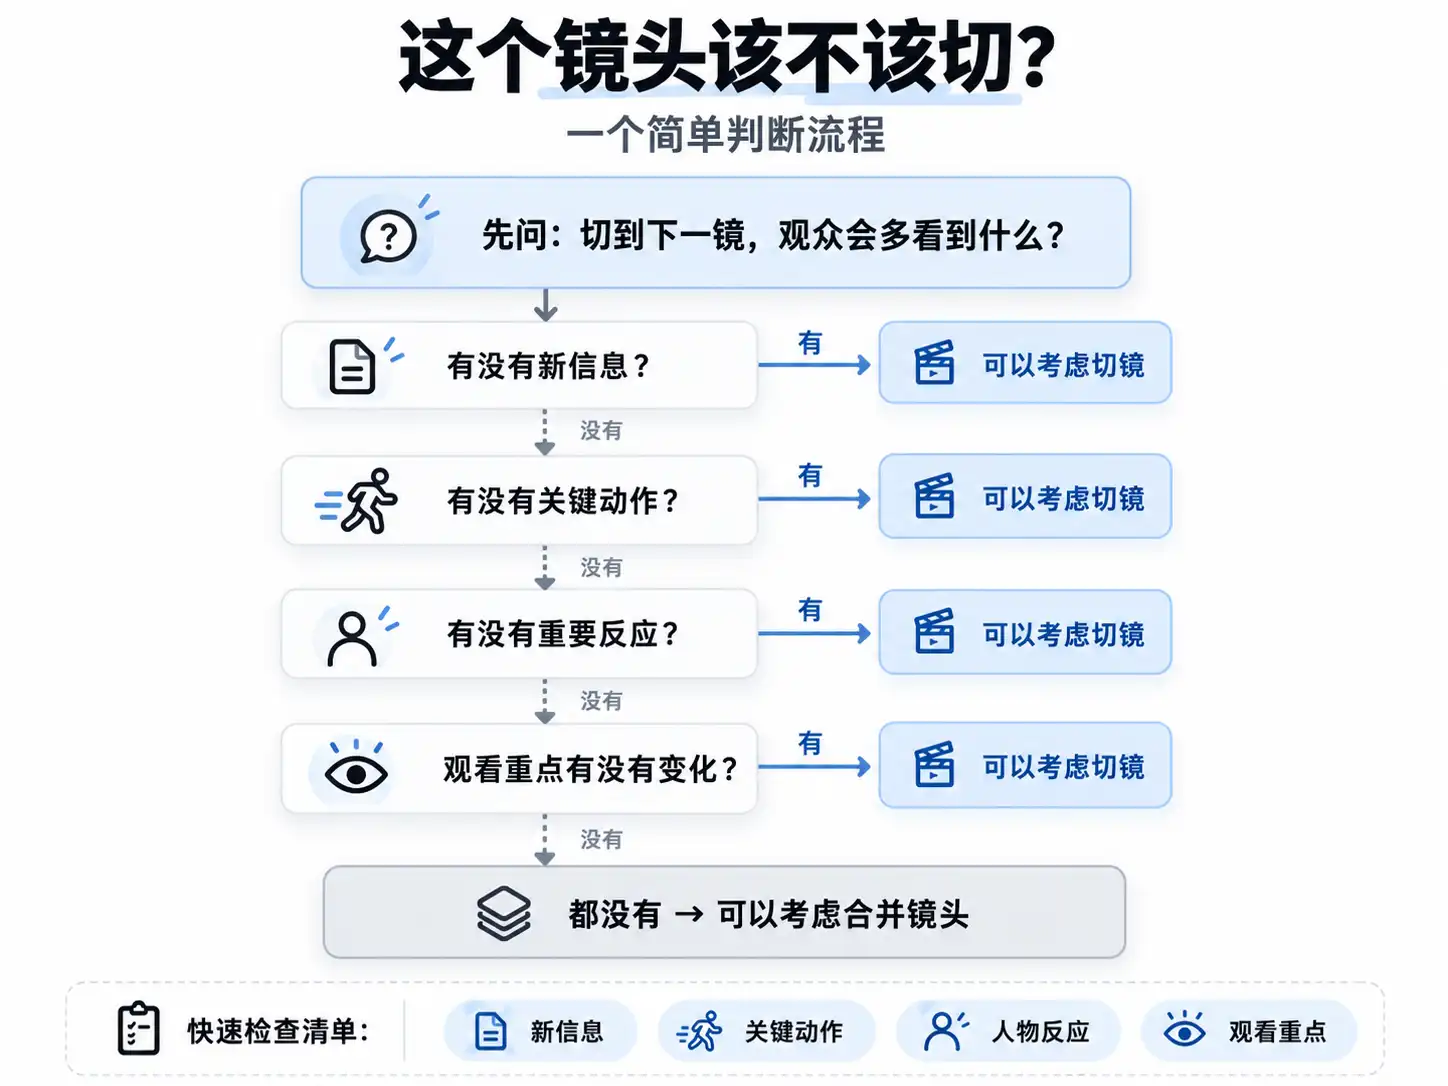
一个简单判断:删掉这个镜头,会不会少掉什么?
这是我觉得非常实用的一个办法。当你不确定某一镜是不是拆得太碎,可以直接问:
如果删掉这一镜,观众会少知道什么吗?
如果答案是:什么都没少。剧情一样能看懂。情绪也没变化。空间也没有需要重新说明。那这个镜头很可能就是多余的。反过来,如果合并两个镜头以后:
某个重要动作看不清了。
人物反应没了。
空间关系看不懂了。
或者后面的剧情突然显得很跳。
那就说明它们可能本来就应该分开。
这个判断方式比“每多少字拆一镜”更可靠。
AI 拆分镜真正应该做的,不是文本切割
所以回到最开始的问题。为什么很多 AI 生成的小说分镜,看起来格式完整,真正用起来却不顺?因为有些生成逻辑本质上做的还是:文本分段。
而真正的分镜拆解,需要先理解:
这里发生了什么。
人物在哪里。
人物做了什么。
什么信息必须让观众看到。
什么反应值得停下来表现。
空间和观看重点什么时候发生变化。
然后才决定:这里是不是应该形成一个新的镜头。
这也是为什么同样 500 字小说,不可能永远对应固定数量的镜头。500 字对白和 500 字追逐戏,需要的镜头数量可能完全不同。同样一段文字,不同节奏、不同表现重点,也可以产生完全不同的分镜方案。
AI 拆完以后,最好还是检查一遍这 3 件事
拿到 AI 分镜以后,不需要每一镜重新做。只需要快速检查:
第一,有没有明显按照句子机械切开的地方。
第二,有没有一个镜头同时塞了太多动作和信息。
第三,有没有连续几个镜头其实没有提供任何新信息。
把这三类问题修掉以后,整个分镜通常就会顺很多。如果你想进一步了解从小说原文到完整分镜脚本的整个过程,可以继续看《小说拆解漫剧分镜的完整工作流:从原文到分镜脚本怎么做》。
最后
小说转分镜最容易犯的错误,其实不是镜头“少一个”或者“多一个”。而是把:文字结构,当成了镜头结构。文字按照句子和段落组织。镜头按照画面、动作、空间、信息和情绪组织。两者有关,但绝对不是简单对应。所以真正好用的 AI 分镜,也不应该只是:把小说切成很多行。而应该先理解故事,再决定:观众什么时候应该继续看这一镜,什么时候应该切到下一镜。