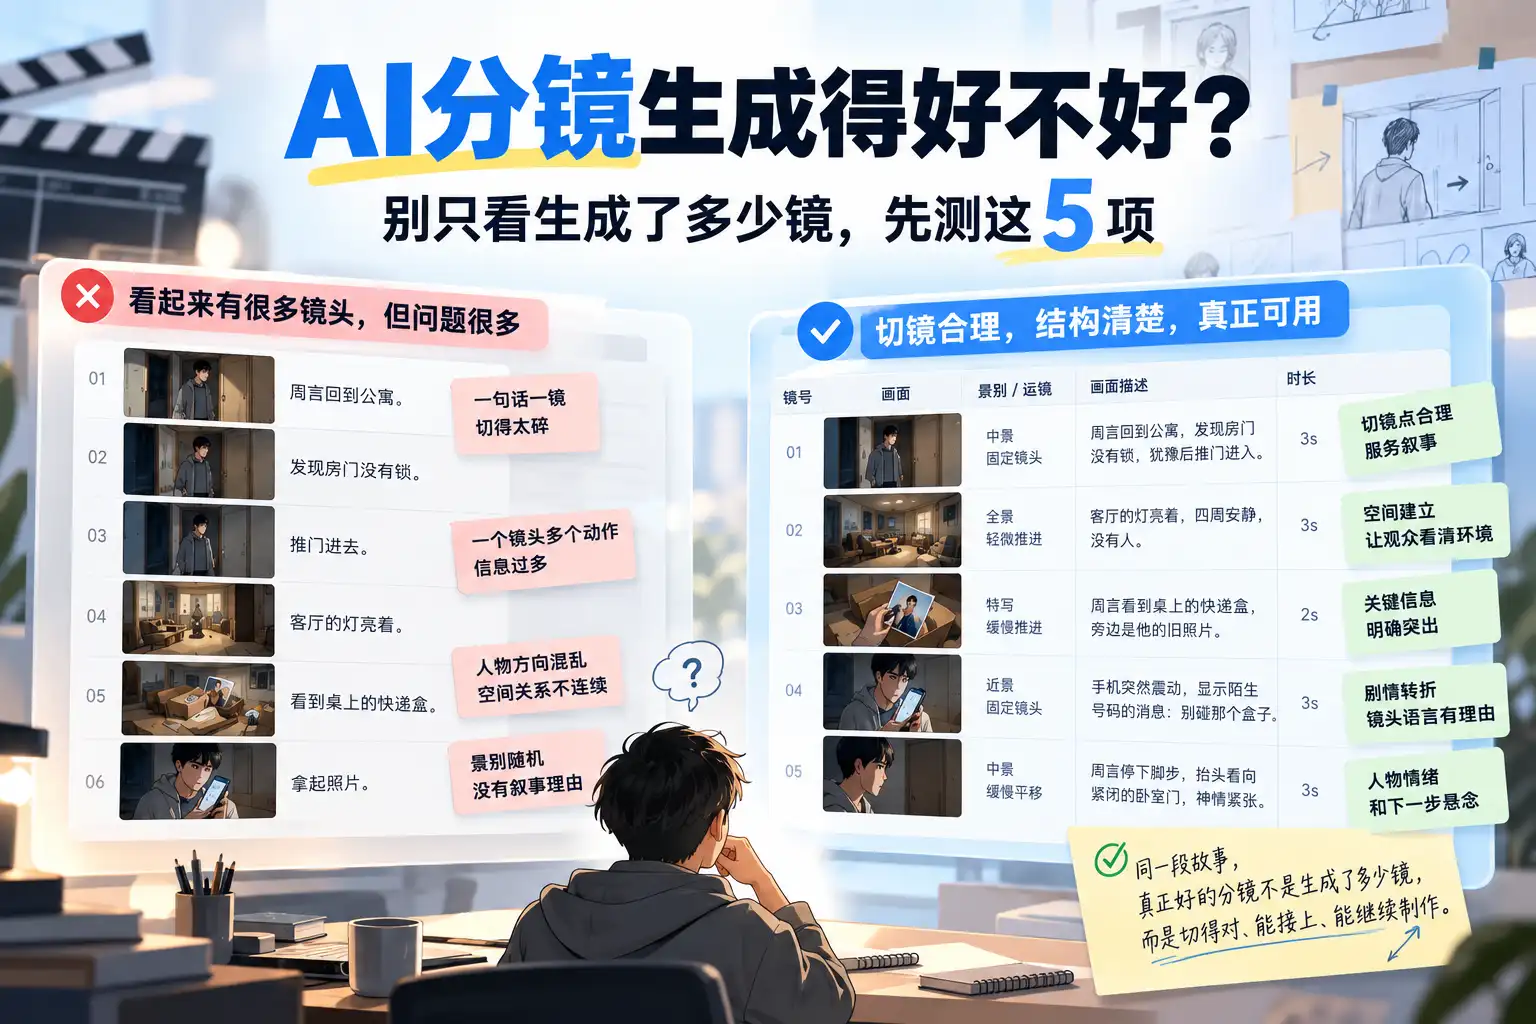
现在能自动生成分镜的 AI 工具越来越多。输入一段小说、剧本或者故事,几秒钟以后就能得到十几甚至几十个镜头,看起来已经把最麻烦的工作完成了。但真正把这些镜头拿去画图、生成视频或者继续修改时,差距很快就会出现。
有些分镜只是“生成了很多行内容”:一句话拆一镜,景别随机变化,人物前后位置对不上,一个镜头里还可能同时塞进好几个动作。也有一些结果,镜头数量并不夸张,但你能很快看懂这一镜拍什么、下一镜为什么要切、人物在哪里,以及后面应该怎么继续制作。
所以判断一个 AI 分镜脚本生成器好不好,不能只看它“能不能生成分镜”。更实际的测试方法是:拿同一段真实故事,让它完整生成一次,再检查这份结果到底有多少镜头真正可以直接留下。例如我们可以测试这样一段故事:
“深夜,周言回到公寓,发现房门没有锁。他推门进去,客厅的灯亮着,却没有人。桌上放着一个已经拆开的快递盒,旁边是他的旧照片。周言刚准备走过去,手机突然震动。陌生号码发来一条消息:别碰那个盒子。他停下脚步。下一秒,盒子里面传来轻微的震动声。周言慢慢抬头,看向紧闭的卧室门。”
这段内容不复杂,却同时包含了人物进入、空间建立、重要道具、信息揭示、人物反应和新的悬念,非常适合检查 AI 到底是在“按文字拆行”,还是已经开始理解镜头。
第一项:它把镜头切在了哪里
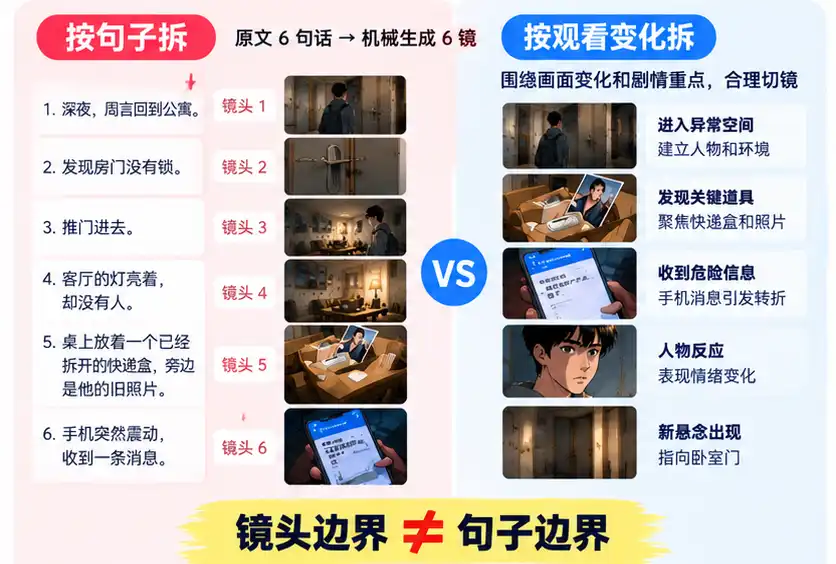
先不要看生成了多少镜,先看它在哪里切。最机械的 AI 拆法,很可能变成:
周言回到公寓一镜,发现房门没锁一镜,推门一镜,客厅亮灯一镜,看见快递盒一镜,看见旧照片一镜,手机震动一镜,收到短信一镜……
最后可能得到十几镜,但其中很多切换只是因为原文出现了新的句子或动作。真正合理的切镜,更应该跟随观众的观看任务。
比如“周言回到公寓,发现房门没有锁”,完全可以先用一个镜头建立人物和异常状态;当他进入客厅,需要重新看到空间时,再进入下一镜;当桌上的快递盒成为新的关键信息时,再考虑把注意力转过去。
真正值得切镜的,通常不是句号,而是人物主体、动作阶段、关键信息、空间关系或者情绪状态发生了变化。所以测试任何 AI 分镜工具时,可以先做一个很简单的检查:
把原文句号全部忽略,只看这些切镜点本身是否仍然成立。
如果把文字标点拿掉以后,大量镜头就失去了切换理由,这份分镜很可能还停留在“按文本拆分”,而不是“按画面拆分”。关于这个问题,可以继续看《一段文字什么时候该切镜?判断分镜切点的5个信号》。
第二项:每一镜到底想让观众看什么
切镜位置基本合理以后,第二步不是检查景别,而是看每一个镜头有没有清楚的任务。比如 AI 生成这样一条:
“周言推门进入客厅,看见桌上的快递盒,走过去拿起照片,手机突然响起,他低头看手机,看到短信后愣住。”
信息看起来很完整,但这其实是一条非常难执行的镜头。人物要进入空间、发现物品、改变位置、拿道具、处理手机、阅读信息,还要完成情绪变化。无论后面是真人拍摄还是 AI 视频生成,都同时存在太多任务。但另一个极端同样不好:
“周言推门。”
“周言迈步。”
“周言抬头。”
“周言看桌子。”
“周言走向桌子。”
镜头数量增加了,故事信息却几乎没有增加。所以判断单镜头好不好,不能简单数动作数量,而应该问:这一镜最主要希望观众注意什么?
如果答案是“周言第一次发现那个异常快递盒”,那么走进房间可以只是这个镜头中的连续动作,但快递盒应该成为真正的视觉重点。如果后面的短信改变了剧情方向,短信就应该承担新的镜头任务。一个镜头可以包含几个连续动作,但最好不要同时存在几个互相争夺注意力的核心信息。关于这部分,可以继续看《分镜画面描述怎么写?一个镜头里到底应该写多少动作和信息》。
第三项:人物、场景和空间关系有没有突然改变
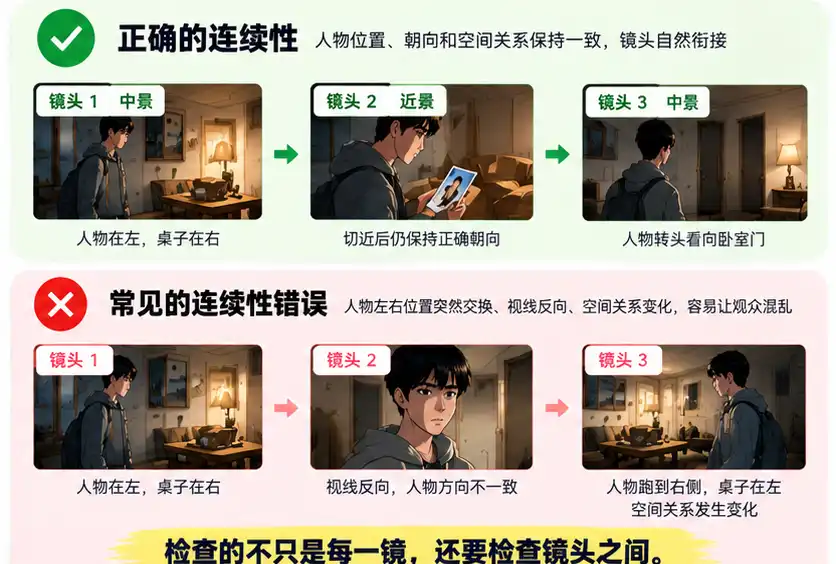
很多 AI 分镜第一眼看起来没有问题,但连续往下读几镜,就会发现人物已经悄悄“换位置”了。
比如前一镜周言站在客厅门口,桌子在他的右侧。下一镜突然变成桌子出现在左边,再下一镜人物面对卧室,之后又莫名其妙背对卧室。
单看每一镜都能成立,但连续起来以后,空间已经乱了。两个人对话时这个问题会更明显。前一镜 A 在左、B 在右,下一镜切近景以后两个人的视线方向突然一样,再下一镜又交换左右位置,观众会开始失去方向感。
好的分镜不只是每一格“看起来像电影”,还应该让上一镜和下一镜存在明确关系。测试的时候可以特别看三个地方:人物在空间里的相对位置有没有保持,人物朝向和视线有没有理由地发生变化,以及摄影机换位置以后有没有造成明显的方向反转。
如果是一段连续场景,却需要你不断脑补“人物为什么突然到了这里”,那这份分镜离真正可执行还有距离。这也是 AI 分镜非常容易被忽略的一点:单镜正确,不等于整段正确。
一份真正可用的分镜,必须同时理解镜头和镜头之间的关系。
第四项:景别和运镜是在讲故事,还是随机增加“电影感”
很多 AI 很喜欢给分镜增加变化。远景、中景、近景、特写不断轮换,再配上推进、横移、环绕、手持,好像镜头语言越丰富,结果就越专业。但真正有用的镜头语言应该有理由。还是刚才的例子。
周言第一次进入公寓时,需要让观众理解空间,一个相对宽的镜头就有意义;快递盒和旧照片第一次出现时,如果它们是剧情关键信息,就值得让观众看清楚;短信出现以后,重点从道具转到信息,再转到人物反应,景别自然也会跟着发生变化。
但如果 AI 在没有任何叙事变化的时候突然从中景切特写,再突然给一个环绕镜头,只是因为“这样比较丰富”,反而会增加噪音。所以测试 AI 分镜时,可以把所有“远景、中景、特写、推进、摇镜、环绕”暂时遮掉,只看:这个镜头为什么必须这样拍?
如果找不到理由,这个参数很可能只是装饰。分镜不是镜头术语越多越专业,而是每一次镜头变化都能帮助观众更清楚地接收故事。
第五项:生成之后,能不能继续进入制作
这是我认为最容易被“生成成功”掩盖的一项。很多 AI 可以输出:
“镜头1:男人进入房间。”
“镜头2:男人看到桌上的盒子。”
“镜头3:手机响起。”
从“有没有分镜”来看,它已经完成任务。但真正开始制作以后,你还需要继续解决很多问题:这个男人是谁?在哪个场景?人物现在站在哪里?这一镜是什么景别?持续多久?需要什么道具?人物是什么状态?画面重点是什么?如果下一步要生成图片或者视频,应该引用哪些角色和场景资料?
所以一份更有用的 AI 分镜,不应该只是一列“镜头内容”。它至少应该能够继续整理人物、场景、道具、画面描述、景别、运镜、时长、台词、旁白以及后续生成需要的信息。这里真正要看的不是“字段越多越好”。
而是生成器有没有把原本散落在故事里的信息,逐渐整理成后面可以继续使用的制作结构。这也是为什么,测试 AI 分镜工具时不要只看第一次生成的页面好不好看。可以继续往后走一步:选其中三四个镜头,看看你准备生图、生成视频或者修改人物时,还需要重新从小说里找多少资料。如果每到下一步都要重新阅读原文、重新说明人物、重新解释场景,那么前面的“自动生成分镜”其实只完成了很浅的一层。
真正测试一次,比看功能列表更有用
如果你正在比较不同的 AI 分镜脚本生成器,可以准备一段 200~300 字左右的故事,尽量同时包含人物、空间变化、一个重要道具、一处信息揭示和一次情绪变化。不要特意把原文写成适合 AI 的格式,也不要提前告诉它应该拆几镜。直接生成,然后依次检查五件事:
镜头是不是切在真正发生变化的位置;
每一镜有没有清楚的观看任务;
人物和空间关系能不能连续;
景别和运镜有没有叙事理由;
生成以后能不能继续进入后续制作。
最后再看一个很现实的指标:你需要手动重写多少镜。
如果生成了 20 个镜头,其中 15 个都需要重新拆、重新写或者重新调整关系,那么“20 秒生成一份分镜”并没有真的节省多少时间。反过来,如果第一版并不完美,但大部分镜头的结构已经成立,你主要是在调整表达和少量参数,这才是真正有价值的自动分镜。
AI 分镜的意义,从来不是替你快速填满一张表。而是尽可能把故事第一次转成镜头时,就建立一个可以继续修改、继续生成、继续制作的结构。
最后:不要问它能不能生成分镜,先问生成的分镜能不能留下来
现在“自动生成分镜”已经不是一个特别稀缺的能力。真正拉开差距的,是第一次生成以后到底有多少内容可以留下。镜头切在哪里,每一镜承担什么任务,人物和空间能不能接起来,镜头语言是不是有理由,以及这些结果能不能继续进入实际制作,这五件事比“生成了多少镜”更值得看。
所以以后看到一个 AI 分镜脚本生成器,不妨少看一点产品演示,多拿一段自己的真实故事试一次。因为真正好用的分镜生成器,不应该只是让你更快得到一张分镜表。它应该让你离下一步制作更近。