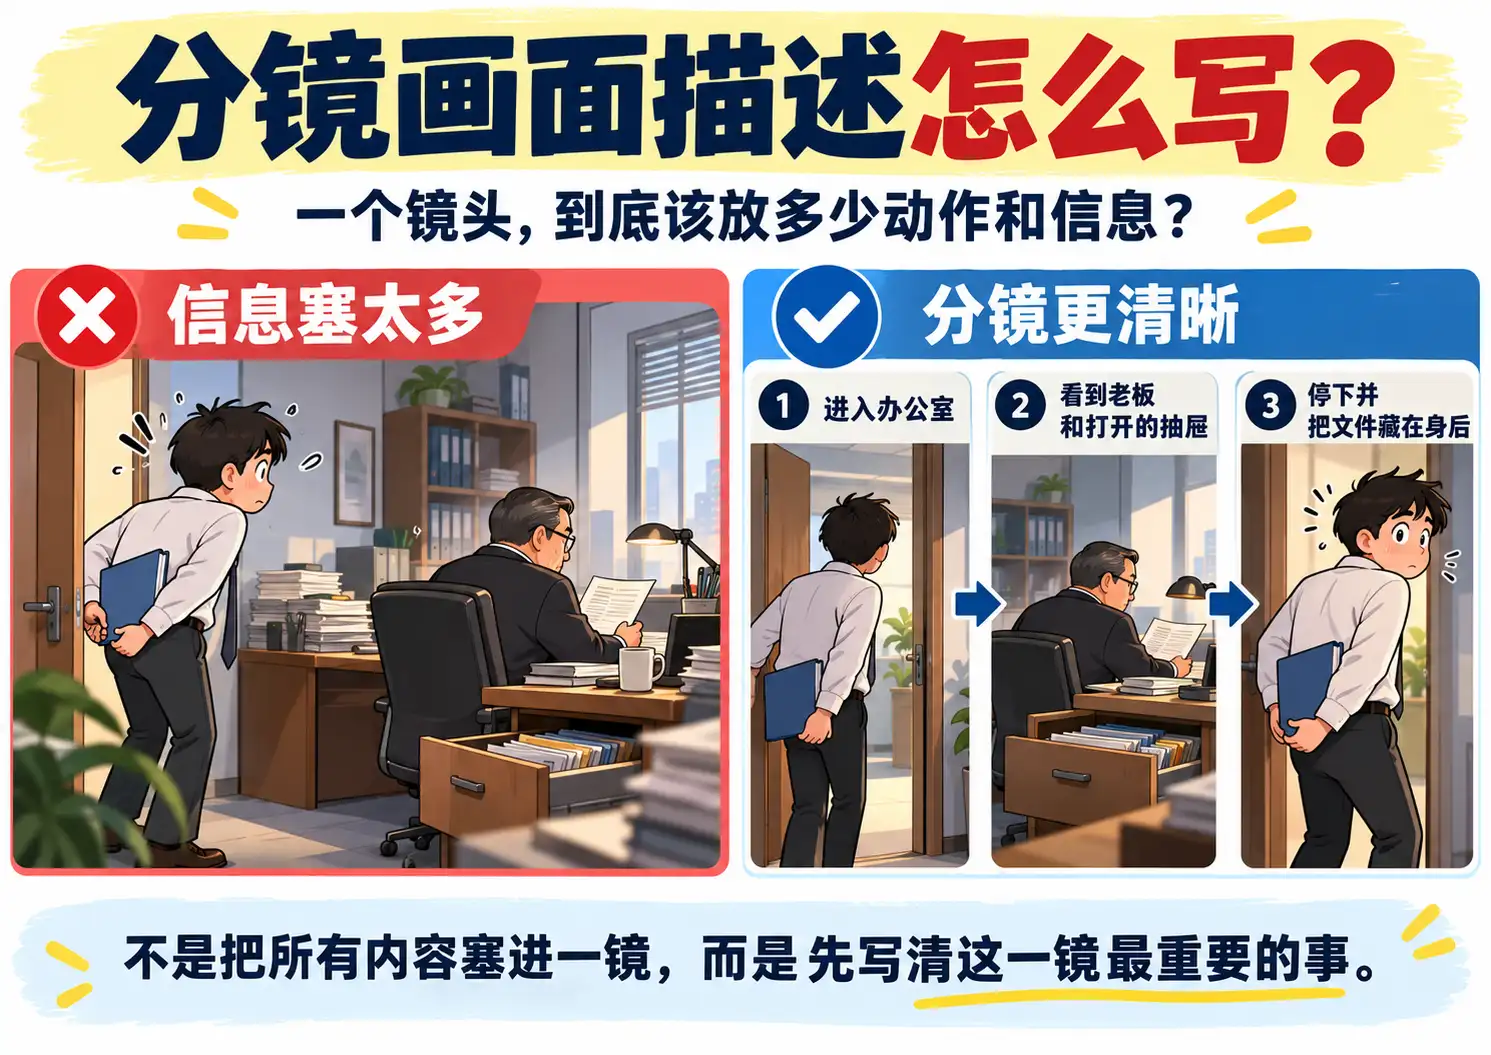
很多人第一次写分镜脚本时,会觉得画面描述写得越详细越好。人物走进房间、关门、回头、看见桌边的人、停下脚步、掏出手机、说了一句话,全部写在一个镜头里,看起来好像很完整。
但真正进入画图、视频生成或者剪辑以后,很快就会发现这种镜头其实很难用。因为一个镜头里同时发生的事情太多,你已经很难回答一个最基本的问题:这一镜到底主要想让观众看什么?
反过来,另一种常见问题是拆得太碎。人物抬头一镜,伸手一镜,拿起杯子一镜,喝水又一镜。每个动作都被单独拆开,结果镜头数量越来越多,但并没有增加多少真正有价值的信息。
所以分镜画面描述真正要解决的,并不是“写得够不够详细”,而是把当前镜头的任务写清楚。
一个比较好用的判断方式是:看完这一镜的描述以后,应该能够很快回答四个问题——这一镜主要看谁,人物正在做什么,人物处于什么空间关系里,以及这一刻观众最应该注意什么。
如果这四件事都说不清楚,画面描述写得再长,也不一定是一条好分镜。
分镜画面描述不是小说复述
小说和分镜最大的区别,是小说可以同时告诉读者很多东西。比如小说写:
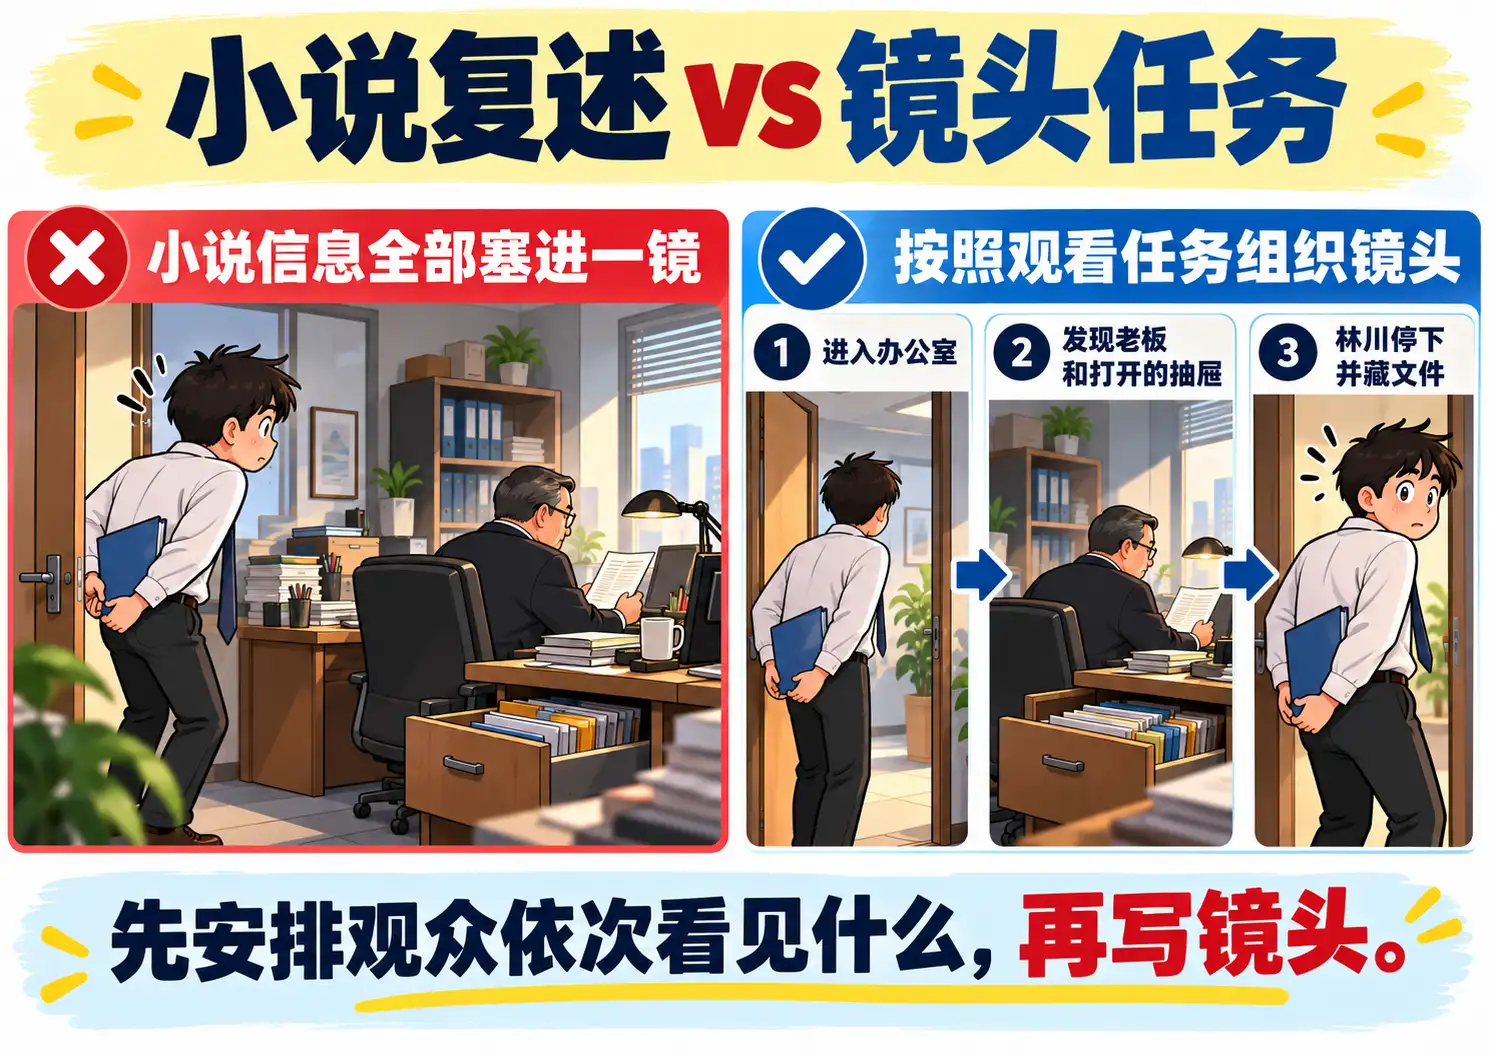
“林川走进办公室,看见老板坐在他的椅子上,桌上的抽屉已经被打开,他停下脚步,下意识把手里的文件藏到身后。”
文学上这完全可以是一句话,但如果原封不动放进一个分镜镜头里,问题就来了。这一镜到底要看林川走进来,还是看老板坐在椅子上?要不要让观众注意抽屉已经被打开?林川藏文件这个动作重要不重要?如果所有内容都同时发生,画面的视觉重点就会变得非常模糊。
真正进入分镜以后,可以先按观看任务重新整理。
第一镜可以先让林川进入办公室,同时建立空间;下一镜让观众看见老板和被打开的抽屉;再切回林川,看他停住脚步并把文件藏到身后。原文没有改变,但镜头已经从“复述一句小说”变成了“安排观众依次看见什么”。这也是画面描述最核心的变化:它不是重新讲一次故事,而是在规定这一镜到底要呈现哪一部分故事。
一个镜头最好先有一个主要任务
这里说的“一镜一个任务”,并不是要求每个镜头只能有一个动作。
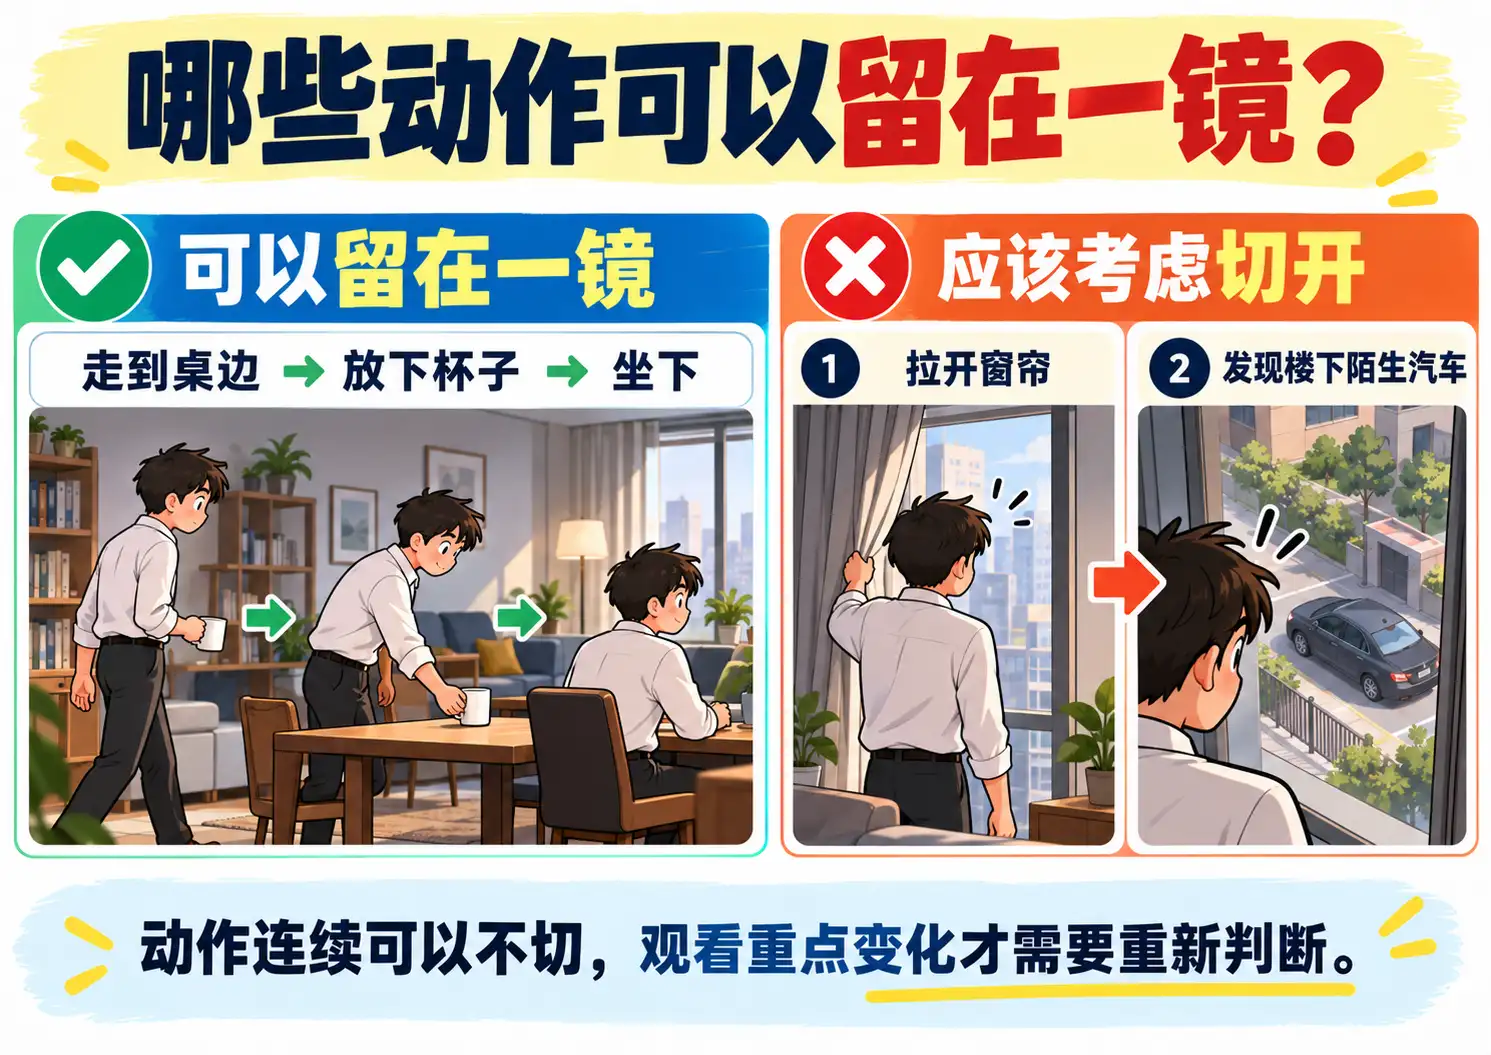
比如一个人物走到桌边,放下杯子,然后坐下。如果这几个动作都属于同一个连续行为,而且当前镜头能够清楚看见整个过程,就完全没有必要机械地拆成三镜。
真正要限制的不是动作数量,而是同时存在的“主要观看任务”。比如:
“林川走到窗边,拉开窗帘,看见楼下停着一辆陌生汽车。”
前两个动作“走到窗边、拉开窗帘”可以留在同一个镜头里,因为它们属于连续动作。但当窗帘拉开以后,“楼下那辆陌生汽车”开始成为新的关键信息,观众的观看重点已经变化了。这时候就应该考虑:是不是需要切到窗外,或者至少换一个更适合表现这辆车的镜头。所以一个镜头里能不能放多个动作,关键不在“几个”,而在这些动作是不是仍然服务同一个画面任务。
只要当前镜头还能清楚表达,动作之间又是连续的,就可以继续留在一起。反过来,只要新的信息开始抢走原来的视觉重点,即使只有一个很小的动作,也可能已经需要切镜。关于什么时候真正应该切到下一镜,可以继续看《一段文字什么时候该切镜?判断分镜切点的5个信号》。
画面描述到底应该写哪些信息
一条实用的画面描述,通常不需要把所有字段全部塞进去。景别、运镜、角色、场景本身就可以有独立字段,画面描述最重要的是把“这一镜正在发生什么”写清楚。比如:
“林川站在办公室门口,身体停住,视线落向桌后。老板坐在他的椅子上,身旁的抽屉已经打开。”
这句话已经能让人理解几个很关键的信息:林川的位置、他的状态、他正在看哪里,以及老板和抽屉之间的空间关系。如果这一镜重点是林川的反应,还可以进一步写成:
“林川停在办公室门口,视线落向桌后的老板,原本向前的身体突然僵住,握着文件的手慢慢收紧。”
这时画面任务就变成了人物反应。真正没必要做的是把不属于这一镜重点的所有信息全部堆进去,比如墙是什么颜色、窗外是什么天气、老板穿什么鞋、桌上有几份文件,除非这些信息确实会影响这一镜的表达。分镜描述的目标不是“尽可能完整”,而是“足够明确,而且没有无关信息干扰”。
一个镜头里动作太多,通常会出现什么问题
最明显的问题就是镜头的时间和任务开始冲突。比如:
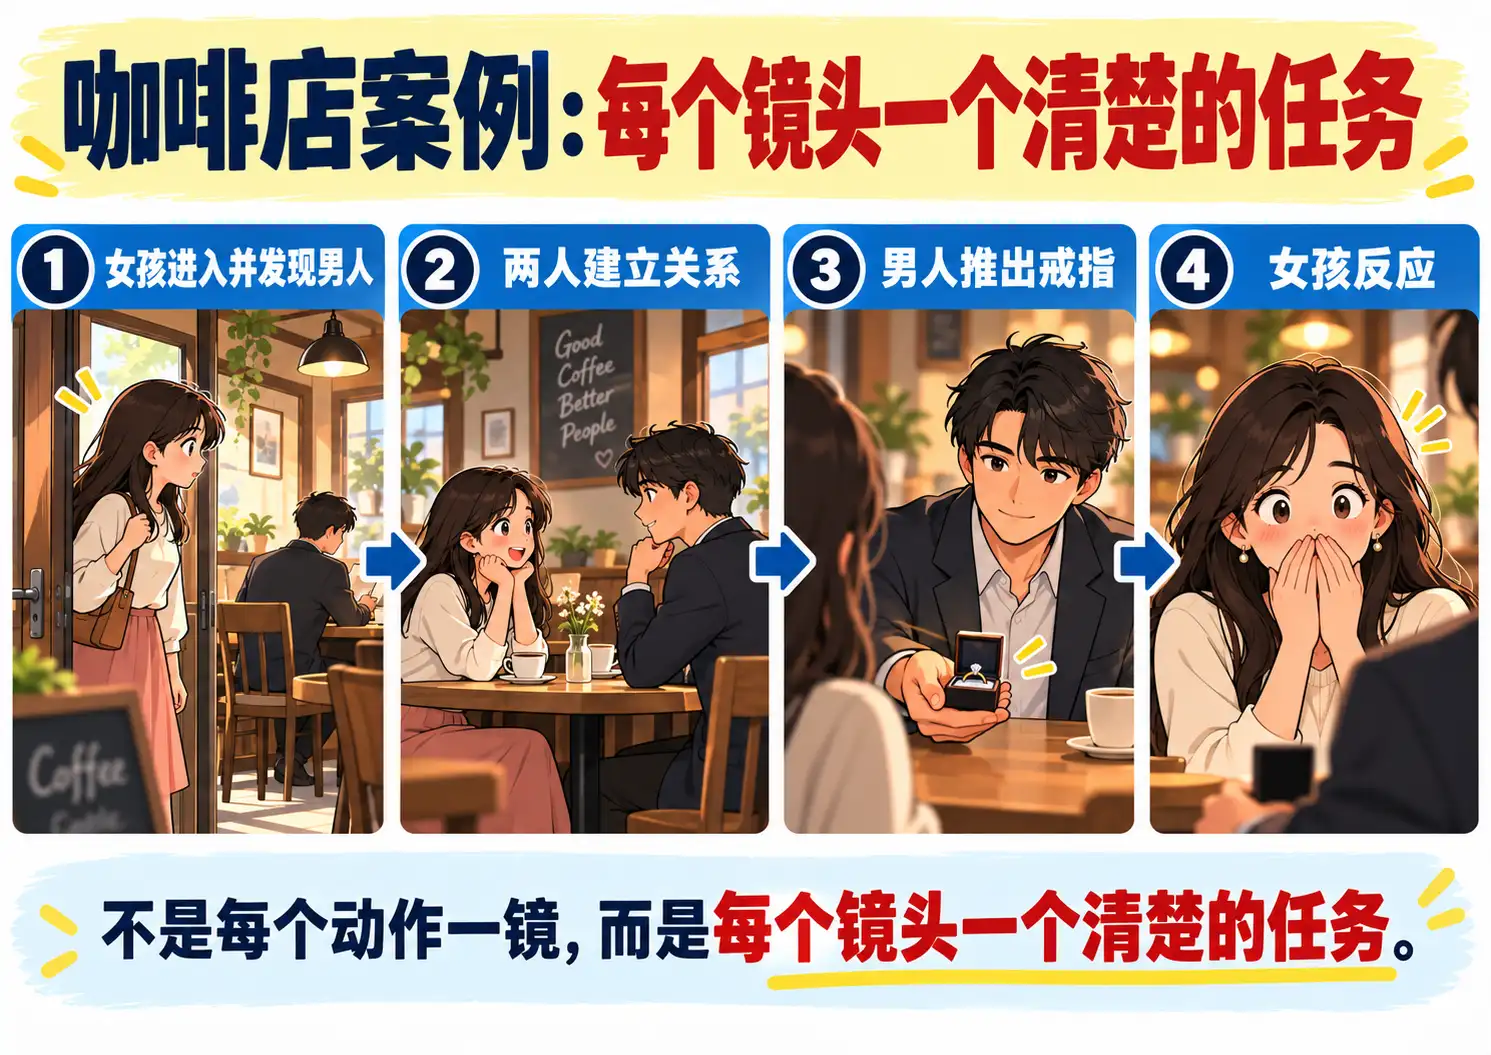
“女孩走进咖啡店,看见男人,走过去坐下,男人把戒指推到她面前,她愣住,然后拿起戒指。”
这句话放在小说里没有问题,但如果作为一个镜头,里面至少发生了进入空间、发现人物、靠近、坐下、道具出现、情绪反应、拿起道具几个不同阶段。
如果真的全部放进一个镜头,首先很可能需要很长时间,其次观众很难知道哪一步最重要。到了 AI 视频生成时,模型还要同时处理人物移动、空间变化、两人关系、道具动作和情绪变化,结果往往更不稳定。
更合理的方式不是简单地把每个动作都拆掉,而是按照任务分组。
比如先用一个镜头完成女孩进入咖啡店并发现男人;接下来用一个关系镜头让两个人进入同一个空间;男人把戒指推出来以后,再用一个更近的镜头强调戒指;最后切女孩的反应。
这样每一镜都没有特别复杂,但整段剧情反而更完整。
什么时候应该继续留在同一个镜头里
很多动作其实不值得单独切。例如人物从沙发起身,走到门口,把门关上。如果这一系列动作只是普通行为,没有出现新的剧情信息,一个能够完整看到动作过程的镜头通常就够了。
另一个典型情况是普通对话。A 说一句话,B 回一句话,并不意味着一定需要立刻正反打。如果两个人的关系、状态和画面重点都没有改变,一个双人镜头完全可以承载几句对白。
判断要不要继续留在当前镜头里,可以看三件事:当前镜头还能不能清楚看到接下来的动作;新的内容有没有改变观看重点;如果不切镜,观众会不会错过重要信息。
如果当前镜头仍然清楚,而且没有新的重点出现,就没有必要为了“镜头丰富”强行切换。
真正好的分镜不是不断制造变化,而是只在有必要的时候让镜头变化。
画面描述太短,同样会出问题
另一个极端是只写:
“林川震惊。”
或者:
“女孩很害怕。”
这种内容告诉了我们情绪,却没有告诉我们镜头里真正能看到什么。人物震惊,可以表现为动作停住、眼神固定、身体后退,也可以表现为手里的东西掉下来。人物害怕,可以表现为视线躲闪、身体贴墙、手抓紧衣角,也可以只是完全不动。
所以真正可以执行的画面描述,最好把抽象状态转成可见信息。比如:
“林川停在原地,视线盯住桌上的照片,原本抬起的手慢慢放下。”
就比“林川震惊”更适合进入分镜。再比如:
“女孩后退半步,背部贴住墙面,视线始终没有离开门口。”
就比“女孩非常害怕”更容易转成画面。
画面描述最重要的原则之一,就是尽量写观众真正能够看到的东西。
AI 分镜为什么尤其需要控制单镜头信息量
真人拍摄时,一个复杂镜头还可以通过演员调度、摄影机运动和多次拍摄来解决。但进入 AI 视频以后,一个镜头里的任务越多,模型需要同时保持的变量也越多。
人物要移动,角色外观不能变;空间关系要保持;摄影机可能还要运动;手里可能有道具;人物还要完成一个情绪变化。如果这些事情同时发生在几秒钟里,生成稳定性自然会下降。
所以 AI 分镜并不是越详细越好,而是要把复杂剧情拆成模型更容易理解、同时又符合叙事需要的镜头单位。这也会直接影响后面的提示词。
一条镜头如果任务明确,提示词通常也会更清楚。人物是谁、发生什么动作、场景是什么、摄影机怎么拍,可以围绕一个重点组织。如果一镜里同时塞了五六个剧情节点,提示词最后往往也会变成一大段信息堆积。关于从分镜继续进入 AI 视频提示词,可以继续看《AI视频提示词如何设计?》。
一个实用的画面描述检查方法
写完每一镜以后,可以重新读一遍,然后问自己:这一镜最重要的动作是什么?如果删掉描述里的某一句,镜头核心任务会不会改变?里面是不是同时存在两个应该分别被强调的关键信息?当前镜头是否真的能够把这些动作在合理时间内完成?如果发现一句描述里连续出现“然后、接着、随后、又、突然、紧接着”,尤其应该重新检查。
这些连接词并不是不能用,但出现得太多,往往意味着一个镜头里已经塞进了太多不同阶段。例如:
“他走进房间,然后看到桌上的照片,随后拿起来,突然发现照片背后写着一个名字,接着回头看向门口。”
这很可能不是一镜。因为观众已经经历了进入空间、发现照片、拿起照片、发现新信息、产生反应几个不同的观看任务。真正应该做的是重新判断:哪些动作可以连续完成,哪些信息值得单独强调。
最后:画面描述的核心不是“写多少”,而是“这一镜到底要完成什么”
分镜画面描述没有固定字数,也没有规定一个镜头只能有几个动作。一个简单镜头可能只需要一句话,一个复杂的长镜头也可能需要更多描述。真正应该控制的,是一个镜头不要同时承担太多互相竞争的任务。
只要当前镜头还能清楚地表现人物、动作和空间,而且观众的观看重点没有发生变化,就可以继续。一旦新的主体、新的关键信息、新的动作阶段、空间变化或者明显的情绪转折出现,就应该重新判断是否需要进入下一镜。所以以后写分镜画面描述时,可以先不问:“这一镜是不是写得不够详细?”先问:
这一镜最重要的事情到底是什么?
只要这个答案足够明确,画面描述通常就不会写得太乱。