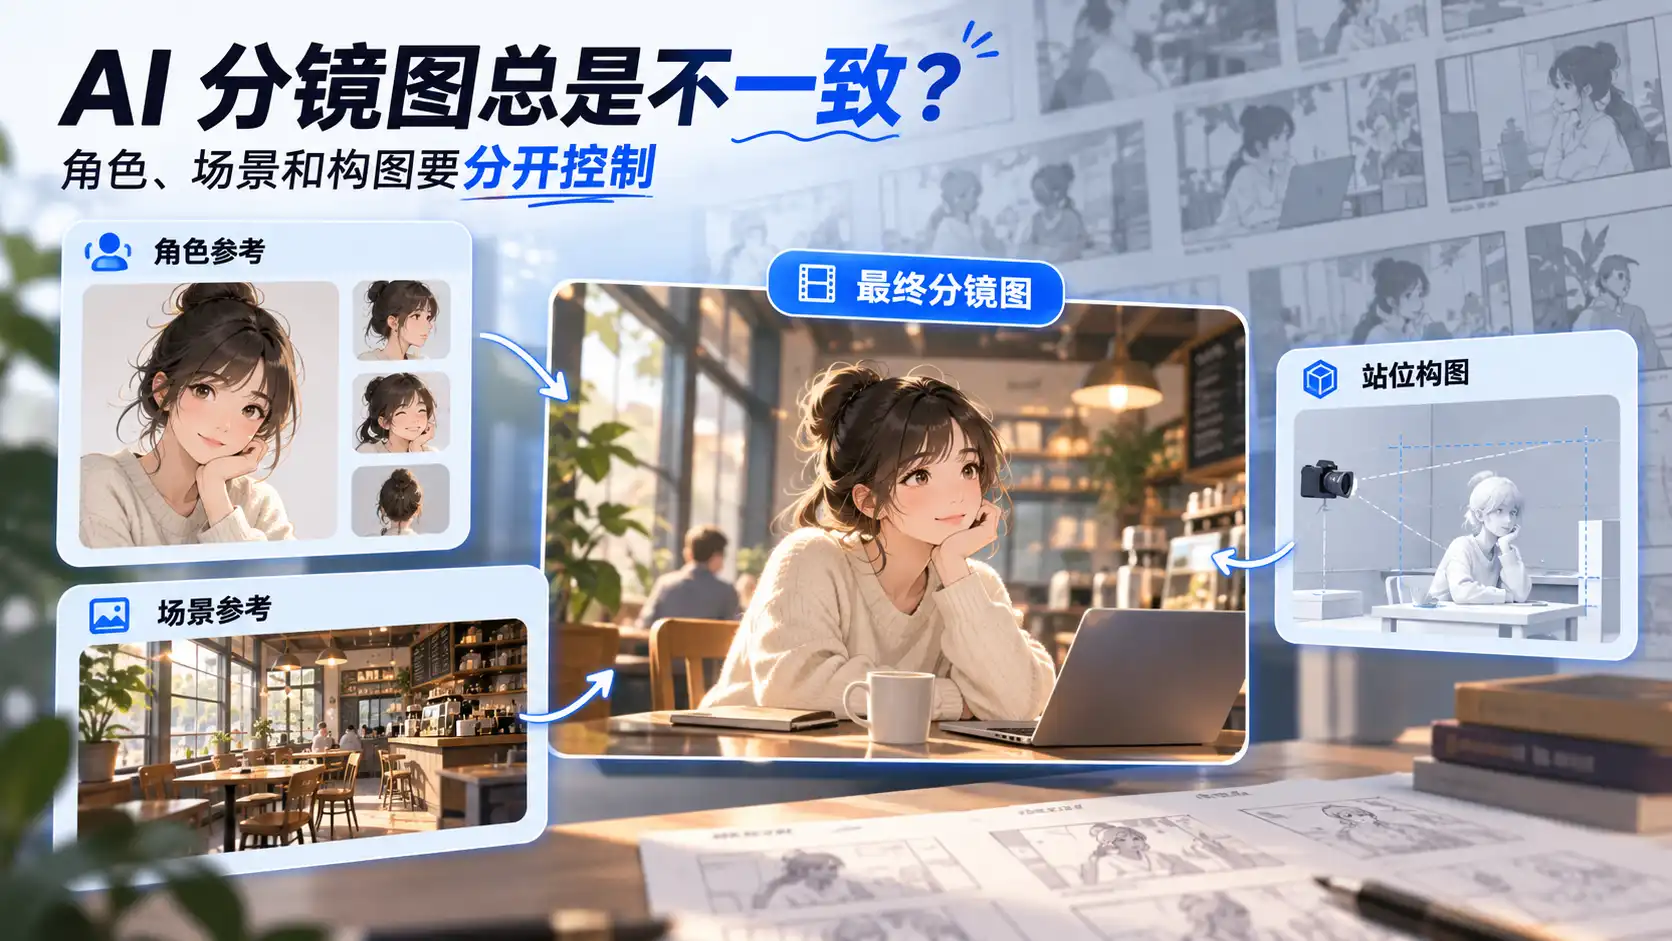
做 AI 分镜图的时候,经常会遇到一种情况:人物明明已经描述得很详细,生成到下一镜还是变脸。同一个办公室,第一镜是一种装修,第二镜又换了一个空间。三个人明明写清楚了谁在左、谁在右,结果生成出来位置还是乱的。
很多时候,我们第一反应是继续修改提示词。再多写一点人物特征,再多补一点场景描述,再强调一次谁站在哪里。但做得越多,我越觉得,这里面其实混在了一起的是三个完全不同的问题:
- 人物是谁
- 故事发生在哪里
- 人物在这个空间里怎么站
如果把这三件事全部交给一段提示词解决,镜头越复杂,越容易失控。
人物一致性,先解决“这个人是谁”
角色参考最适合解决的,是人物身份和外观。
例如一个女生连续出现在十个镜头中,她的脸、发型、服装和整体形象不应该每次重新生成一遍。如果每个镜头只靠文字重新描述:“年轻女性,黑色长发,白色针织衫……”AI 每一次都还是有重新理解人物的空间。所以角色会慢慢漂。更稳定的方式,是先确定一套角色参考,然后在不同镜头里持续复用。
- 动作可以变
- 表情可以变
- 景别可以变
- 镜头角度也可以变
但“这个人是谁”尽量不要每镜重新定义。
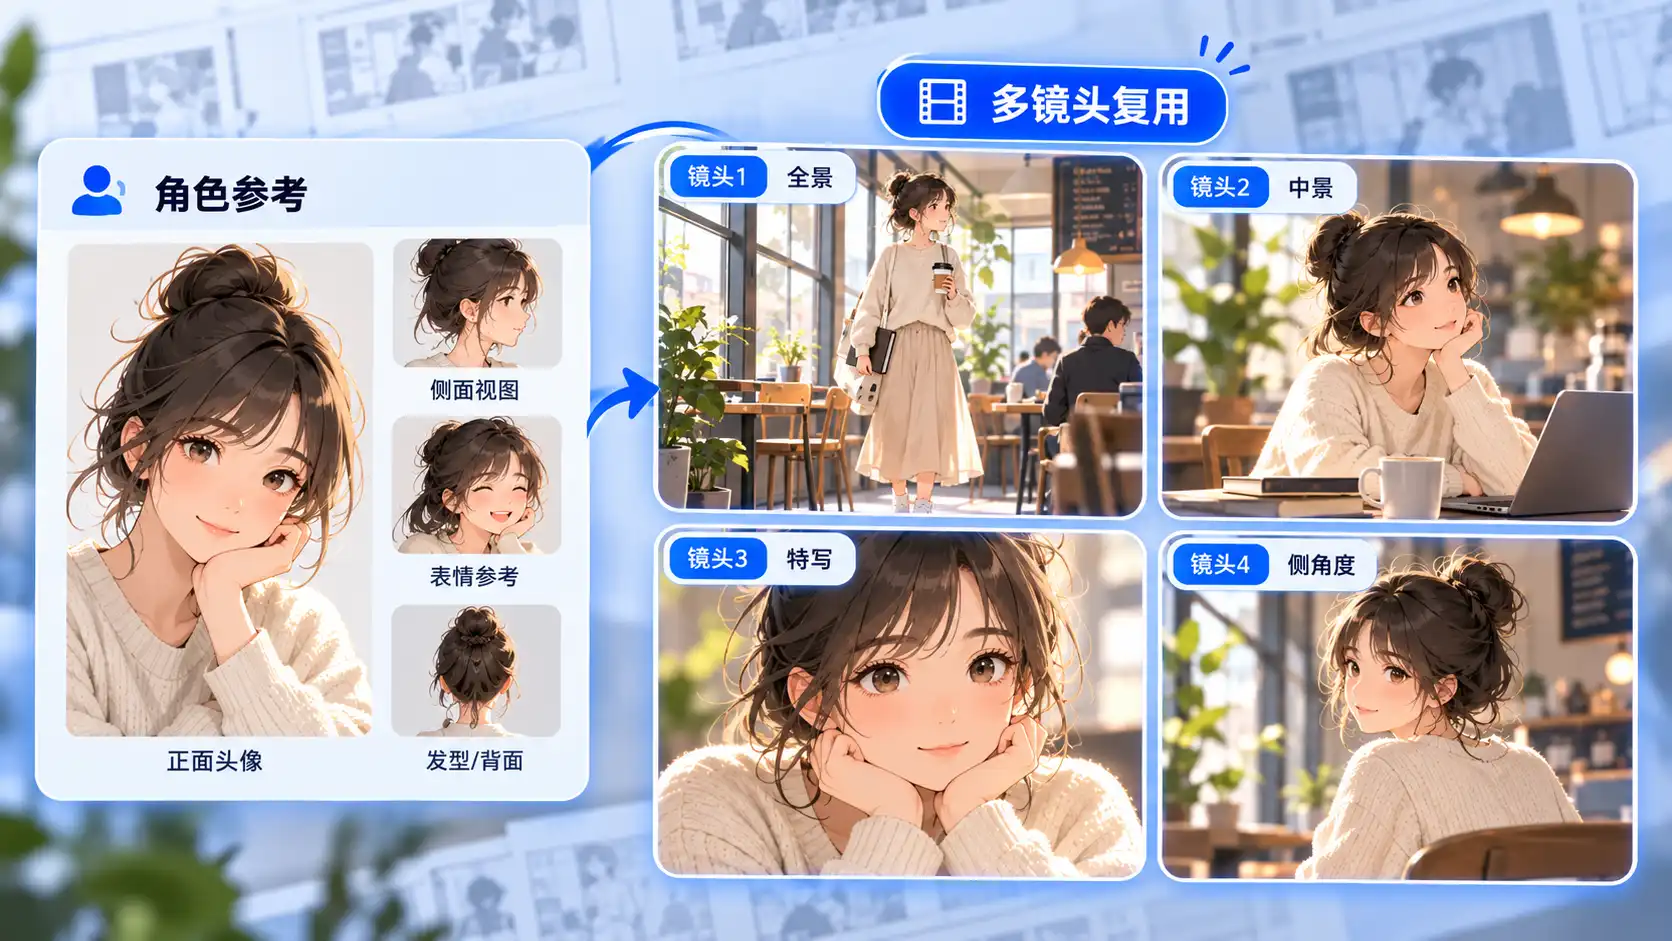
这也是为什么角色一致性和提示词其实不是一回事。角色参考负责固定人物身份,提示词负责告诉 AI 这一镜人物正在做什么。
场景一致性,解决的是“故事发生在哪里”
另一个常见问题是场景变化。比如整个故事都发生在同一家咖啡馆。
- 第一镜是全景
- 第二镜是人物中景
- 第三镜切到女生近景
- 第四镜再拍男生过肩镜头
如果每一镜都重新写:“阳光充足的现代咖啡馆,木质桌椅,有绿植和落地窗。”模型依然可能每次重新设计一间咖啡馆。这时候更有效的方法,是直接把场景当成一个持续复用的资产。
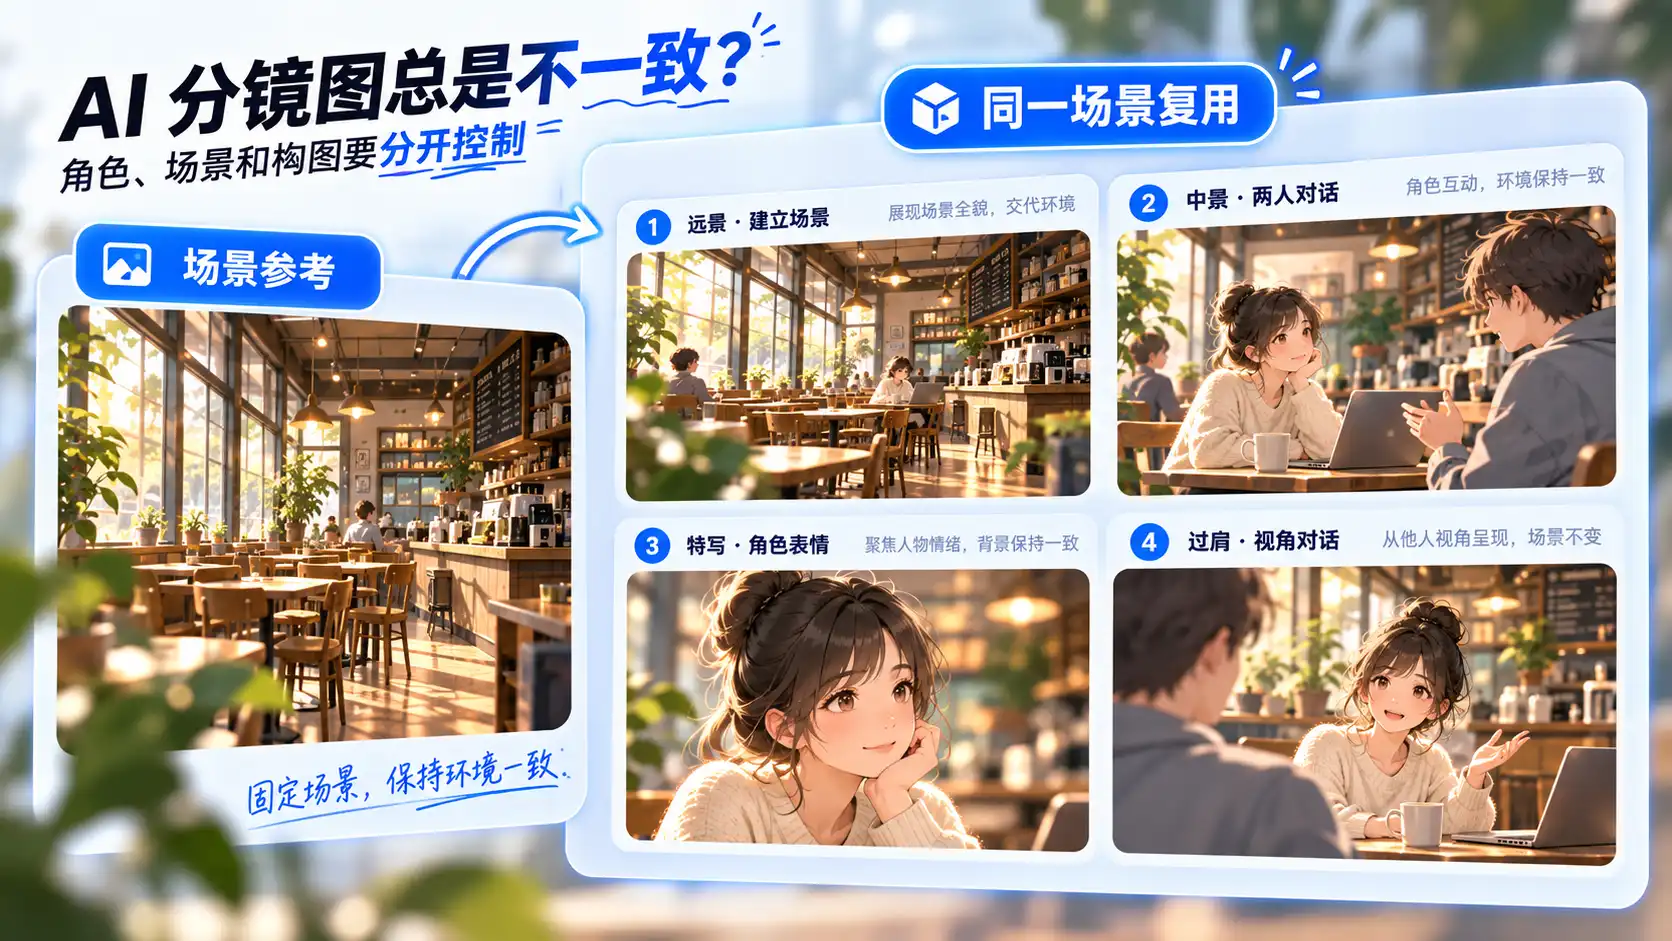
场景参考解决的是:
- 这是什么地方
- 环境大概长什么样
- 整体空间、装修和氛围是什么
后面的镜头只是在这个已有场景里改变摄影机位置和人物表演,而不是每一镜重新创造一个世界。如果想进一步看这个问题,可以参考《AI视频如何保证场景一致性?》。
角色和场景都对了,人物位置还是可能错
这也是第三类问题。角色参考正确。场景参考也正确。但最后出来的画面还是不对。例如两个人在酒店走廊里。人物长得完全没问题,走廊也是同一条走廊。但剧情要求他们并排走向包间门,AI 却生成成两个人面对面站着。这时候继续修改角色参考没有意义,继续换场景参考也解决不了。因为问题根本不在“谁”和“哪里”。而在:
- 他们怎么站
- 朝哪个方向
- 相互是什么位置关系
- 镜头从哪里看
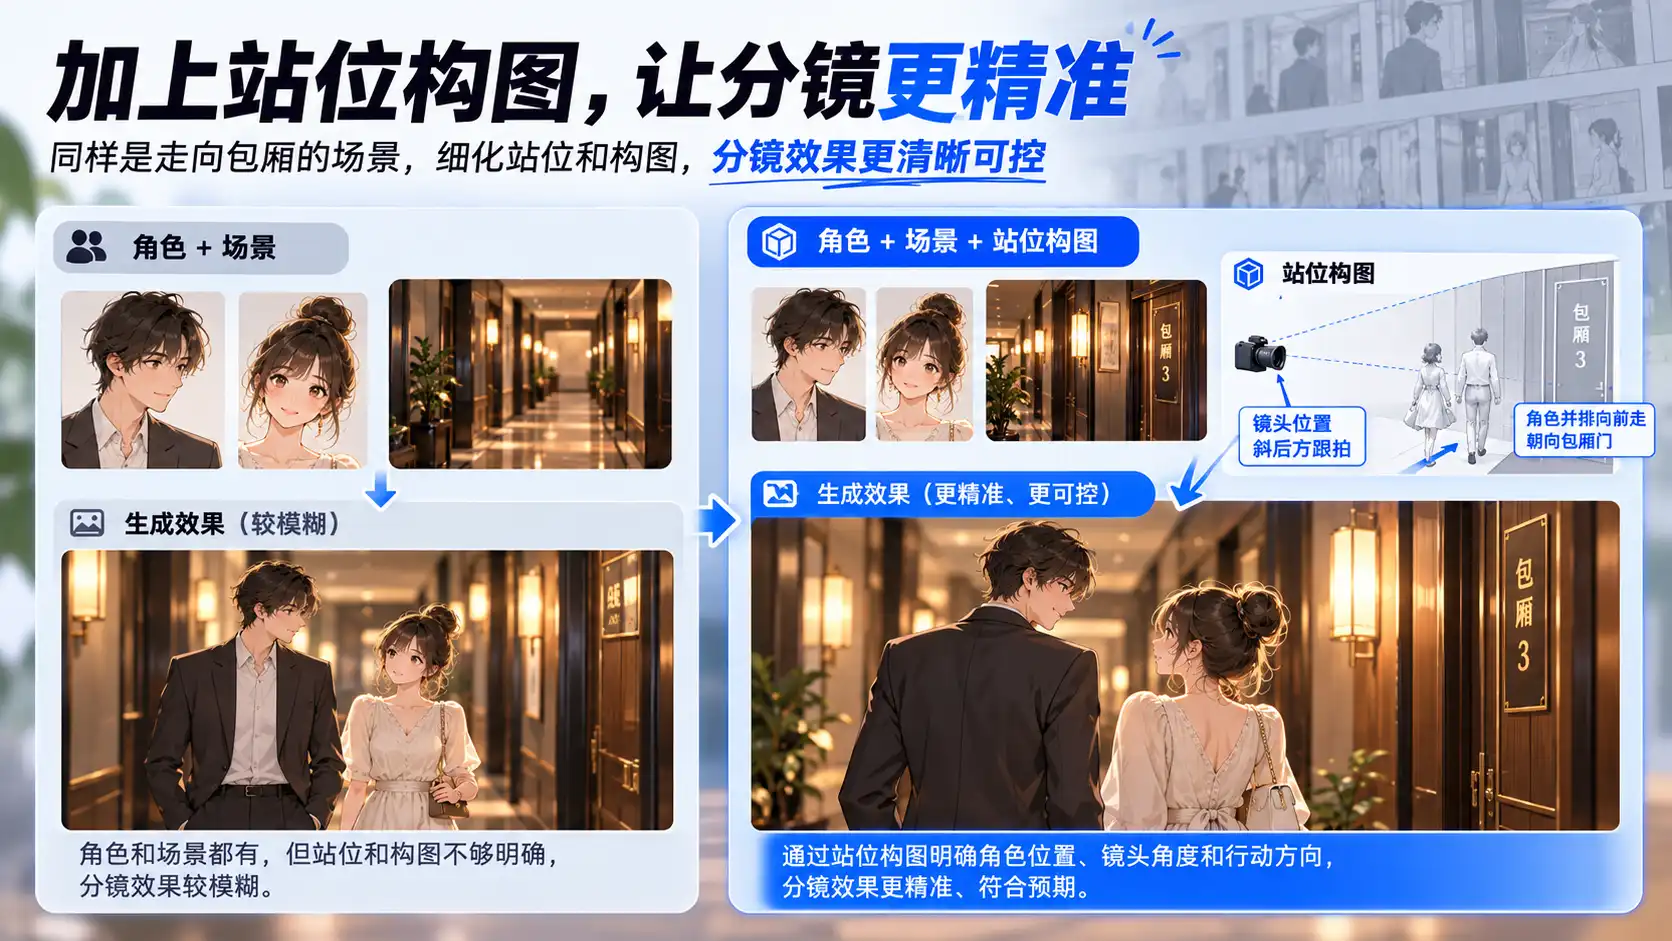
这时候就需要另外一层参考:站位构图。
站位构图解决的是空间关系
站位构图本身不需要长得像最终画面。它最重要的任务其实非常简单:让 AI 看懂人物之间的空间关系。例如三个人围桌聊天:
- 角色 A 正对镜头
- 角色 B 坐在右侧,侧身面对 A
- 角色 C 背对镜头,只露侧脸
- 摄影机放在桌子另一侧
如果这些信息全部写成文字,已经开始变得复杂。人物再增加到四个,或者开始有人走动以后,提示词会越来越难读。但如果先把人物摆出来,关系反而一眼就能看懂。
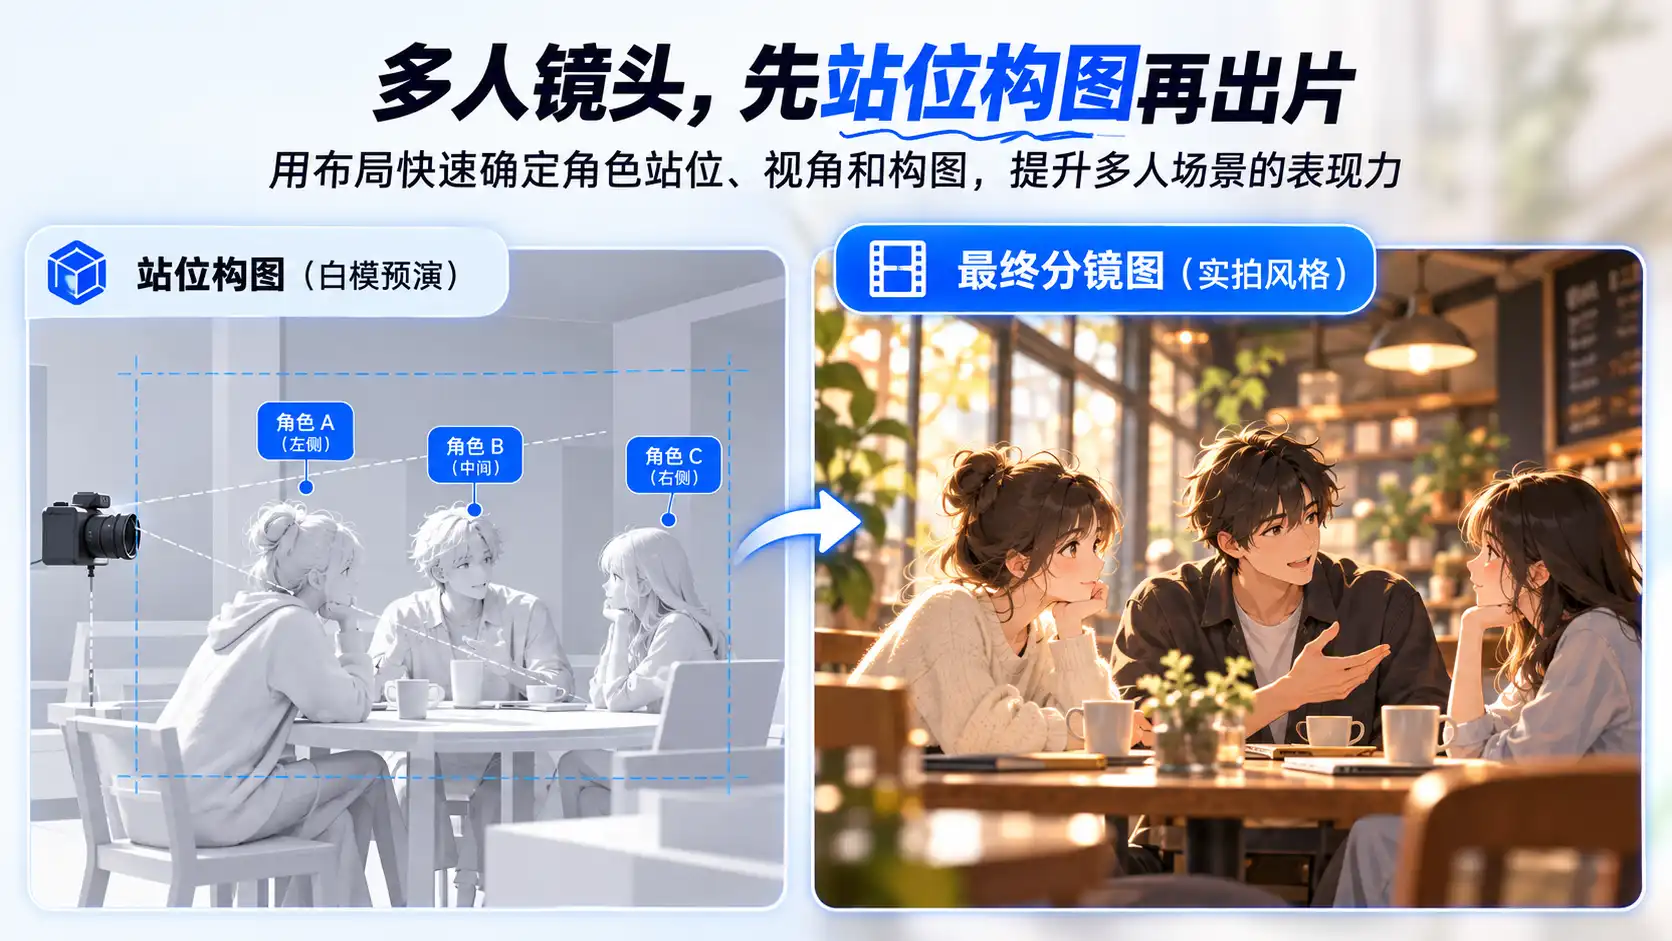
所以我现在会把它理解成:
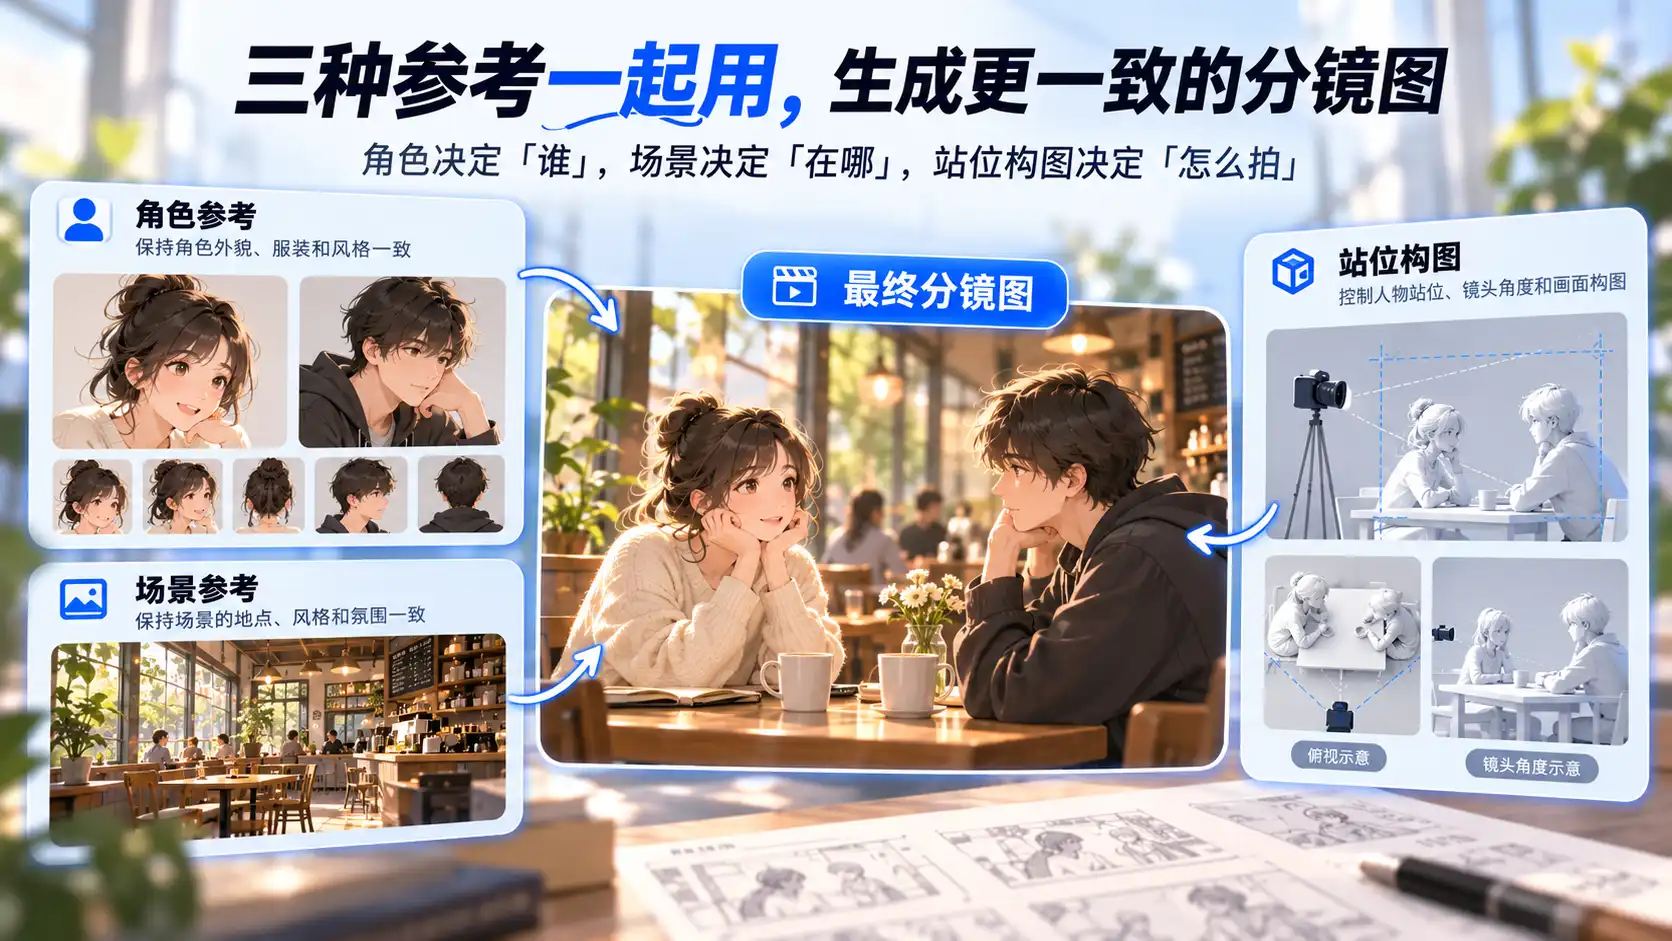
- 角色参考控制“谁”
- 场景参考控制“哪里”
- 站位构图控制“怎么摆”
如果你经常遇到多人镜头角色站错位置,可以看《AI 视频多人镜头总是站错位置,怎么解决?》。
那提示词还负责什么?
这时候很容易产生另一个误区:既然角色、场景和站位都有参考图,是不是提示词就不重要了?其实不是。参考资料更适合负责“不希望变化”的信息。提示词则负责“这一镜正在发生什么”。例如:
- 女生微笑着托腮看着对面的男生
- 男生正在认真讲故事
- 两个人的情绪轻松
- 窗外阳光照进咖啡馆
这些信息属于当前镜头的动作、表情和情绪。它们仍然应该由提示词来描述。
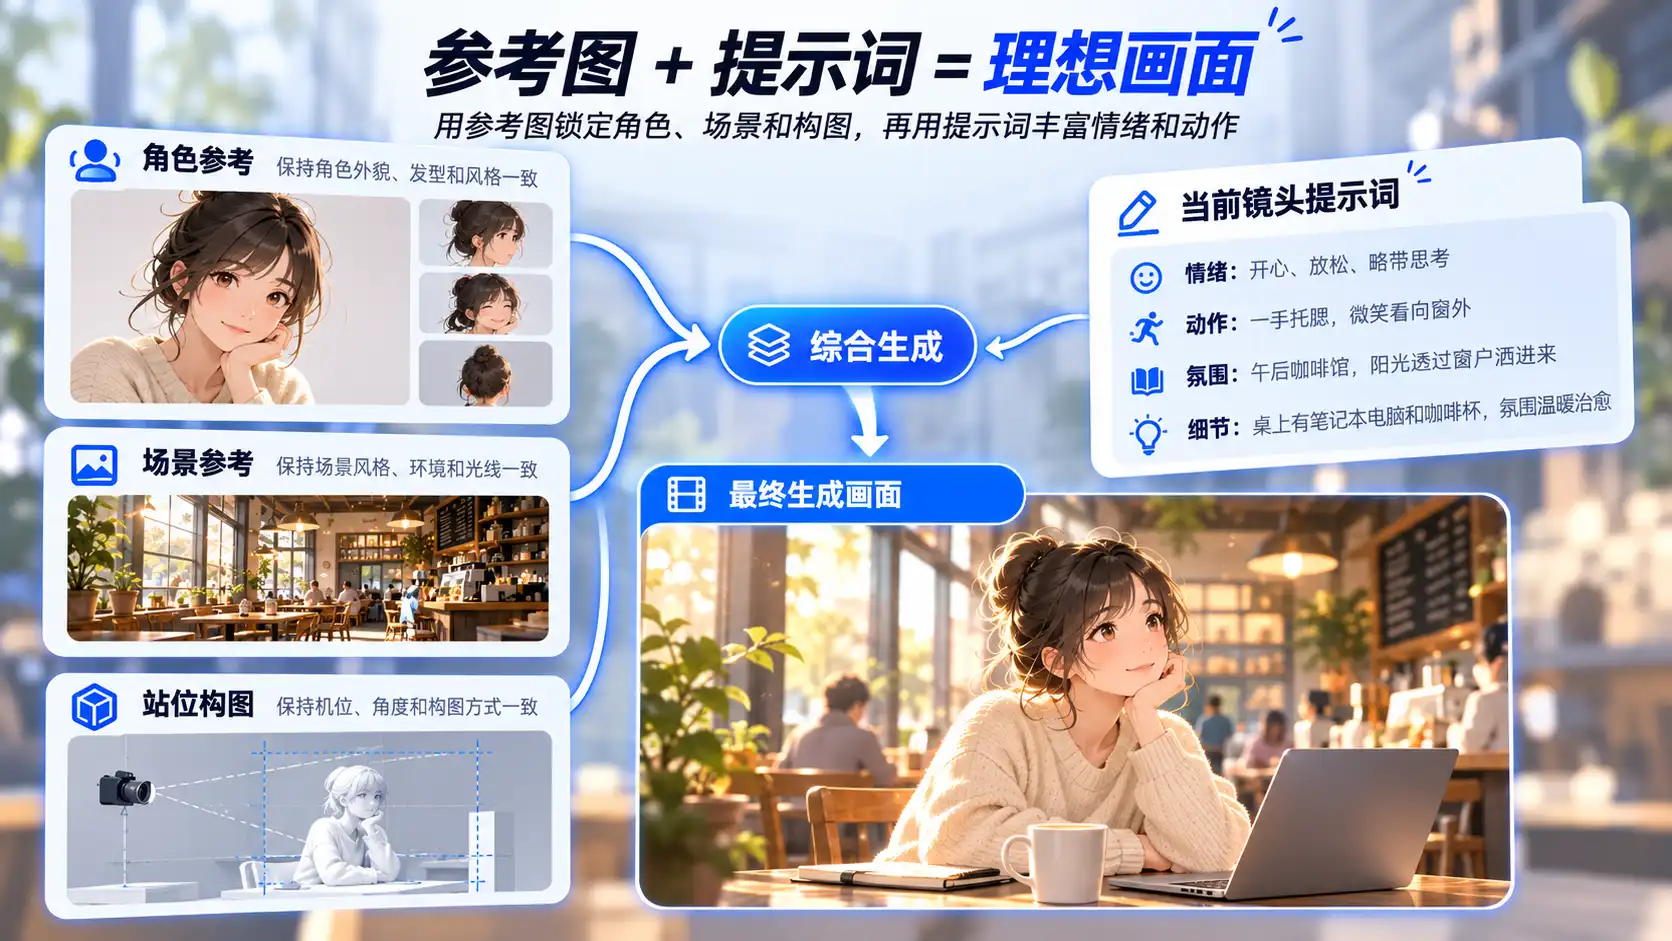
所以我现在更喜欢把一张 AI 分镜图理解成两部分:一部分是固定信息。另一部分是变化信息。角色、场景和站位负责固定。动作、表情、互动和氛围由这一镜的提示词负责变化。
不同镜头,不需要使用同样多的参考
还有一个问题也很常见:是不是每一个镜头都应该角色、场景、站位全部加上?我觉得完全没必要。
一个普通人物特写,如果背景本身不重要,只用角色参考可能已经够了。
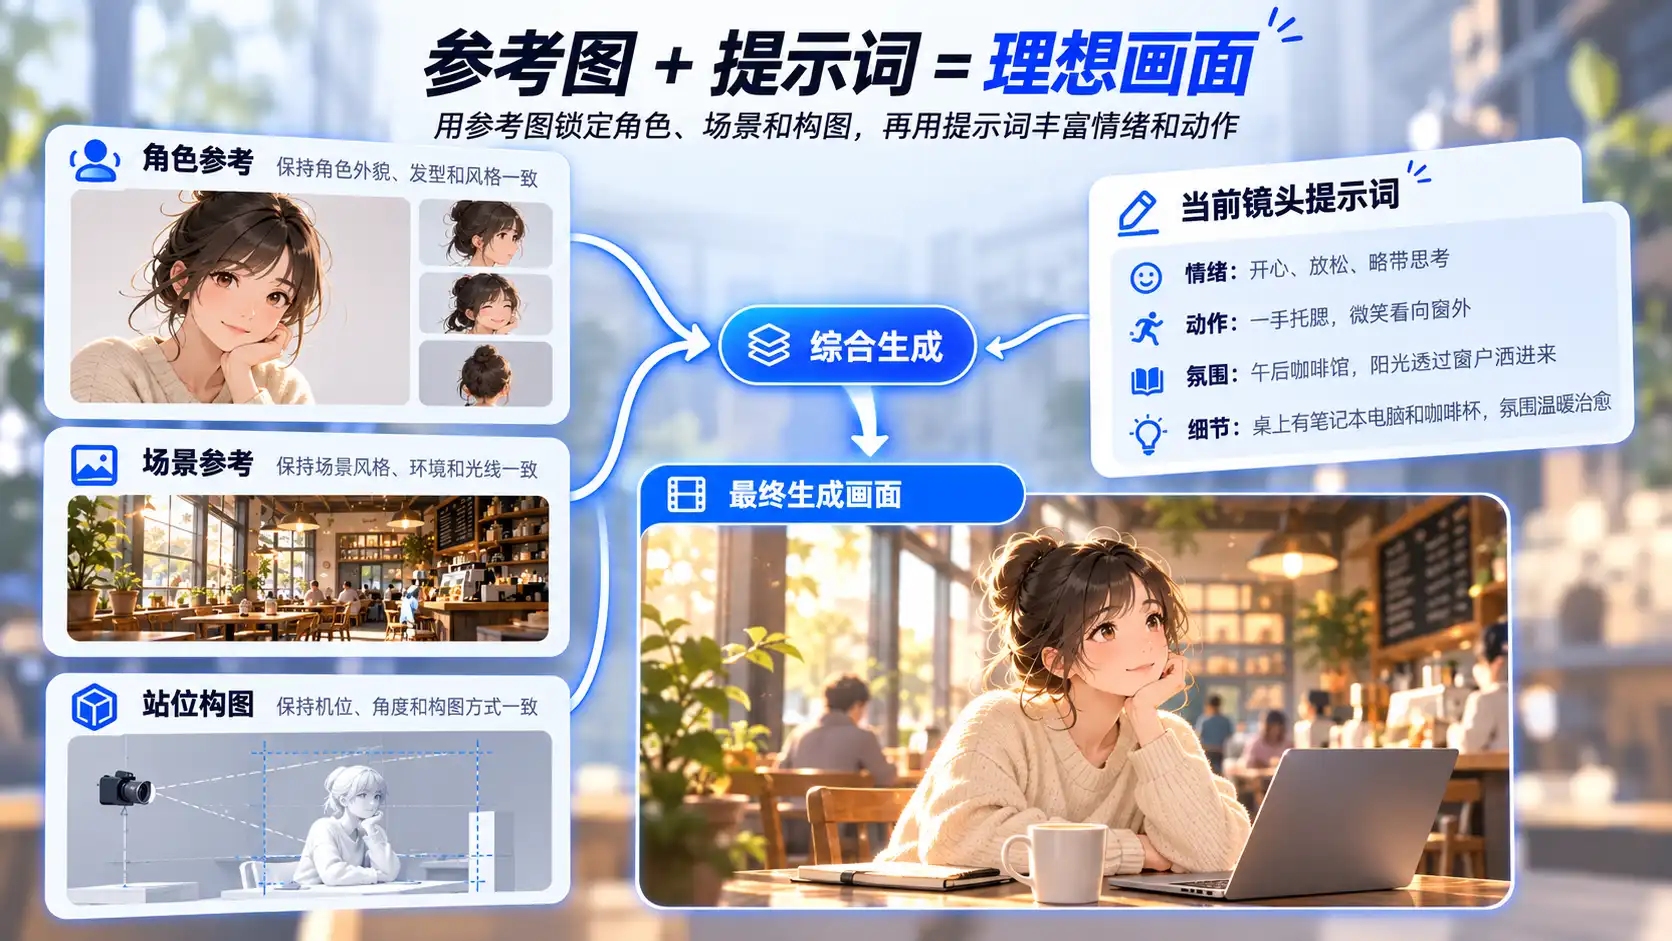
如果是在一个需要保持连续的固定环境中,可以使用:角色 + 场景。如果到了普通双人镜头:两个角色 + 场景。人物位置本身已经比较复杂,再继续加入:站位构图。人物到了三人、四人甚至更多时,站位构图的价值就会越来越明显。不是因为参考资料越多越好,而是因为不同复杂度的镜头,需要解决的问题数量不一样。
画幅也是构图的一部分
还有一个很容易被忽略的问题,是画幅。假设站位构图是在 16:9 里做的。人物左右关系、前后距离和场景范围,都是按照 16:9 安排的。如果真正 AI 生图时突然改成 9:16,原来的构图关系一定会发生变化。可能人物被裁掉。人物距离发生变化。或者场景范围明显缩小。
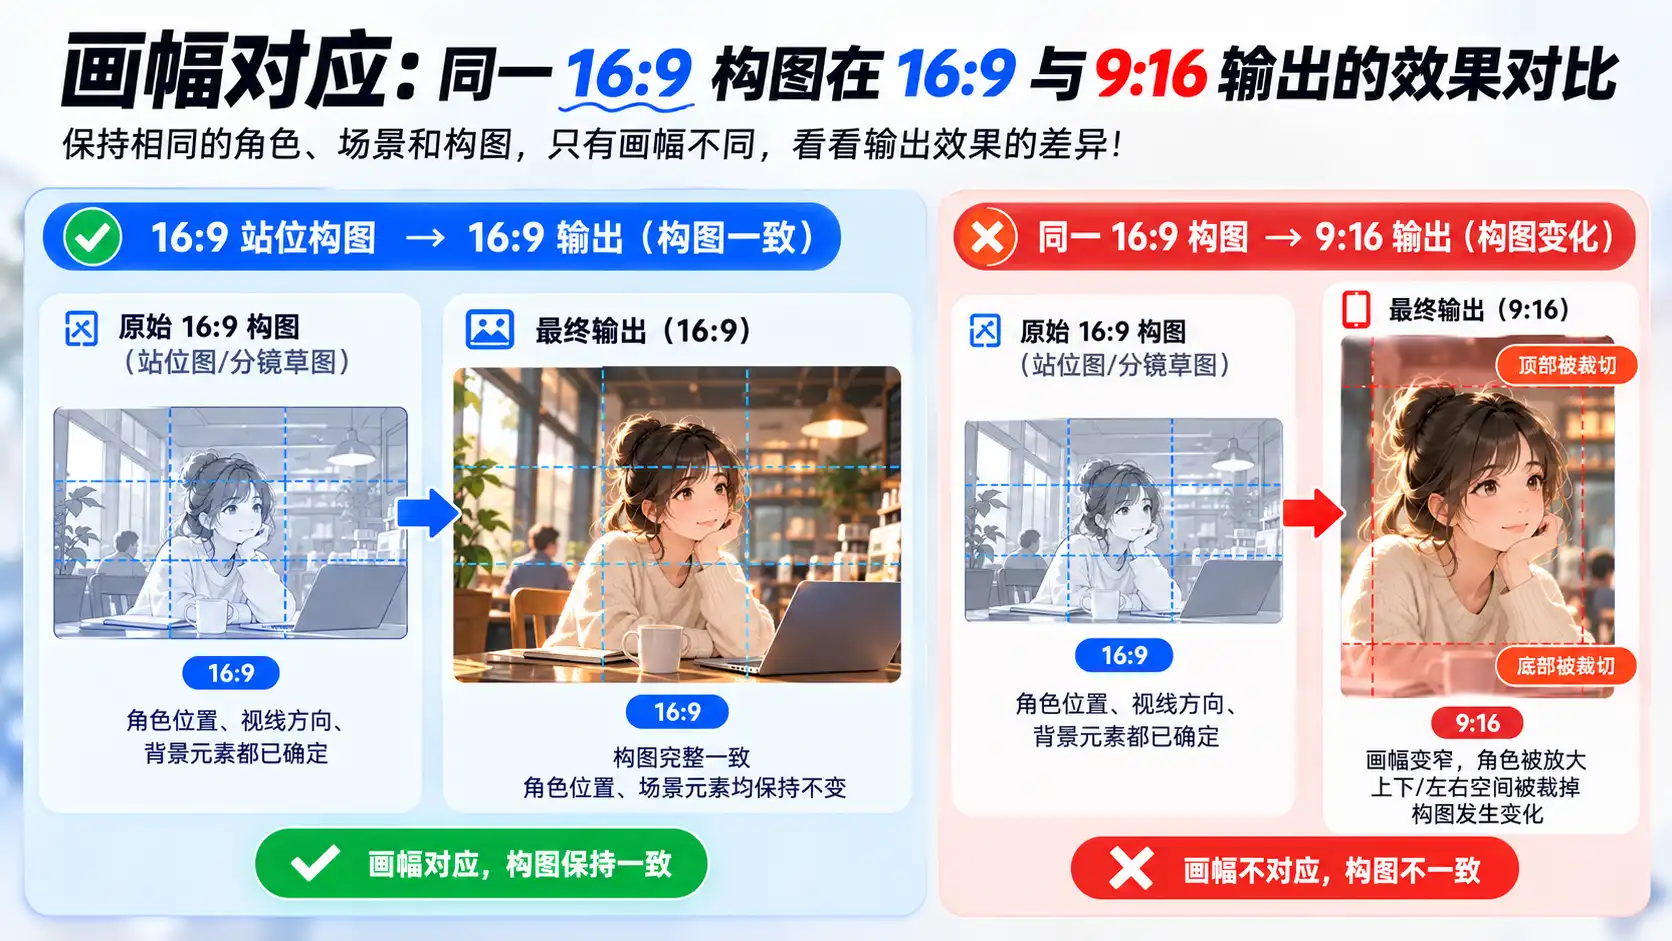
所以构图参考和最终生图,最好从一开始就使用一致的画幅。这听起来是一个小问题,但多人镜头尤其明显。
我们后来为什么把这三类参考放到一起
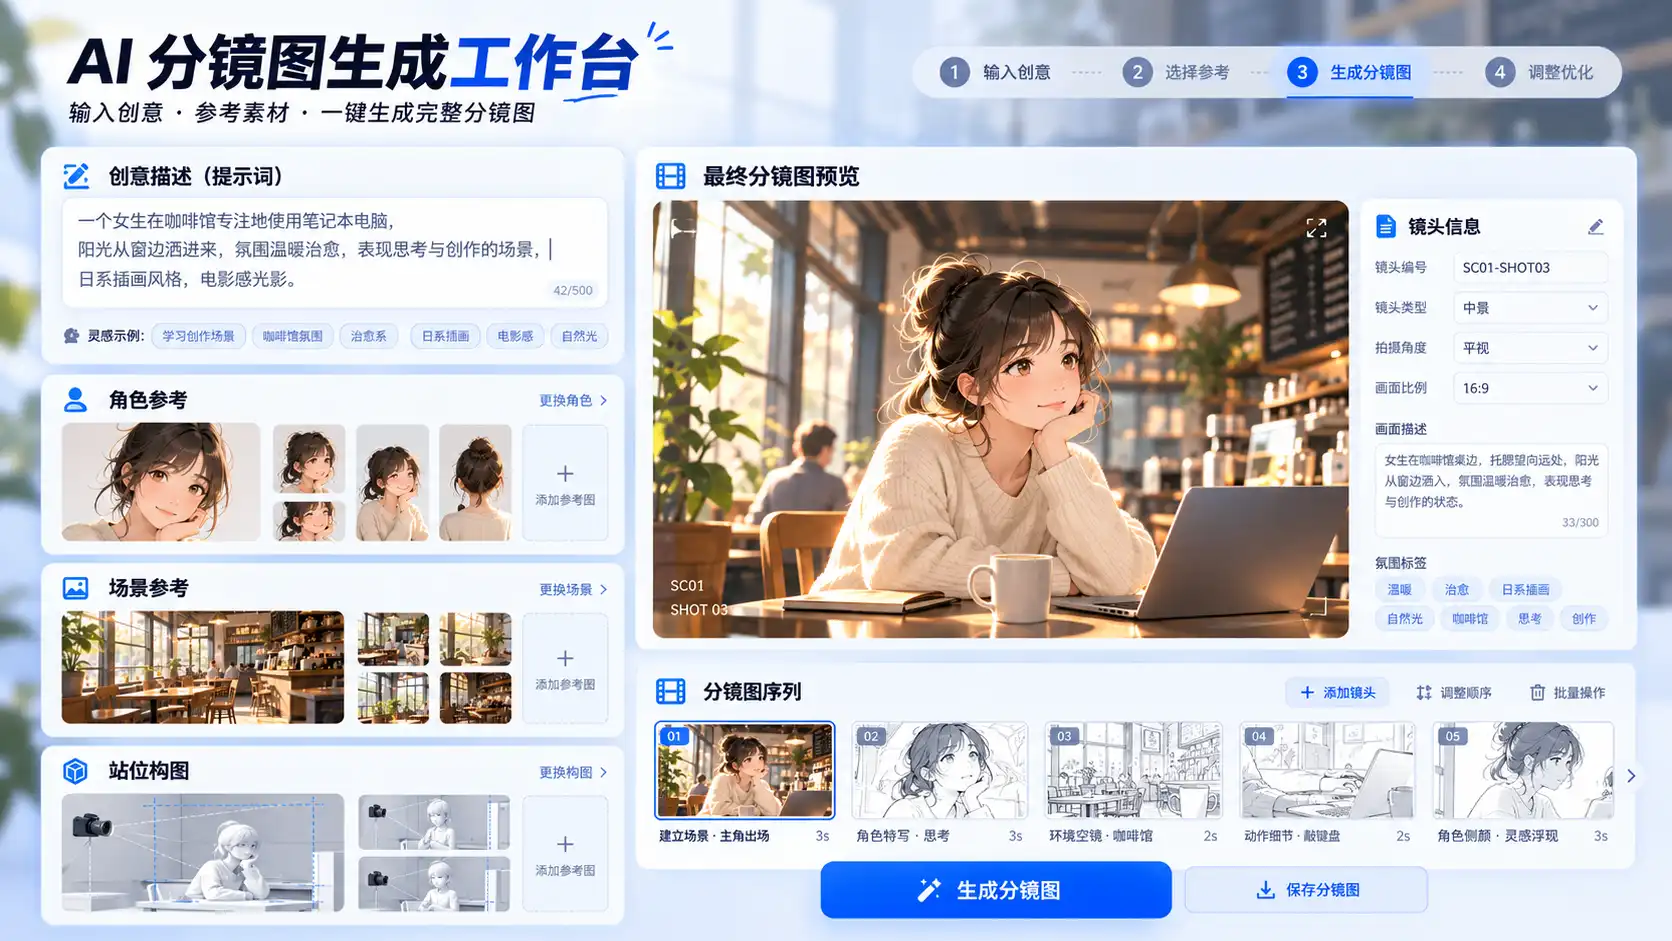
我们后来在小镜故事板的 AI 画镜头里,把角色、场景和站位构图放进同一个生成流程,其实也是因为做镜头多了以后,发现“一致性”并不是一个开关。
它是几个问题叠在一起的结果。人物不一致,是角色问题。环境乱掉,是场景问题。人物位置错误,是构图问题。这些问题如果全部靠提示词解决,文字会越来越长,但控制力并不会同步增加。把它们拆开以后反而简单很多。
最后
AI 分镜图的一致性,我觉得可以先不要当成一个整体问题。先判断到底是哪一层出了问题:
- 人物变了,就看角色参考
- 环境变了,就看场景参考
- 人物关系不对,就看站位和构图
- 动作、表情和情绪不准确,再回到当前镜头提示词
把这些问题拆开以后,很多原本只能靠“不断重抽”的镜头,其实会变得更容易控制。AI 不一定需要你把所有东西写进一条超长提示词里。有时候更好的方法,是把不同信息交给不同的参考去负责。