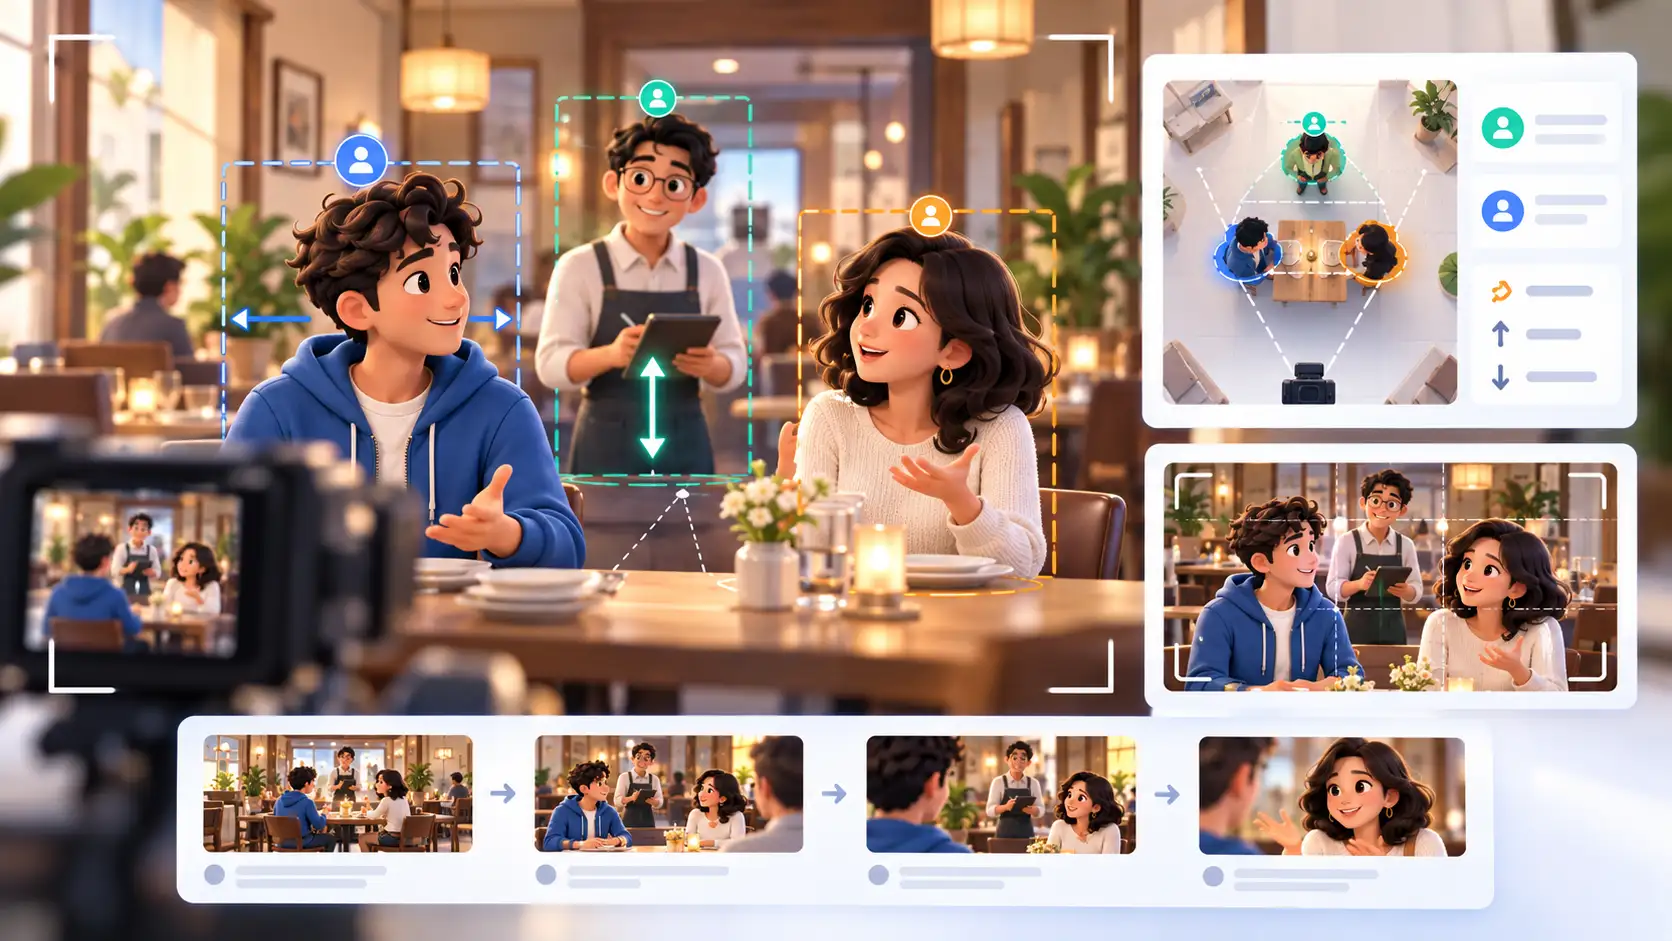
做 AI 视频时,有一种问题特别容易被误认为“角色一致性不好”。
人物的脸没变,衣服也没变,场景看起来也是同一个地方,但镜头一切换,两个人左右站反了。到了三个人,问题会更明显:上一镜孩子明明坐在爸爸和妈妈中间,下一镜可能跑到了最左边;原本面对面说话的两个人,换一个镜头以后又变成了并排站着。这种情况继续修改角色描述,通常没有太大作用。因为角色一致性解决的是“这个人是谁”,而多人镜头里真正出问题的往往是另一件事:
这些人在空间里到底是什么关系。
人物长得一样,不等于人物位置会一样
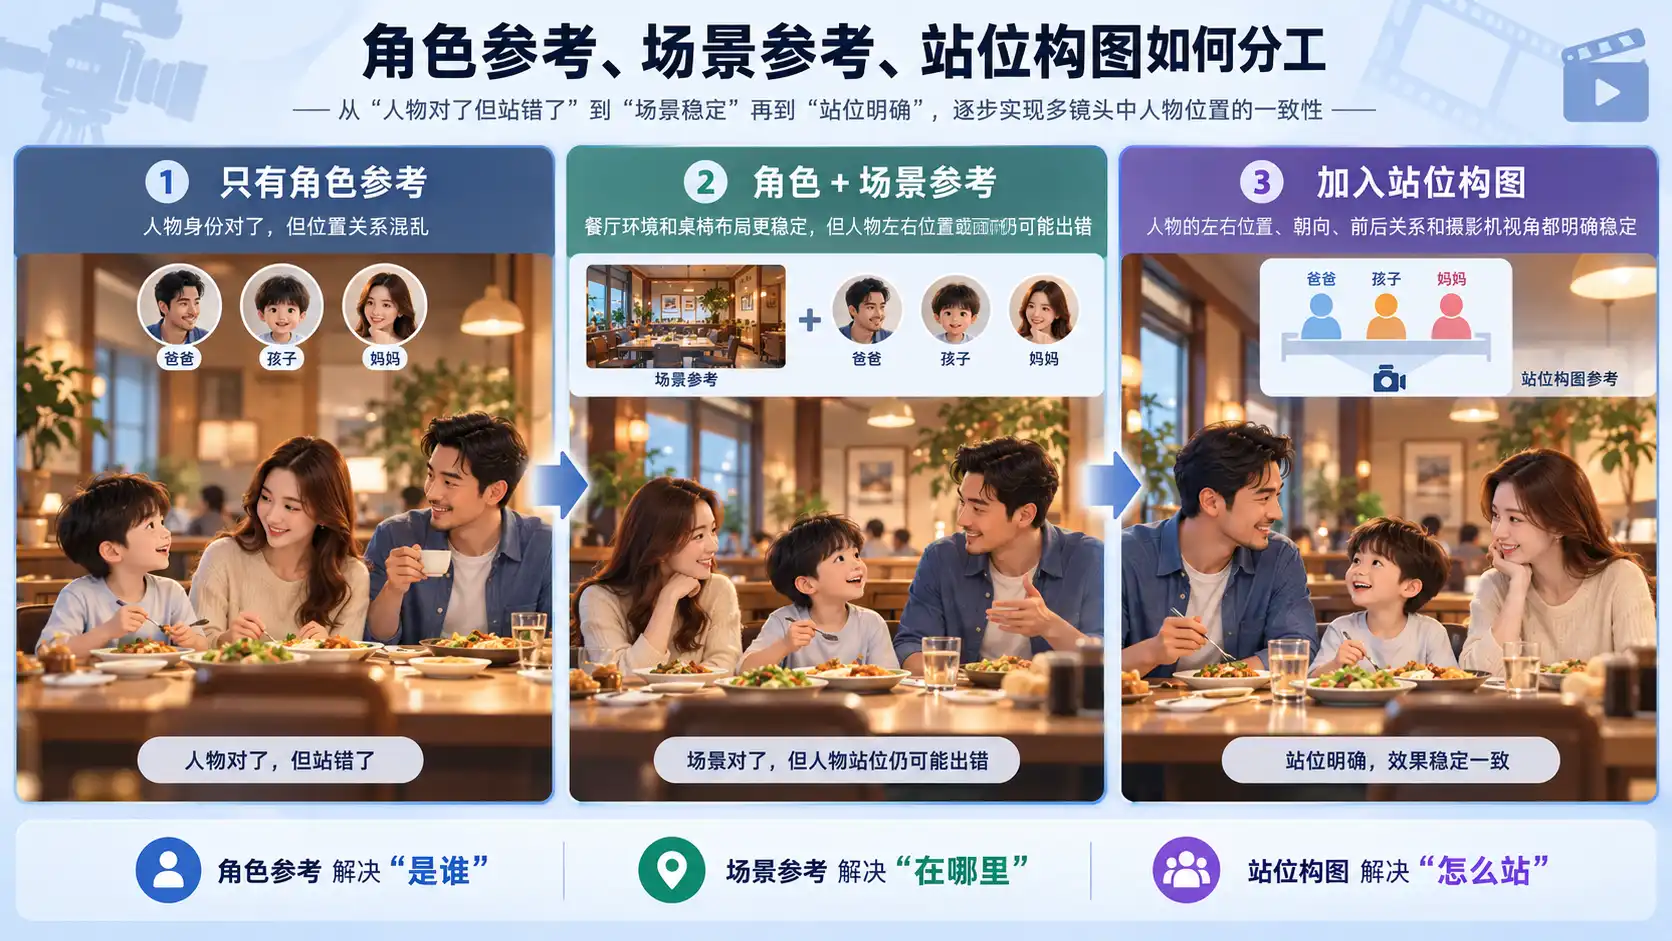
假设现在有一个很简单的三人场景。一家三口坐在餐桌前,爸爸在左边,孩子坐在中间,妈妈在右边。你已经准备好了爸爸、妈妈和孩子的角色参考图。AI 很可能已经能够稳定识别三个人分别是谁。但这并不意味着它天然知道:
爸爸必须在画面左边。
孩子必须坐在两人中间。
妈妈必须在画面右边。
三个人分别朝什么方向坐。
摄影机是从餐桌哪一侧拍摄。
这些都不是“角色长相”的信息,而是空间关系。所以多人镜头里经常会出现一种情况:角色是对的,位置却是错的。这也是为什么只解决角色一致性以后,多人镜头依然可能出问题。如果你的问题主要是人物脸、发型和服装在不同镜头之间发生变化,可以先看《AI视频如何保持角色一致性?》。那解决的是另一层问题。
场景参考也不能替代人物站位
接下来再给这个镜头加入餐厅的场景参考。现在 AI 又知道了:
这是哪一个房间。
桌子大概在哪里。
背景是什么样。
整个空间的风格是什么。
场景稳定性会提高,但三个人之间的具体位置仍然不一定稳定。因为场景参考主要解决的是:“事情发生在哪里。”它并不会自动回答:
“爸爸和妈妈谁在左边?”
“孩子坐在哪两个人之间?”
“谁更靠近摄影机?”
“谁背对镜头?”
所以多人镜头至少需要把三个问题分开:角色参考解决“是谁”,场景参考解决“在哪里”,人物站位解决“怎么站”。这三个问题混在一起以后,提示词会越来越长,但控制力未必越来越强。如果你遇到的是摄影机一换位置,整个房间结构也跟着变化,可以继续看《AI视频如何保证场景一致性?》。
“谁在左边”其实还没有想象中那么简单
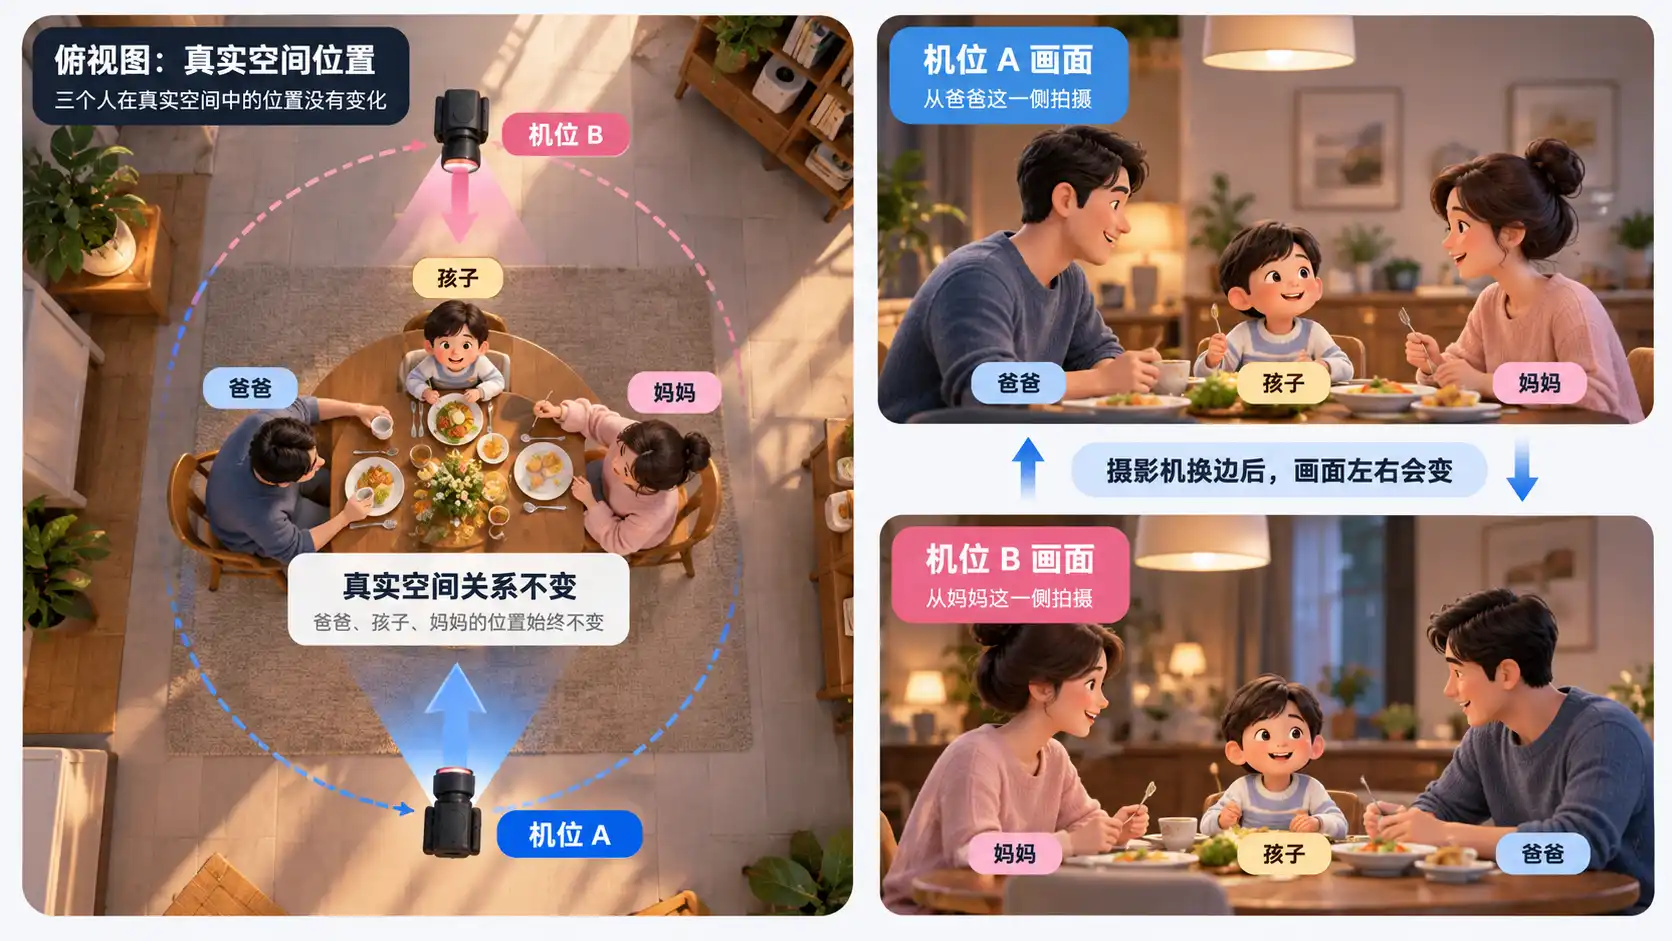
这里还有一个特别容易忽略的问题。假设爸爸现实空间中坐在桌子西侧,妈妈坐在东侧。摄影机从餐桌南边拍过去时,爸爸可能出现在画面左边。但如果摄影机移动到餐桌另一边再拍,画面中的左右关系就可能发生变化。也就是说:
空间里的左和右,与最终画面里的左和右,不一定是一回事。
所以真正需要确定的并不是一句简单的“爸爸在左,妈妈在右”,而是几件事一起确定:
人物在场景里的位置。
人物面向什么方向。
摄影机位于哪里。
摄影机朝哪个方向观察。
最终画面是什么景别和构图。
这也是为什么人物一多、摄影机一动,纯文字越来越难描述。尤其是你还要连续做几个镜头的时候,第一镜、第二镜、第三镜之间很容易各自成立,但放在一起以后空间关系就断了。
多人镜头最难的是“关系”,不是单个人
单人镜头很好理解。一个人站在走廊里,只要人物和场景基本稳定,允许 AI 有一点位置变化,通常不会明显影响故事。双人镜头开始复杂一些,但如果只是普通面对面聊天,很多时候仍然可以通过角色参考、场景和简单描述解决。真正容易失控的是三个人以上。因为人物越多,需要同时满足的位置关系越多:
爸爸相对孩子在哪里。
孩子相对妈妈在哪里。
妈妈朝向谁。
谁在前景。
谁被谁遮挡。
摄影机从哪边观察。
只要其中一个关系发生变化,观众就可能觉得“这个镜头不对”。所以三人、四人甚至更多人物的镜头,我会优先把它看成一个空间设计问题,而不是单纯的生图问题。
站位构图的作用,是先把关系变成一张图
这也是我们后来做站位构图的原因。与其继续往提示词里加:
“爸爸坐在画面左侧,孩子坐在中间,妈妈坐在右侧,爸爸稍微朝右,妈妈稍微朝左……”
不如先把人物直接放到空间里。
把爸爸摆到这里。
把孩子摆到这里。
把妈妈摆到这里。
再决定摄影机从哪里看。
这样原本需要一大段文字解释的关系,变成一张图以后会直观很多。站位构图本身不需要像最终成片。它最重要的价值,是把:人物、场景和摄影机之间的关系先固定下来。
在小镜故事板里,复杂镜头可以先把人物和机位摆出来,再把站位构图作为 AI 画图的参考。角色和场景仍然可以继续使用原本的参考资料,站位构图只是增加了“这些东西怎么组织在一个镜头里”这一层信息。具体怎么操作,可以直接看《如何使用站位构图?》。
不是所有镜头都需要做站位构图
这点也很重要。站位构图不是多一个必须完成的制作步骤。如果是普通人物特写,画面里只有一个人,通常没有必要。简单的双人对话,如果位置关系不复杂,也未必需要专门摆一次。真正值得使用的,通常是这些情况:
- 三个人以上同时出现在画面中;
- 人物存在明显前后关系或者遮挡;
- 剧情要求某个人必须站在另一个人的左边或右边;
- 人物会在场景里移动;
- 需要连续从不同机位拍摄同一组人物;
- 摄影机本身还会发生明显的位置变化。
判断标准不是“这个功能能不能用”。而是:这一镜的空间关系值不值得提前固定。简单镜头让 AI 自己发挥,复杂镜头再增加控制,整个工作流反而更轻。
连续镜头里,不要每一镜重新设计人物关系
多人镜头还有另一个问题:单张图片看起来正确,并不代表连续起来正确。例如:
第一镜:爸爸左、孩子中、妈妈右。
第二镜切到妈妈近景。
第三镜重新回到三人全景。
如果第三镜又让 AI 从零理解一次三人的位置关系,就可能重新排列。更稳妥的思路是:先确定这场戏的基本空间关系。后面的镜头在这个基础上改变景别、摄影机位置和人物动作,而不是每次重新设计整个空间。但人物站位确定以后,还要继续保证下一镜能够接住上一镜的位置、动作和运动方向。否则每一张画面单独看都可能正确,剪在一起却还是会跳。关于相邻镜头怎么保持连续,可以继续看《AI视频镜头切换为什么总是跳?前后镜头连续性怎么控制》。这其实和场景一致性的逻辑是一样的。
稳定的信息尽量继续复用。真正随着镜头变化的信息,再交给当前这一镜去变化。如果你想系统看角色、场景和站位构图在 AI 画镜头时分别应该怎么引用,可以继续看《AI画镜头时,如何引用角色、场景和站位构图?》。
摄影机开始运动以后,位置关系要更小心
如果镜头本身还在运动,问题会再复杂一层。人物可能没有移动,但摄影机从人物左侧绕到右侧以后,画面里的前后、左右以及遮挡关系都会跟着变化。这时候如果只写一句:
“摄影机环绕人物。”
AI 要同时理解人物位置、摄影机轨迹、场景结构和最终构图,变量会非常多。所以复杂运镜最好建立在已经清楚的空间关系上:
- 先知道人物在哪里。
- 再知道摄影机从哪里开始。
- 最后才决定摄影机怎么移动。
而不是人物关系还没有确定,就直接往上叠加复杂运镜。关于这一点,可以继续看《漫剧分镜中的运镜设计方法》。里面讲的其实也是同一个原则:人物运动和摄影机运动不能完全分开设计。
多人镜头可以先检查这四件事
如果一个多人镜头一直生成不对,我不会第一时间继续堆提示词。先判断:
人物身份有没有固定。
场景有没有固定。
人物之间的位置和朝向有没有明确。
摄影机位置有没有明确。
前两个问题主要由角色和场景参考解决。后两个问题才是真正的站位和构图问题。把问题定位清楚以后,再决定到底应该改角色参考、场景参考、站位构图,还是当前镜头的提示词。很多时候,“AI 又站反了”并不是一个问题,而是几种完全不同的问题被混在了一起。
最后
AI 视频里的多人镜头,不应该只追求“每个人都长得对”。真正决定画面是否连贯的,还有人物之间的空间关系:
- 谁是谁。
- 在哪里。
- 怎么站。
- 摄影机从哪里看。
这几件事情拆开以后,多人镜头会比全部塞进一条提示词里更容易控制。尤其到了三个人以上,或者人物和摄影机都开始移动的时候,提前把空间关系确定下来,往往比生成错误以后不断重抽更省时间。