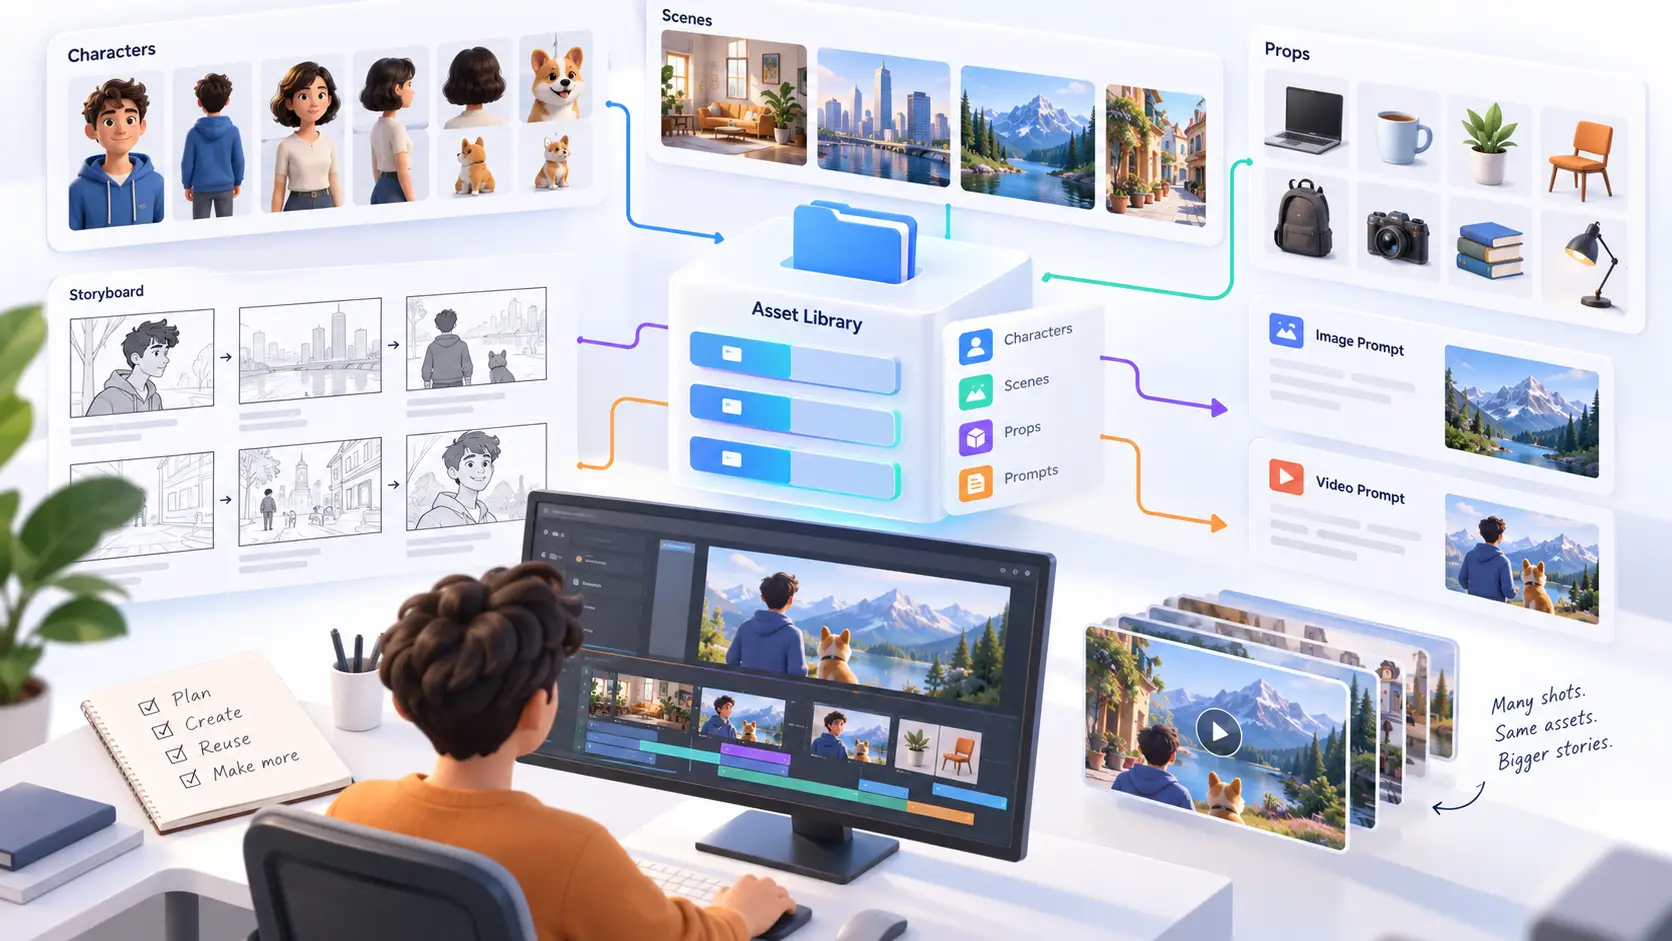
- 这个镜头要用哪个角色图?
- 这个场景之前生成过没有?
- 那个道具放在哪里?
- 上一镜用的是哪张参考图?
- 这个角色的视频提示词又是哪一版?
做到这个阶段以后,影响效率的往往已经不只是模型,而是你有没有把这些东西管理好。
一个镜头需要的东西,其实越来越多
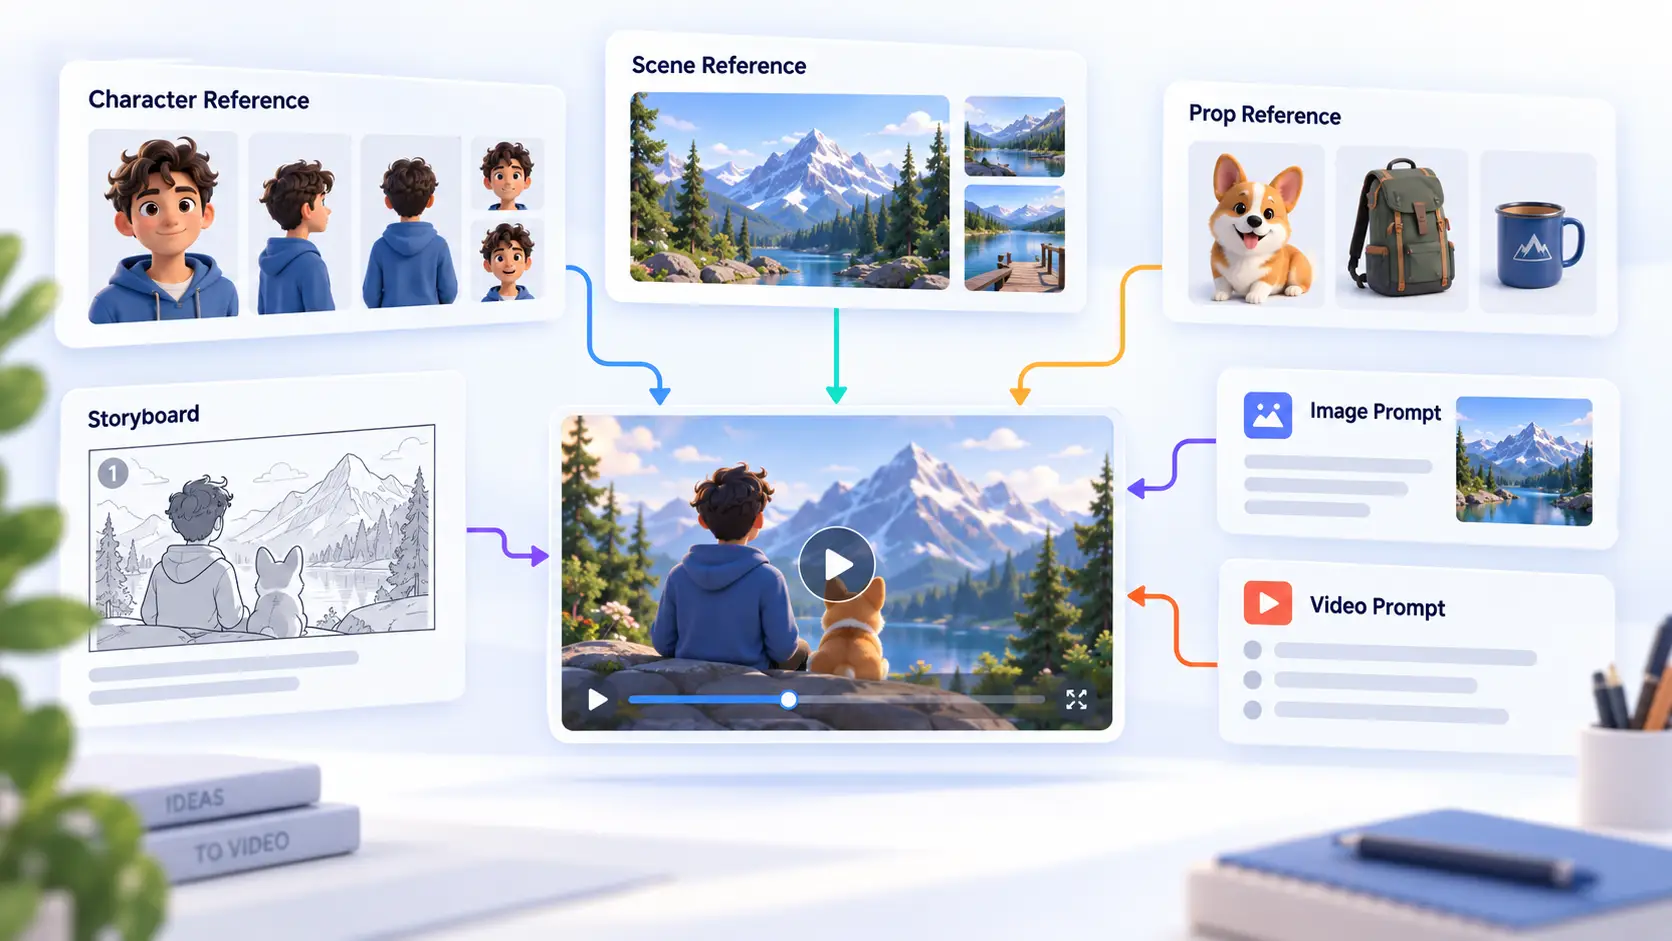
以前做纯文生视频,一段提示词可能就可以开始生成。但现在想把人物、场景和镜头关系控制得更稳定,输入给视频模型的资料正在越来越多。一个镜头可能会涉及角色参考图、场景参考图、道具图片、分镜画面、人物站位、视频提示词,甚至还要告诉模型哪些图片分别代表谁。
模型能力越强,我们可以控制的参数也越多。但换一个角度看,参数越多,也意味着制作之前要准备和管理的资料越多。
这也是为什么很多人刚开始做 AI 视频觉得很快,真正做到长一点的内容以后,反而开始觉得流程越来越复杂。问题通常不是“AI 不会生成”,而是下一镜开始之前,你又要重新找一遍东西。
角色一致性,本质上也有一部分是资产问题
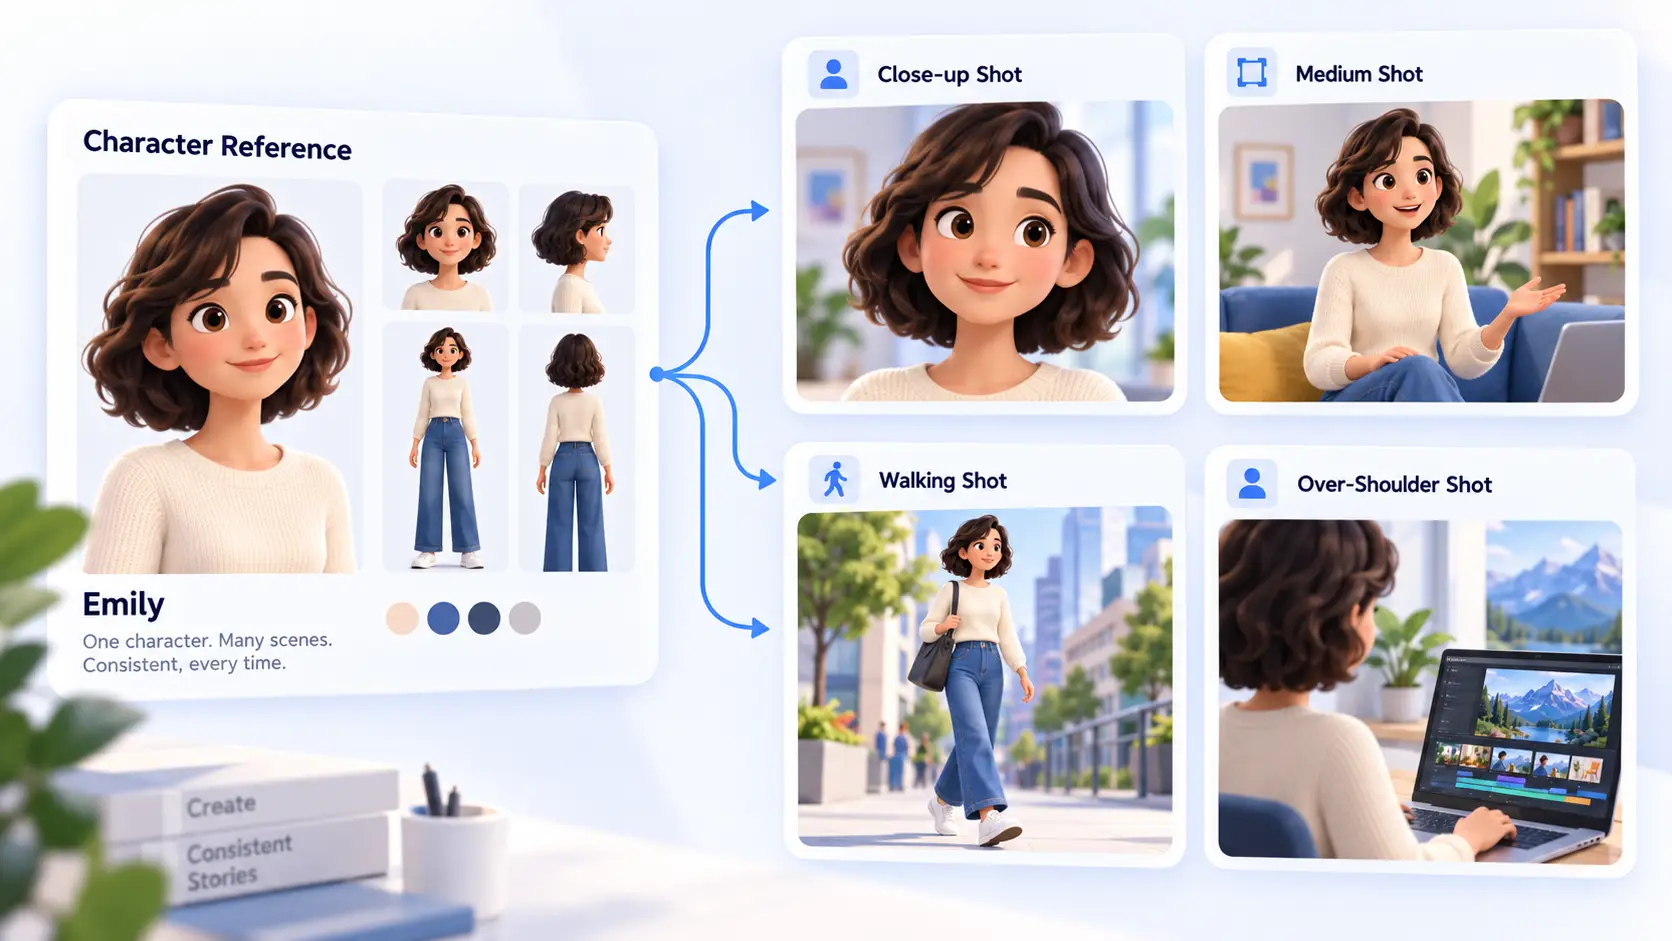
我们经常会讨论 AI 视频里的角色一致性。最直观的问题当然是人物容易变脸、换衣服、发型变化。模型能力是一部分原因,但实际制作过程中,还有一个很容易被忽略的问题:你自己提供给模型的参考资料稳不稳定?
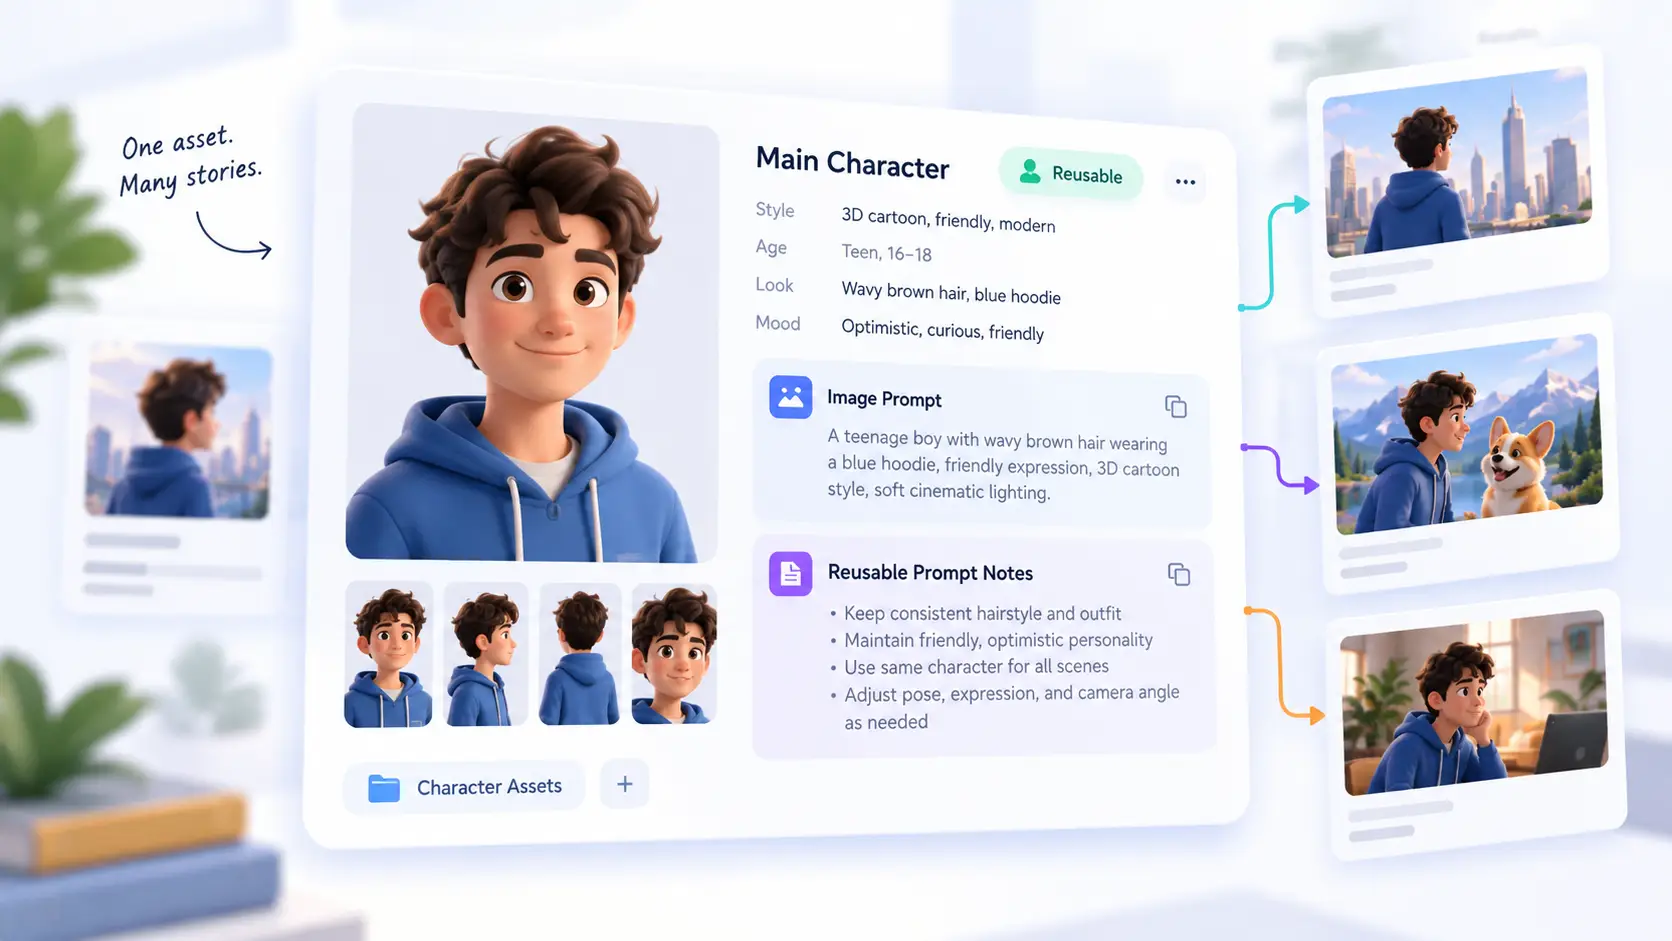
例如同一个女主角,第一个镜头用了正面角色图,第二个镜头临时找到另一张半身图,第三个镜头又换了一张服装稍微不同的图片。即使它们看起来“差不多是同一个人”,对模型来说,也已经增加了不确定性。所以做多个镜头时,一个更稳定的做法,是先确定主要角色的参考资料,然后让后面的镜头持续使用同一套资产。
如果你想进一步了解角色一致性,可以查看AI视频如何保证角色一致性
场景也是一样
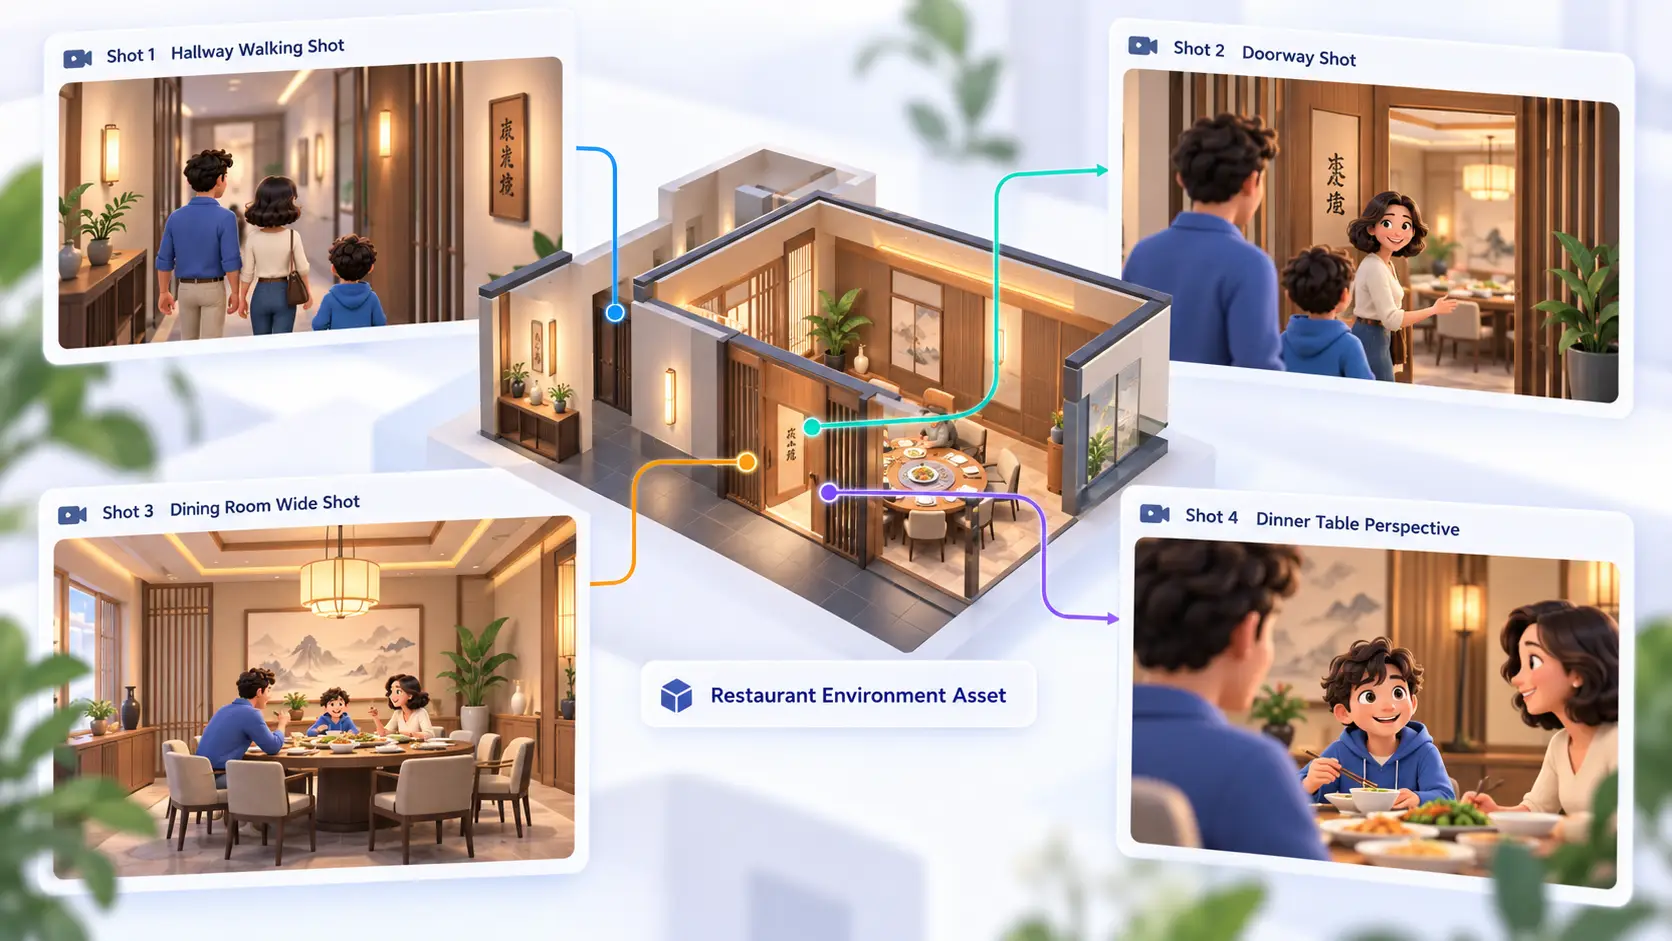
角色容易被注意到,场景的问题反而经常被忽略。比如故事发生在同一家餐厅。第一个镜头是走廊,第二个镜头进入包间,第三个镜头切到餐桌,第四个镜头又回到门口。如果每一个镜头都重新描述:“高级中式餐厅,暖色灯光,木质装修……”。最后生成出来的空间很可能每一镜都不一样。所以当一个场景会反复出现时,更好的方式不是每次重新描述,而是把它当成一个持续使用的场景资产。同样的逻辑也适用于办公室、卧室、客厅、便利店、街道等反复出现的地点。
道具少的时候不重要,多起来以后一样会乱
道具通常是最容易被忽略的一类资料。一个普通杯子当然不需要专门管理。但如果故事里的某件东西会反复出现,甚至推动剧情,它就开始变成需要稳定的资产。例如:一只特定的手机、一个礼物盒、一块月饼、一个文件袋、一件关键证物。
如果前几个镜头已经明确了它的外观,后面突然换了颜色、形状或者大小,画面连续性就会开始出问题。所以资产管理并不是“所有东西都保存”。真正值得管理的是那些会反复出现,而且变化会影响故事连续性的东西。
真正麻烦的是镜头一多以后
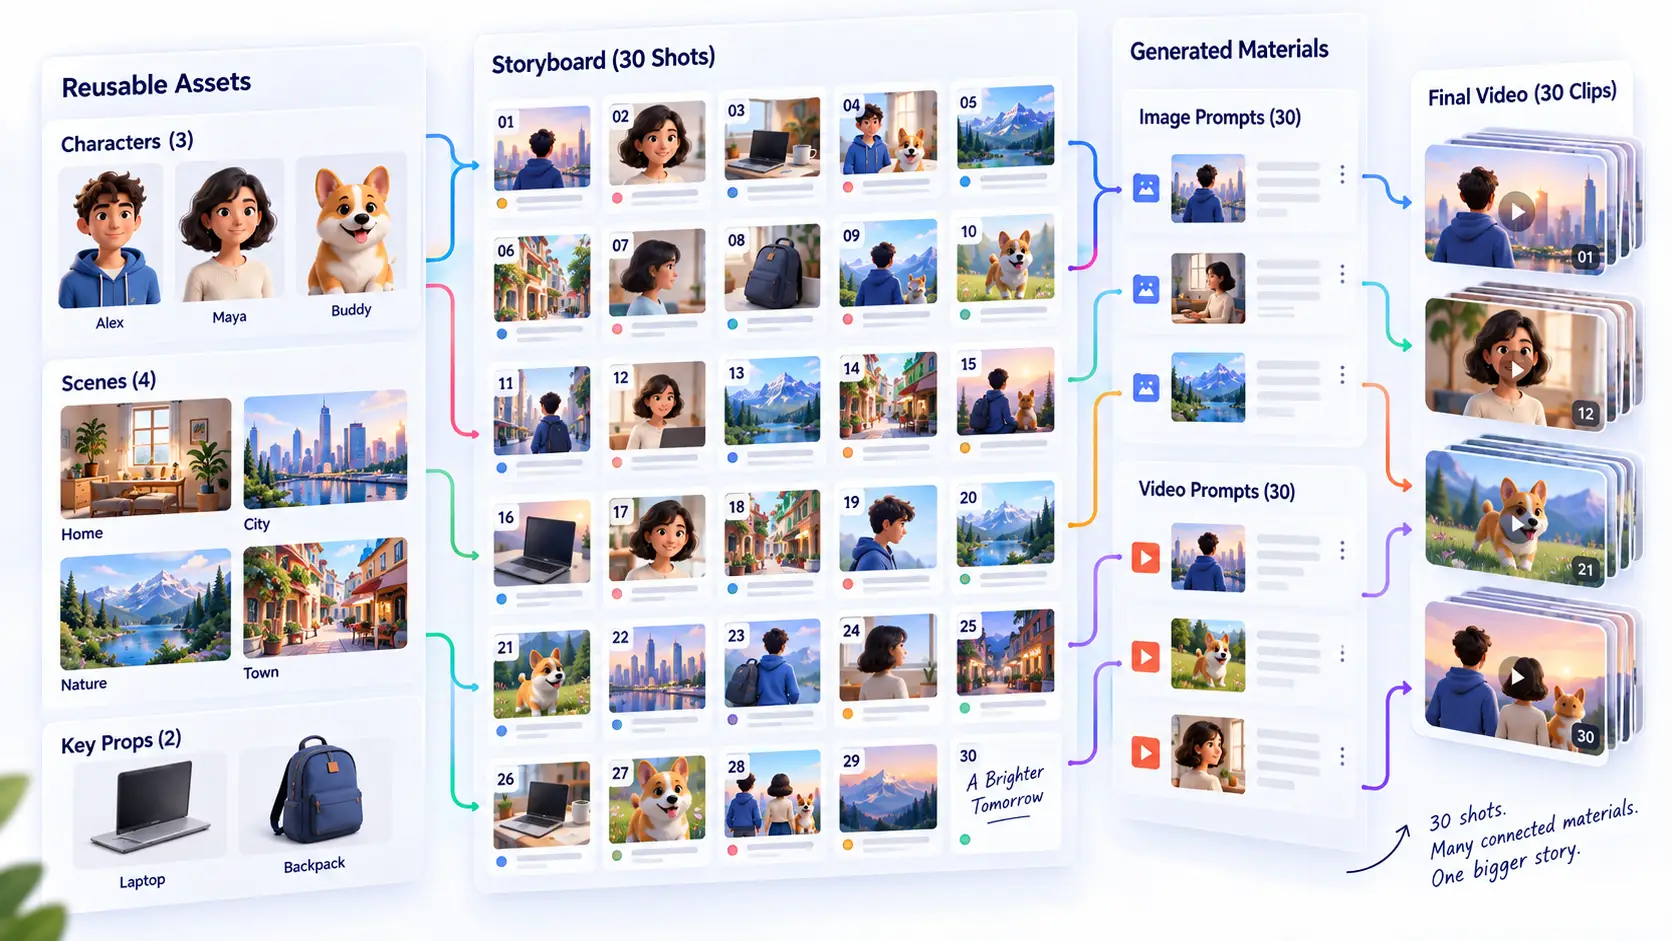
假设一个故事有 30 个镜头。里面有 3 个主要角色、4 个主要场景、2 个关键道具。光这些基础资产,就已经有 9 个。再加上每个镜头自己的分镜脚本、生图提示词、视频提示词、参考图,实际需要管理的内容很快就会超过几十份。
这时候如果你还是靠文件夹、聊天记录和临时复制粘贴来找资料,会出现一个很典型的情况:真正生成视频可能只需要几分钟,但找到这一镜应该上传哪些东西,却花了很久。这也是我最近越来越明显的一个感受:AI 视频的制作效率,正在从“谁会写提示词”,逐渐变成“谁能把整个制作资料组织起来”。
我现在更习惯先把故事拆成一套可以复用的资料
这里的“先”,并不是说一定要在做分镜之前,手动把所有角色和场景全部准备好。实际上更适合我的流程是:故事先进入分镜阶段。在拆分镜的同时,把故事里的主要角色、场景和道具一起整理出来。然后再为真正重要、会反复出现的资产准备参考图。这样做完以后,每一个镜头需要的资料,就可以从已有资产里继续调用。例如一个很简单的故事:
男生第一次带女朋友去参加家庭聚餐。故事开头,两个人在饭店走廊边走边聊天。打开包间门以后,发现里面已经坐了一大桌家人。这个故事并不复杂,但如果真的开始制作,至少会有:男生角色、女朋友角色、饭店走廊、家庭包间。如果后面还有送礼物的情节,可能还会有一个重要道具。这些东西确定以后,后面的镜头就不需要每一镜重新描述一遍。
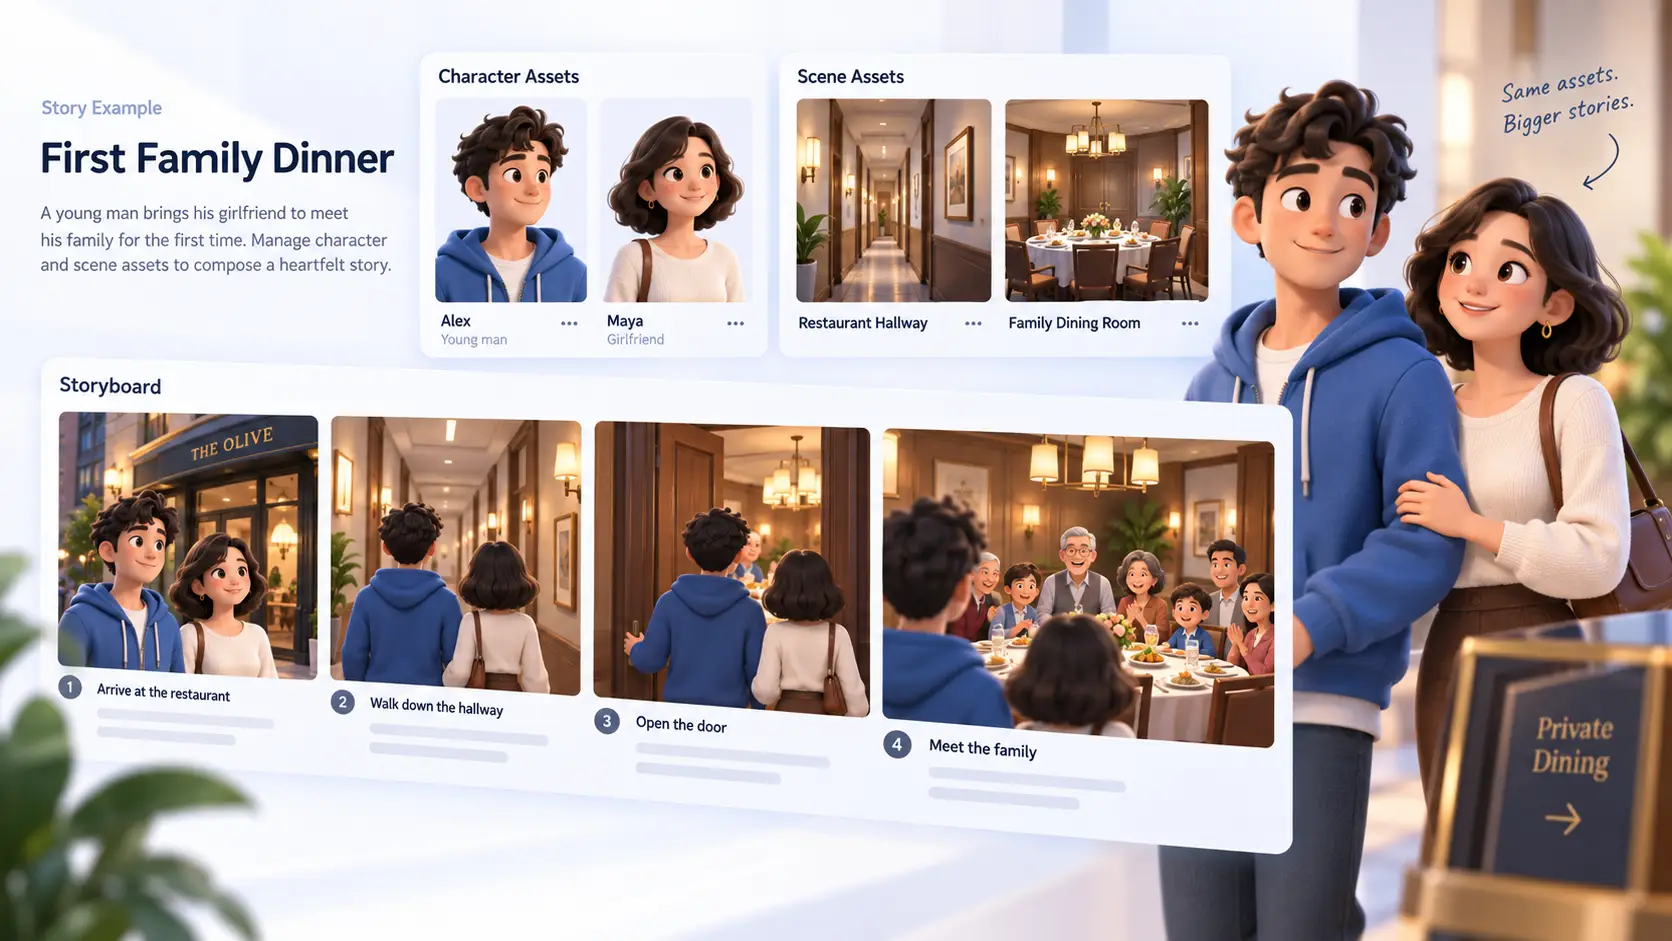
如果你想看小镜故事板是怎么整理这些内容的,可以查看文章如何使用角色、场景和道具资产库?
资产库的价值,不只是存图片
说到资产库,很容易把它理解成一个“图片文件夹”。但真正有用的资产,应该不只是图片。一个角色资产,可能同时包含人物描述、角色参考图和生图提示词。一个场景资产,也可能包含场景描述、参考图以及后续需要复用的提示词。而到了具体镜头,还会继续产生对应的视频提示词和分镜资料。这样一个资产才真正有复用价值。
因为下一次做镜头时,你不是重新从零开始,而是在已有资料上继续工作。
AI 视频以后可能越来越像一个制作系统
现在很多 AI 视频工具的重点还是“生成”。上传图片,写提示词,然后点击生成。但当内容越来越长以后,我觉得整个工作流会越来越像传统的视频制作系统。不是只有生成这一步,而是:
先整理故事。再拆镜头。再整理角色、场景和道具。然后让每一个镜头调用对应资料去生成。生成完成以后,再继续进入下一镜。
真正重要的是这些资料之间的关系能够一直保留下来,而不是每完成一镜,就重新从头准备下一镜。所以我现在越来越觉得,AI 视频真正往长内容走以后,最后拼的可能并不是谁手里的模型更强。模型当然重要。但模型决定的是一个镜头能不能生成得漂亮。资产管理决定的,是几十个镜头能不能顺利做下去。
最后
如果你现在只是偶尔生成一个几秒钟的视频,资产管理可能还没有那么明显。但只要开始做连续故事、多角色、多场景和几十个镜头,这个问题迟早都会出现。角色图、场景图、道具图、分镜、提示词,这些东西单独看都不复杂。真正复杂的是它们开始同时出现以后,你还能不能清楚地知道:这一镜到底该用什么。
我觉得这会成为接下来 AI 视频制作里一个越来越重要的能力。