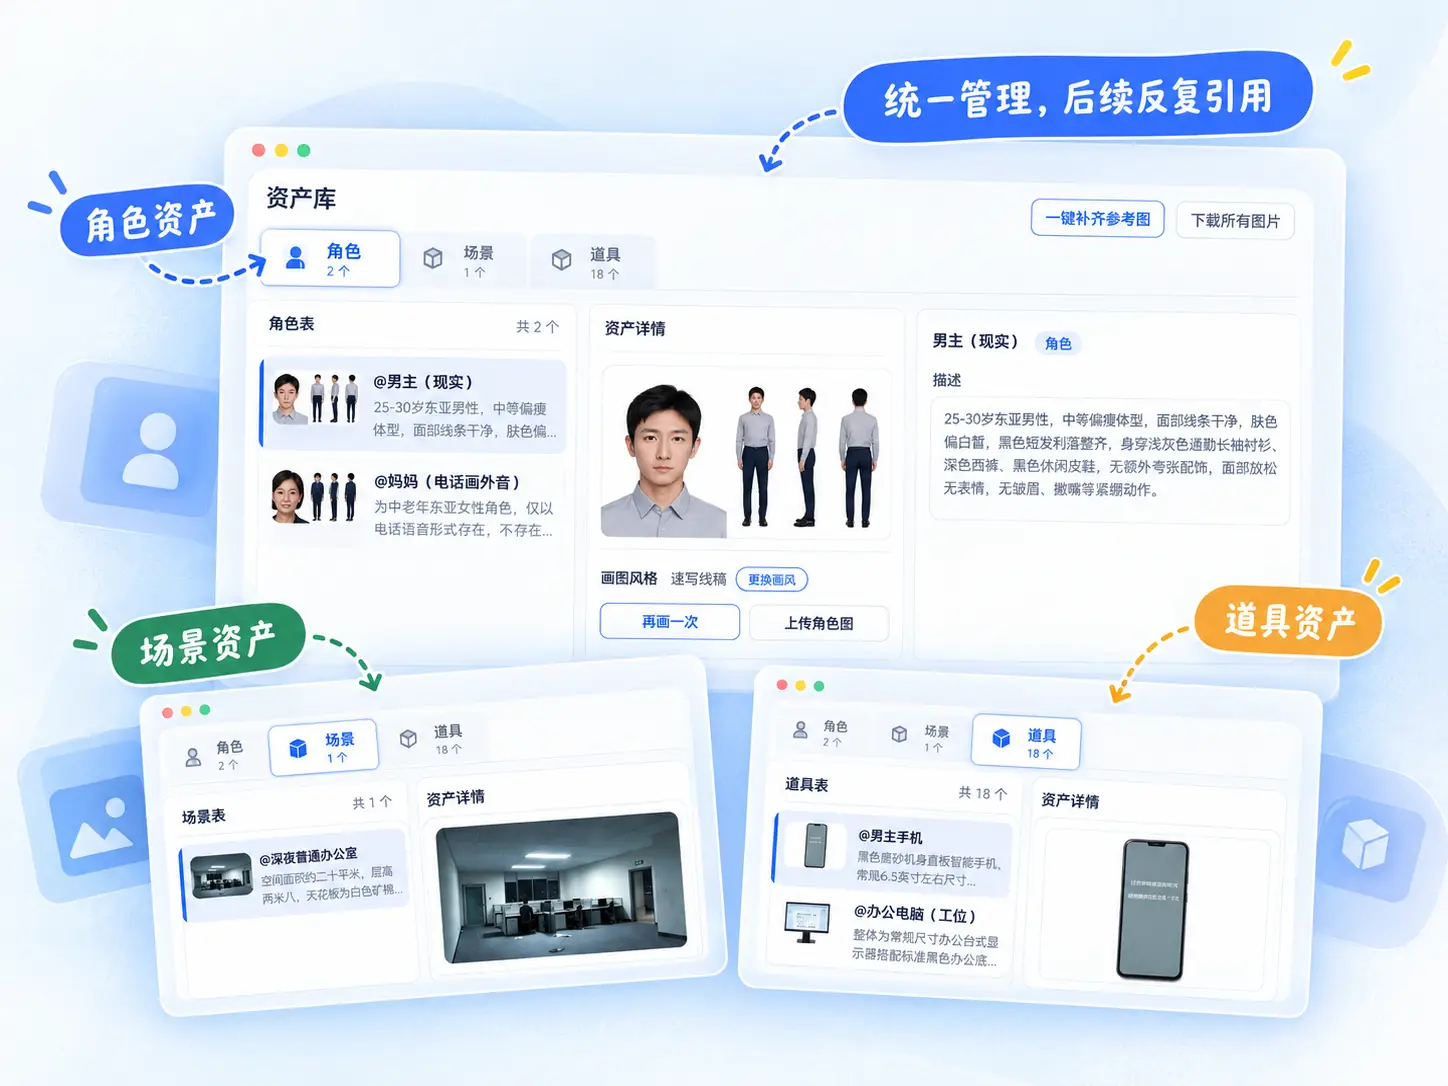
如果只是一个人物、一个场景、几秒钟的简单镜头,这样做当然可以。但当视频开始出现固定角色、固定场景、关键道具,甚至连续几十个镜头以后,真正麻烦的事情就变成了:这一镜应该用哪张角色图?场景是不是上一镜那个?某个重要道具需要不要继续出现?提示词里面提到的人物,应该对应哪一张参考图?所以从分镜到 AI 视频,中间其实还有一个“资料准备”的过程。
如果你已经有了分镜脚本,但还不确定做 AI 视频前还要继续补哪些资料,比如角色资产、场景资产、关键道具、参考图、生图提示词和视频提示词,可以继续看这篇更具体的文章:《已有分镜脚本还不够:做 AI 视频前还要补齐哪些资料?》。
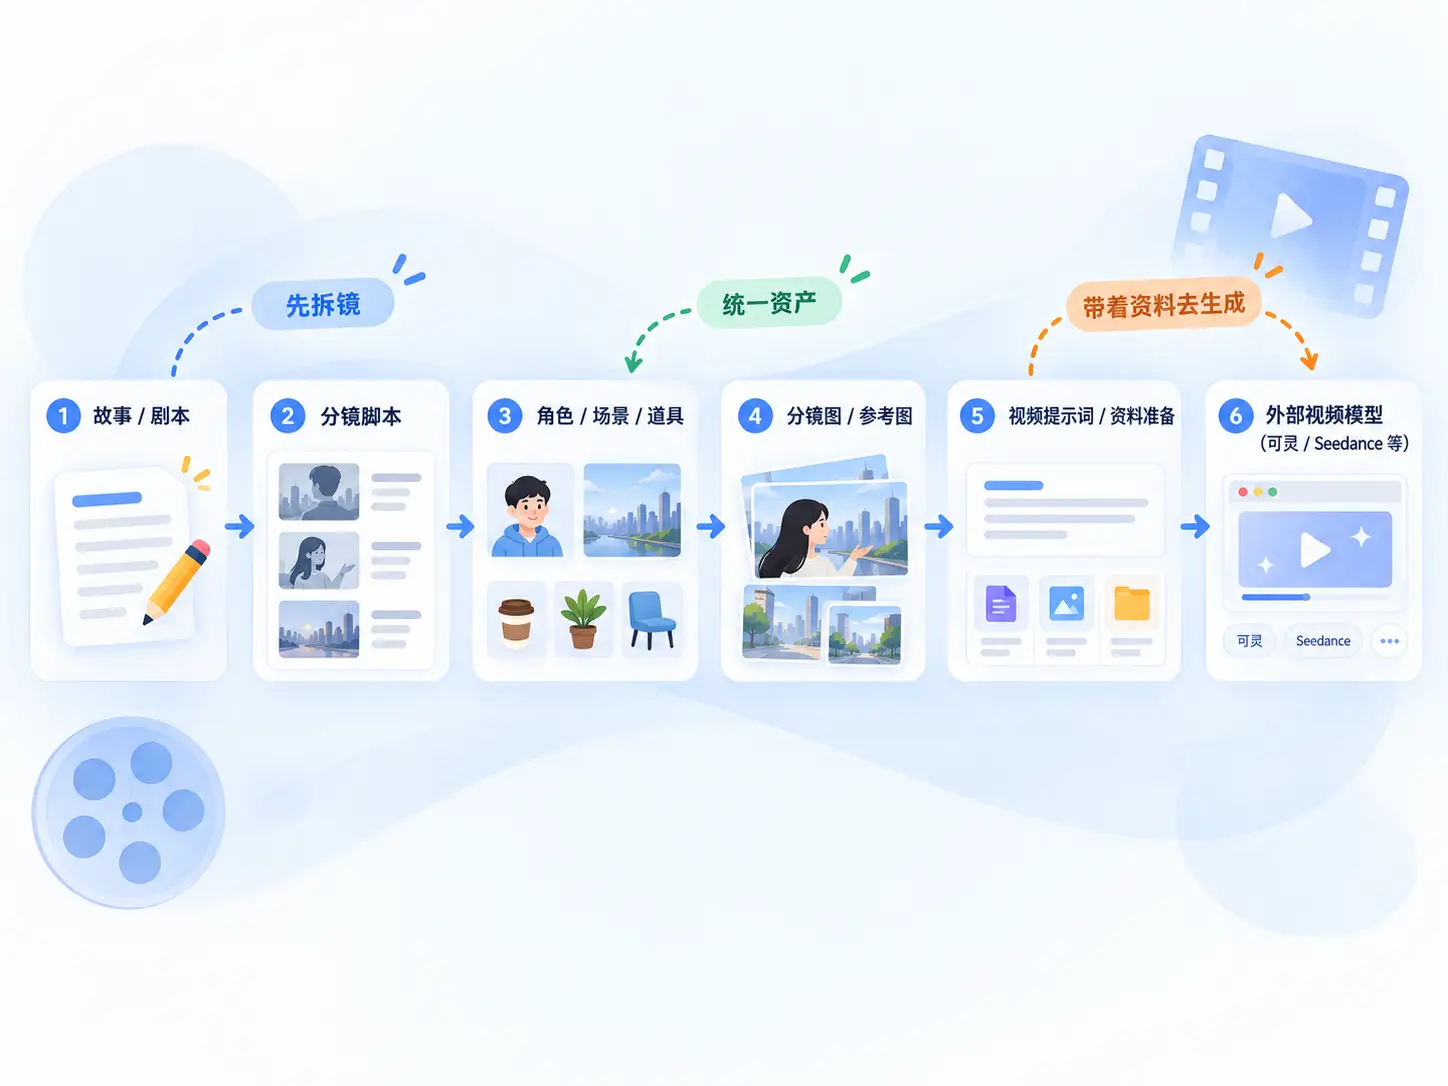
我现在比较常用的流程,大致可以分成六步:
故事或剧本 → 拆成分镜 → 整理角色、场景、道具 → 准备参考图 → 生成每一镜的视频提示词 → 到可灵、Seedance 等视频模型生成。真正决定效率的,往往不是最后点“生成视频”的那一步,而是前面的资料有没有整理好。
一、第一步不是生成视频,而是先把分镜拆清楚
假设原始故事里有这样一段:深夜,办公室只剩男主一个人在加班。桌上的手机突然亮起,屏幕显示“妈妈”。他盯着屏幕几秒,接起电话。妈妈问:“十一回来吗?”男主抬头看了一眼电脑,说:“最近有点忙……春节吧。”
如果直接把这一整段交给视频模型,模型需要同时理解办公室、手机来电、人物动作、对白、镜头变化和情绪变化,控制难度会非常高。更稳妥的做法,是先把它拆成几个独立镜头。
例如第一镜拍男主坐在工位前,第二镜拍手机来电,第三镜拍男主接电话,第四镜再拍他说出那句“春节吧”。这时候,每一镜需要知道的不只是“画面是什么”,还包括时长、景别、运镜、拍摄角度、场景、角色和台词。
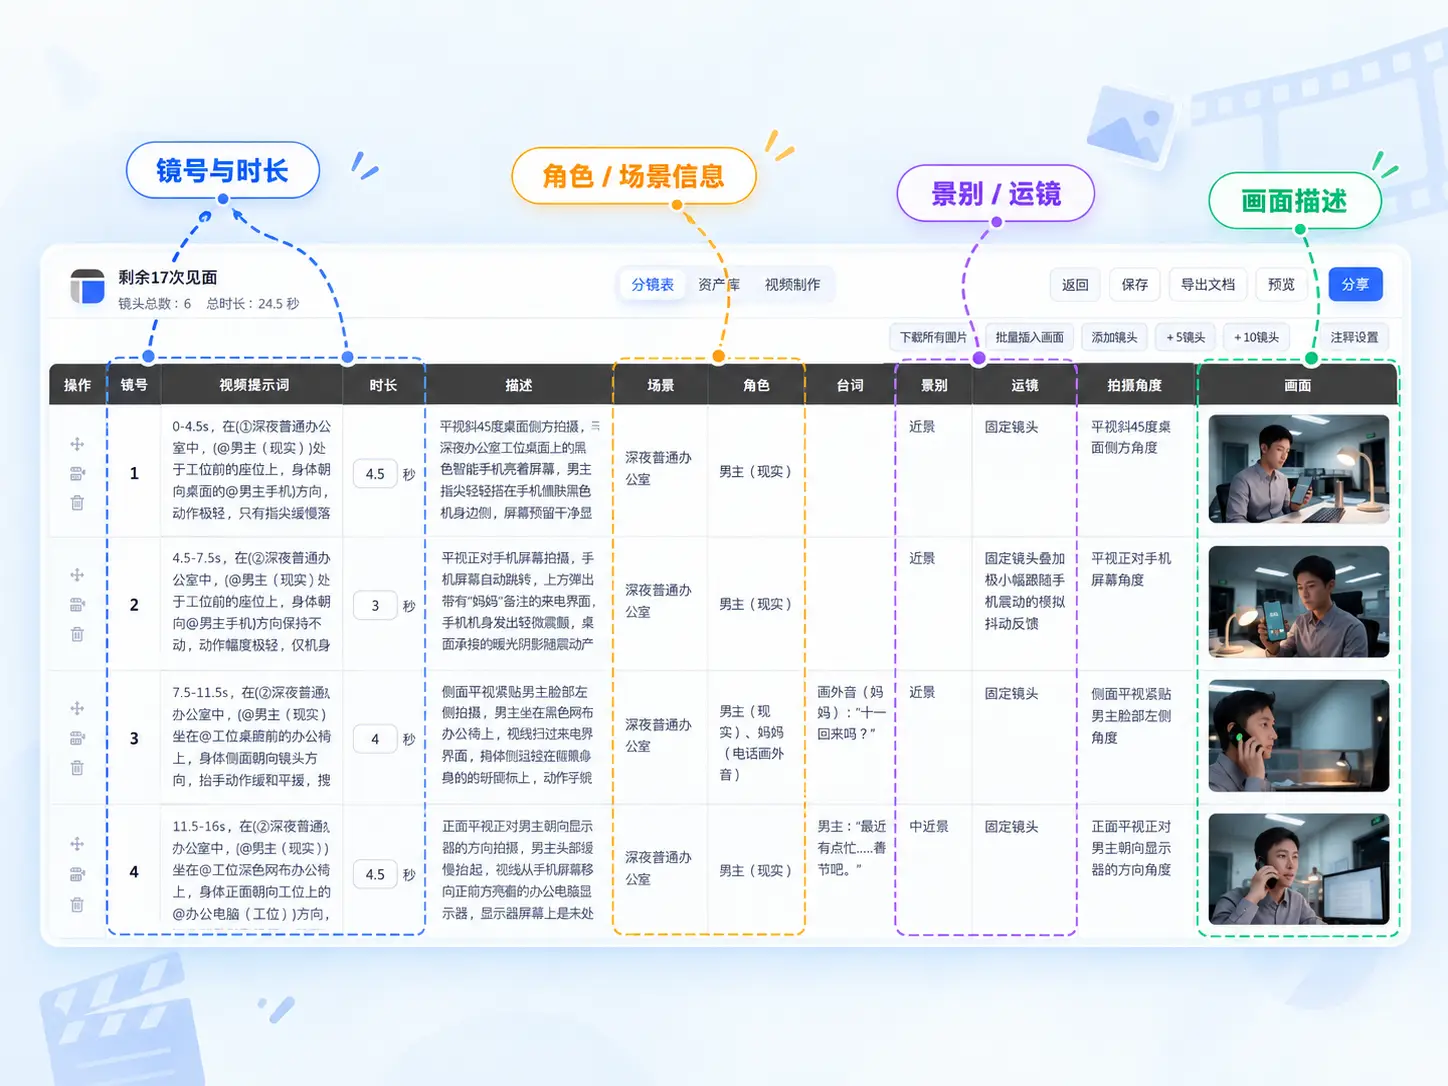
这也是为什么我现在不会只让 AI 输出一堆类似“镜头1、镜头2”的文字。真正进入 AI 视频制作以后,分镜最好是结构化的。你至少应该能够很快知道:现在做到第几镜,这一镜几秒,用什么人物,在什么场景里,要完成什么动作。如果还没有分镜,可以先通过小镜故事板的 AI 分镜功能,把小说、剧本或故事拆成一版可以继续编辑的分镜脚本,再往后进入图片和视频制作。
二、镜头多了以后,要先整理角色、场景和道具
很多 AI 视频前几镜看起来都还不错,做到后面却越来越乱,一个很常见的原因就是没有提前整理资产。比如前面的男主是黑色短发、灰色衬衫,到了第十镜重新生成时,只写了一句“一个年轻男人坐在办公室”,人物长相就可能已经发生变化。
场景也是一样。你第一次写“深夜办公室”,第二次写“公司工位”,第三次写“现代办公室”,对人来说都知道这是同一个地方,但模型未必会完全按照同一个空间去理解。所以我会提前把需要反复出现的内容拆成三类:角色、场景和道具。
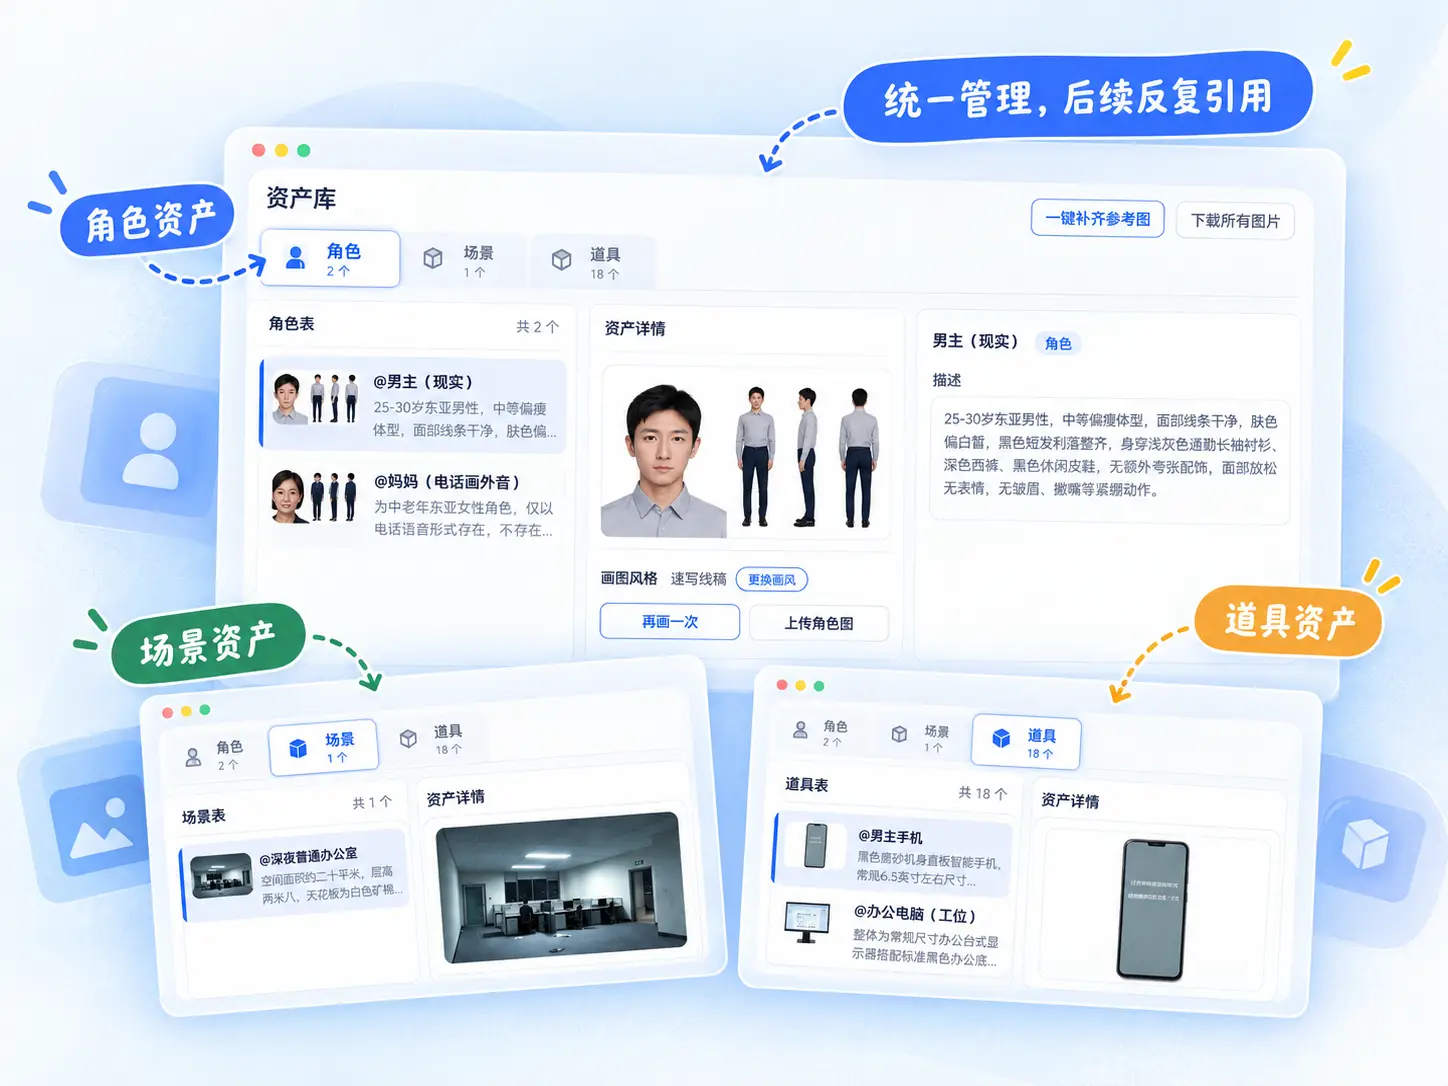
角色里放男主的形象和描述,场景里放办公室,道具里放手机、键盘、保温杯或者剧情中必须保持一致的物品。这样后面的每一镜不是重新描述一遍人物是谁,而是在引用已经确定好的角色和场景。镜头越多,这一步的价值越明显。
三、简单镜头可以直接文生视频,复杂镜头更适合带参考图
资料准备好以后,就可以决定这一镜用什么方式生成。如果镜头非常简单,比如“一只猫趴在窗边晒太阳”,人物一致性、场景连续性都不重要,那么直接用文生视频最快。
但如果是连续剧情,我一般会更倾向于加入参考图。比如这一镜要求男主坐在之前已经确定的办公室里,桌面必须出现同一部手机,那么光靠文字描述就很容易产生变化。这时候可以把角色图、场景图或者道具图一起交给视频模型。
如果模型支持多参数或者多参考图输入,就可以进一步明确:哪张图是男主,哪张图是办公室,哪张图是手机。这样模型不是完全从文字猜画面,而是在已经准备好的视觉资料上继续生成。
四、每一镜都要准备自己的视频提示词和参考资料
这一步也是镜头一多以后最容易乱的地方。假设现在做到镜号 17,你需要的可能是男主角色图、办公室场景图、手机道具图,再加上这一镜对应的视频提示词。到了镜号 18,又可能换成另外一个场景,角色不变,但道具变了。
如果这些资料全部散落在电脑文件夹、聊天记录和各种生成页面里,你会花很多时间在“找东西”上。所以我们后来在小镜里做的,并不是直接替用户生成最终视频,而是把每一镜后续制作需要的资料放到一起。
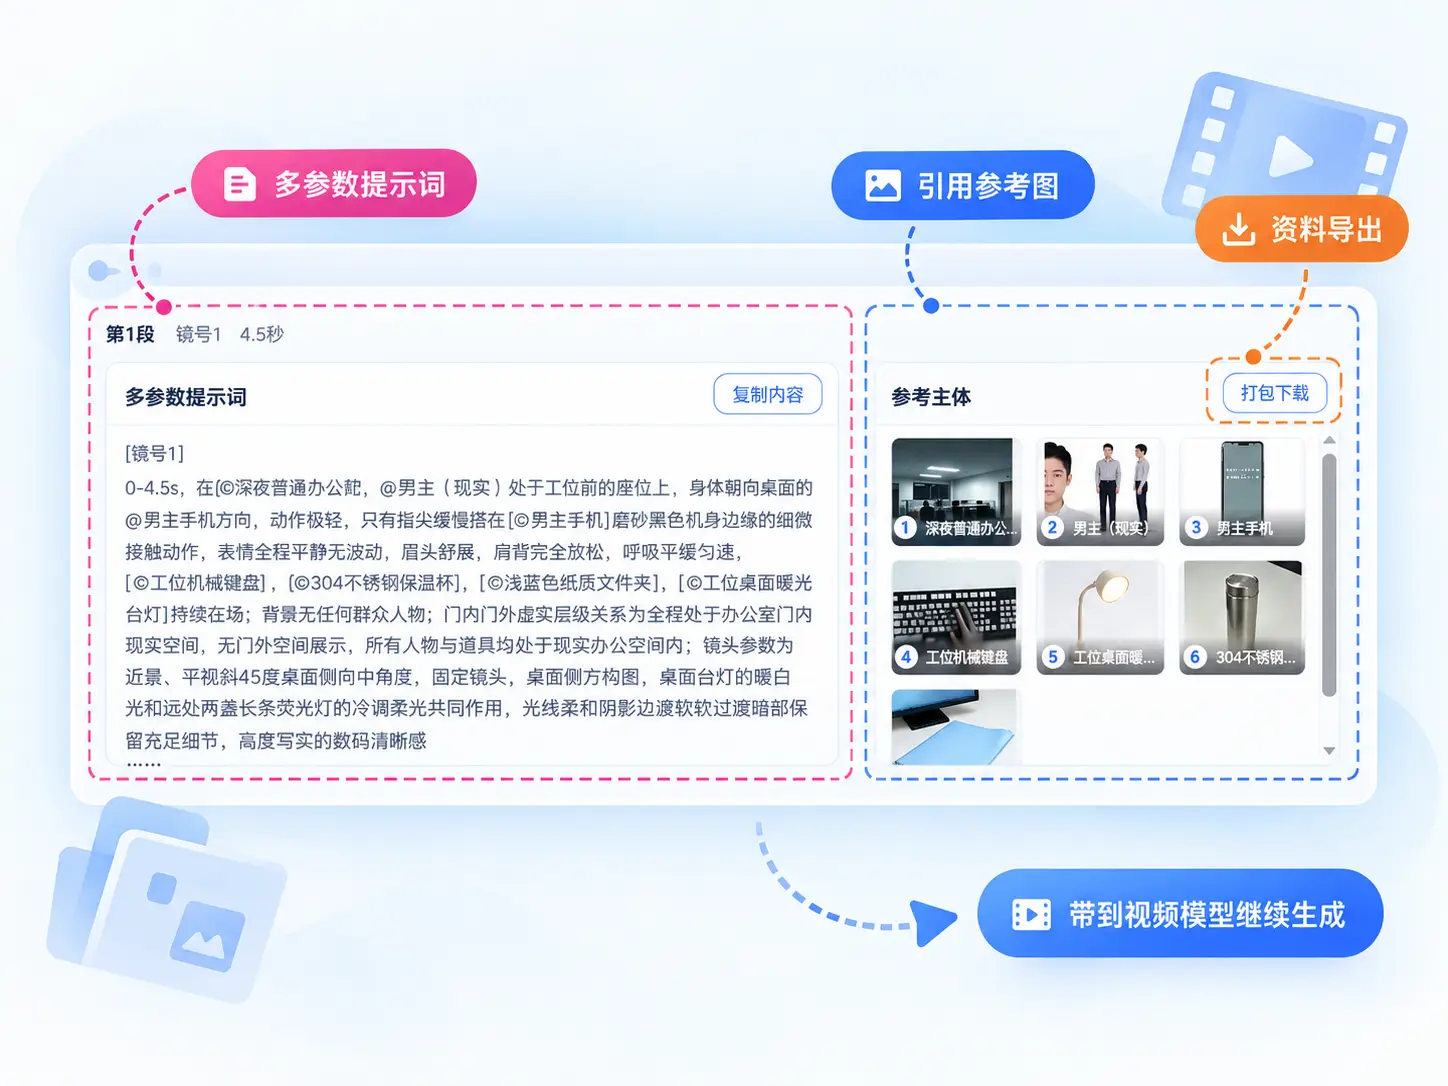
例如某一镜里,会直接看到这一段视频使用的多参数提示词,以及需要引用的角色、场景和道具参考图。这样你进入可灵或者 Seedance 的时候,就不需要重新回头翻分镜、找角色、找场景,再自己拼一次资料。
五、把资料带到可灵以后,实际操作并不复杂
资料整理完成以后,后面的动作反而比较顺。以我目前常用的流程为例,先把这一镜需要的角色、场景和道具图片下载下来,然后复制对应的视频提示词。进入可灵以后,把这些图片上传,并分别给它们命名。比如:
男主、深夜办公室、男主手机。
然后把小镜整理好的提示词粘贴进去,让提示词里的角色和场景名称对应刚才上传的参考素材,再调整这一镜的视频时长,最后生成。
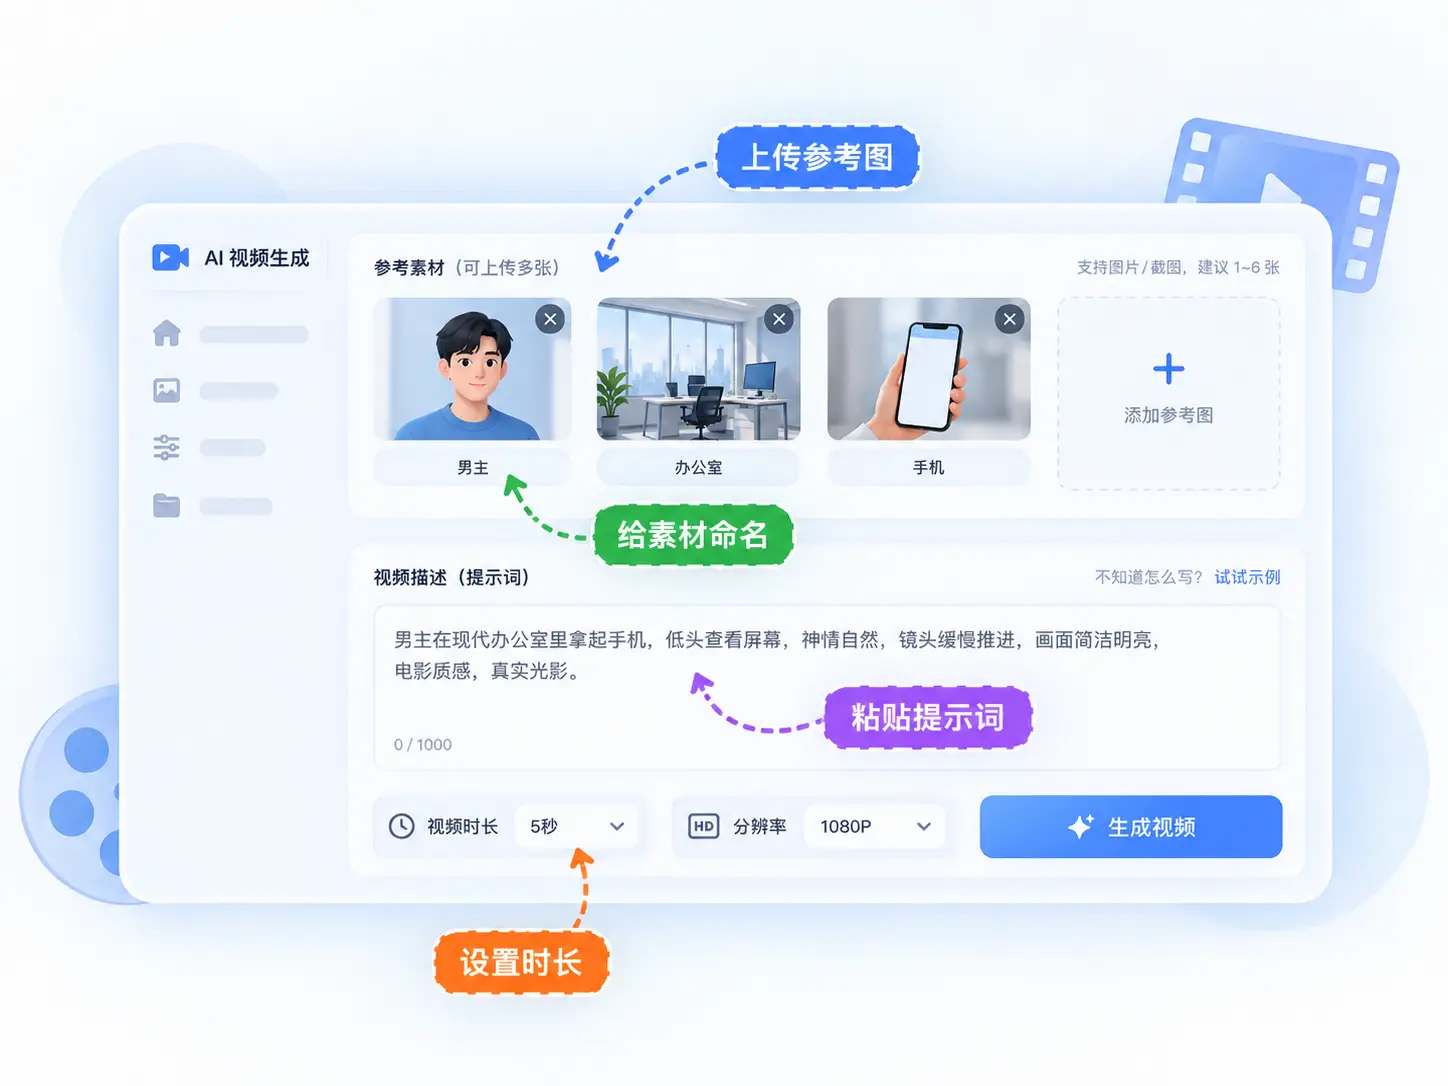
如果下一镜还是同一个男主和同一个办公室,就继续复用已经准备好的资产,只更换这一镜真正发生变化的内容。从操作上来说,这并不复杂。真正影响制作速度的,是你在打开可灵之前,有没有已经搞清楚“这一镜到底要用什么”。
六、为什么镜头越多,越不能只靠 Prompt
一两个镜头的时候,最简单的方法当然是直接和大模型聊天:“帮我写一个视频提示词。”
完全没问题。
但如果是 30 镜、50 镜甚至更长的 AI 漫剧,问题会慢慢发生变化。你不再只是问“这一镜怎么写”。而是会开始问:这个角色前面到底穿什么?这里是不是之前那个办公室?这部手机前面长什么样?第 27 镜需要哪几张参考图?这段提示词对应的是哪个镜头?上一镜和下一镜之间应该怎么衔接?
做到这里你会发现,AI 视频生产到最后,很大一部分效率其实来自资料管理。提示词当然重要,但提示词只是其中一项资料。角色图、场景图、道具图、分镜脚本、参考图以及每一段视频对应的参数,最后都会不断增加。这也是为什么我现在更倾向于先把这些东西整理好,再进入视频模型。
七、一套更省事的分镜转 AI 视频流程
如果把整套流程重新压缩一下,其实就是:先把故事拆成明确的镜头,再提前准备会反复出现的角色、场景和道具。简单镜头可以直接使用文字生成,涉及固定人物、固定空间或关键道具时,就加入参考图。然后为每一镜整理好视频提示词和所需素材,最后把这些资料带到可灵、Seedance 等视频模型里生成。
这样做并不能保证每一条视频一次就成功。AI 视频还是会出现动作错误、人物变化、构图偏差等问题。但至少你每次修改的时候是在调整“这一镜”,而不是重新处理整套故事。对于只有几秒钟的视频,这套方法可能显得有点重。但当你开始制作几十个连续镜头以后,前面花在整理分镜和资产上的时间,往往会在后面一镜一镜生成视频的时候省回来。
如果你正在做小说转 AI 视频、AI 漫剧或者剧情短片,可以先把第一版分镜拆出来,再决定哪些镜头直接文生视频,哪些镜头需要角色、场景和道具参考。小镜故事板目前做的,就是把故事拆镜、角色场景道具整理、AI 作图以及后续 AI 视频所需的提示词和参考资料放进同一套工作流里。你可以先从一小段故事开始,跑完一次完整流程,再决定要不要把整部内容都按这种方式制作。