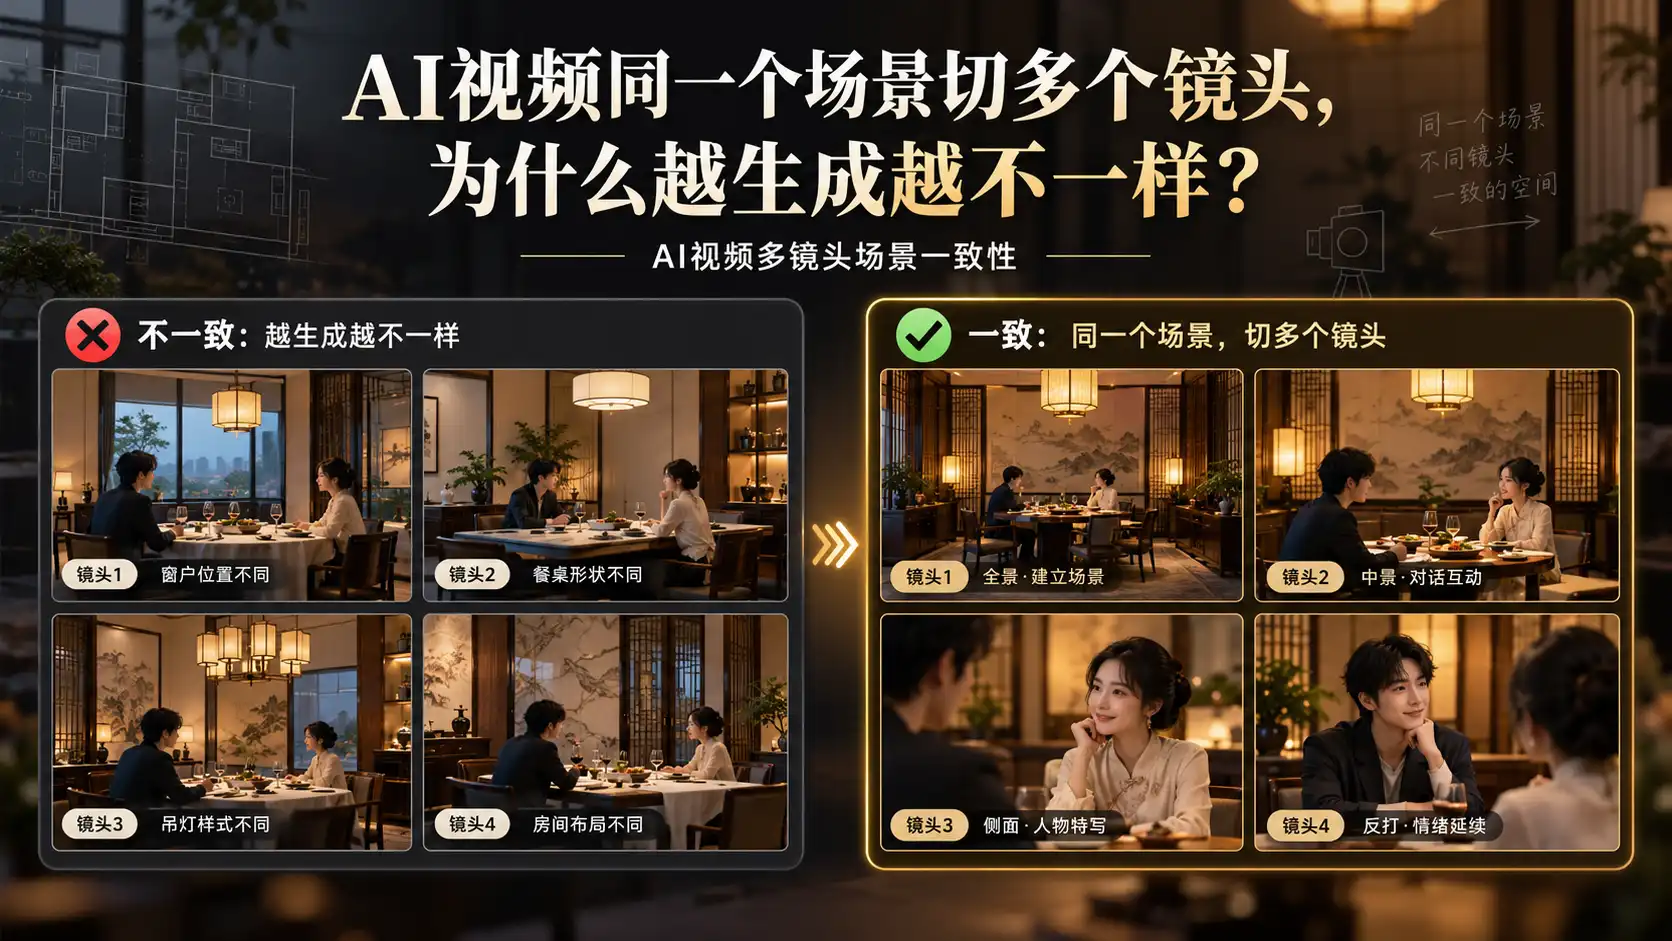
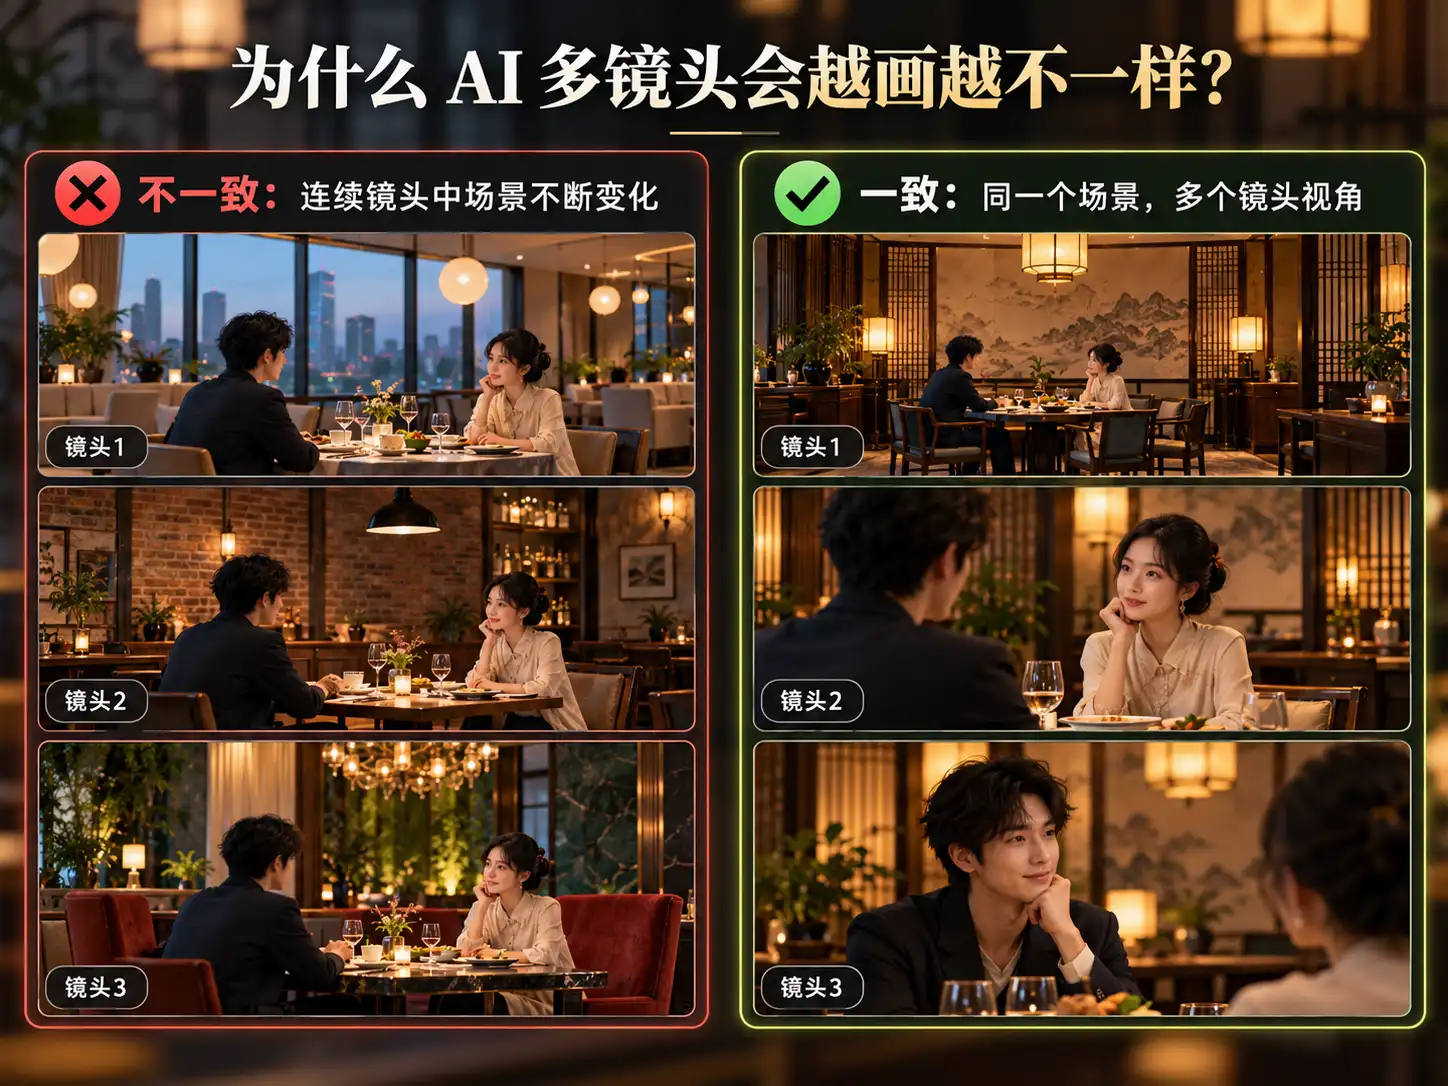
做 AI 视频时,经常会碰到一种很奇怪的问题。第一个镜头明明已经把场景画好了。同一个餐厅、同一个卧室、同一个办公室,继续往后生成第二镜、第三镜,场景却开始一点点变化。
第一镜窗户在人物背后。
第二镜窗户跑到了侧面。
第三镜桌子换了形状。
第四镜连吊灯、门的位置和墙面材质都不一样了。
每一张图单独看都可以成立。但放在一起以后,很明显已经不是同一个地方。这就是 AI 视频里非常典型的:同一场景多镜头不一致。
很多人第一反应是继续把提示词写得更详细。
“豪华餐厅包间,深色木桌,暖黄色吊灯,右侧落地窗……”
然后每一个镜头都重新把这段描述复制一遍。但问题往往并没有真正解决。因为真正的问题不是 AI 忘记了几个关键词,而是:你每生成一个新镜头,都在给它一次重新设计整个场景的机会。如果你遇到的是更宽泛的场景一致性问题,可以先看《AI视频如何保证场景一致性?》。
这篇我们只解决一个更具体的问题:同一个场景连续切多个镜头时,怎么尽量让它还是同一个地方。
先看一个最常见的例子
假设我们要做一段饭店包间里的对话。空间其实很简单:
一张圆桌。
男生坐在左侧。
女生坐在右侧。
后方是一面窗。
右边有包间门。
桌子上放着餐具和茶壶。
暖黄色灯光。
接下来设计四个镜头:
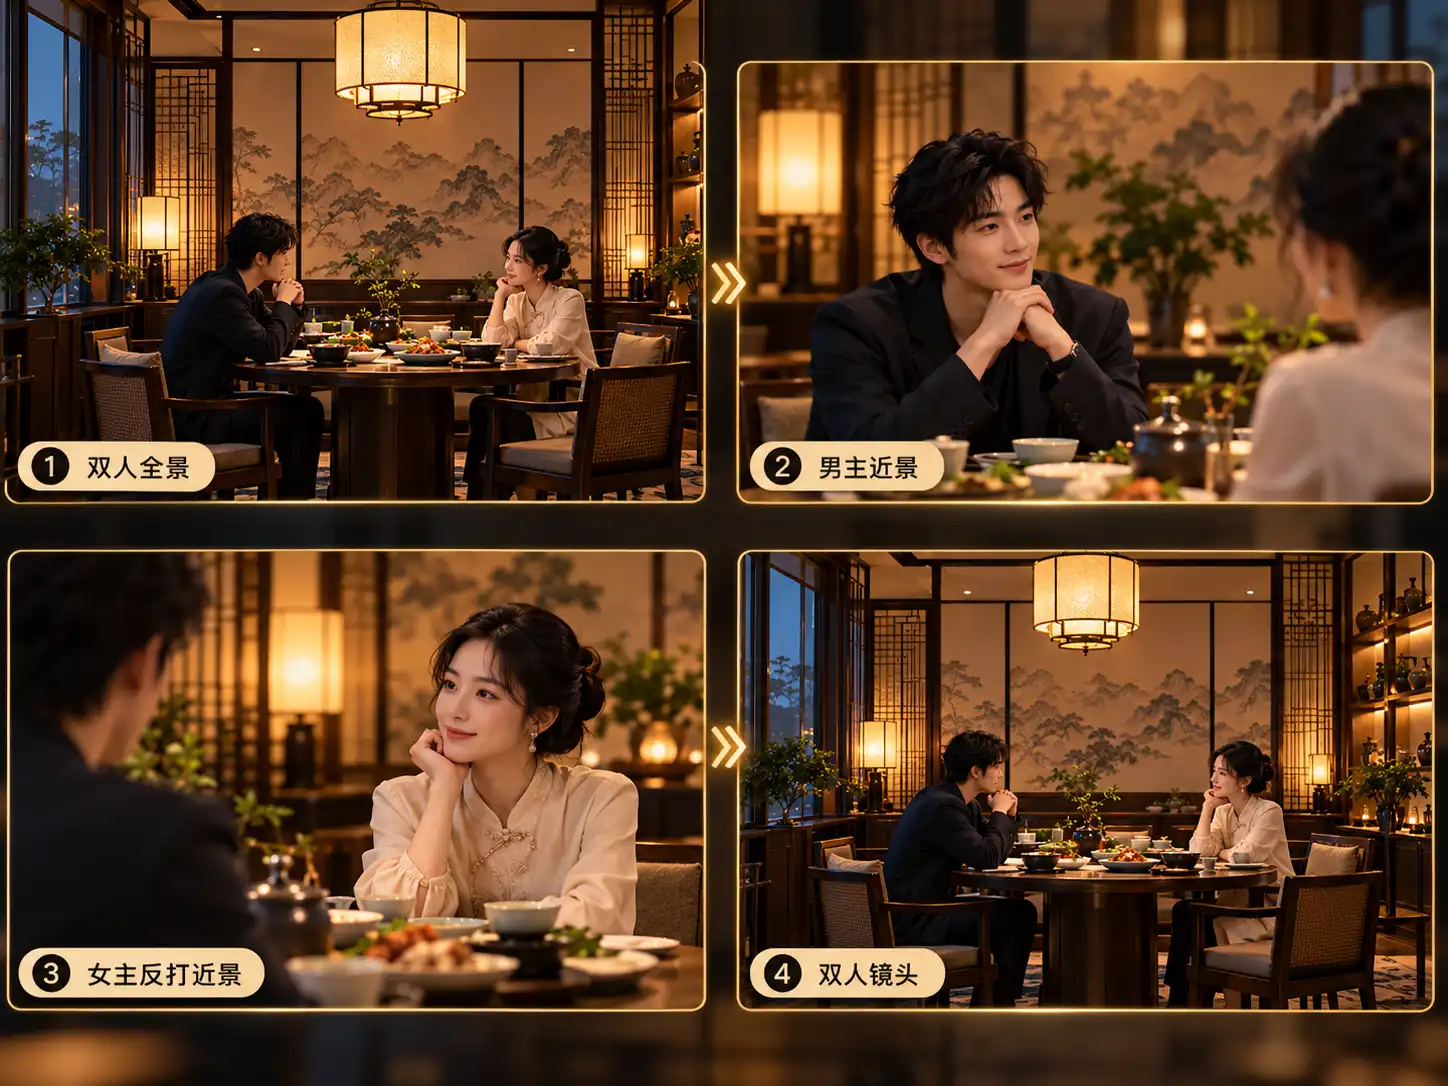
镜头 1:双人全景,先把整个空间交代清楚。
镜头 2:切男生近景。
镜头 3:切女生反打。
镜头 4:回到双人镜头,女生站起来。
从影视逻辑来看,这四个镜头只是:摄影机的位置、景别和人物状态发生变化。餐厅本身没有变。但如果每一镜都重新让 AI 根据文字生成:
“高级中式餐厅包间,两个人坐在圆桌旁,暖色灯光……”
模型完全可能把第二镜理解成:重新设计一间符合这些文字描述的餐厅。于是第二镜出现另一种椅子。第三镜墙面变了。第四镜窗户又跑到了另一边。这就是问题的根源。
多镜头一致性,第一步不是写镜头,而是固定场景
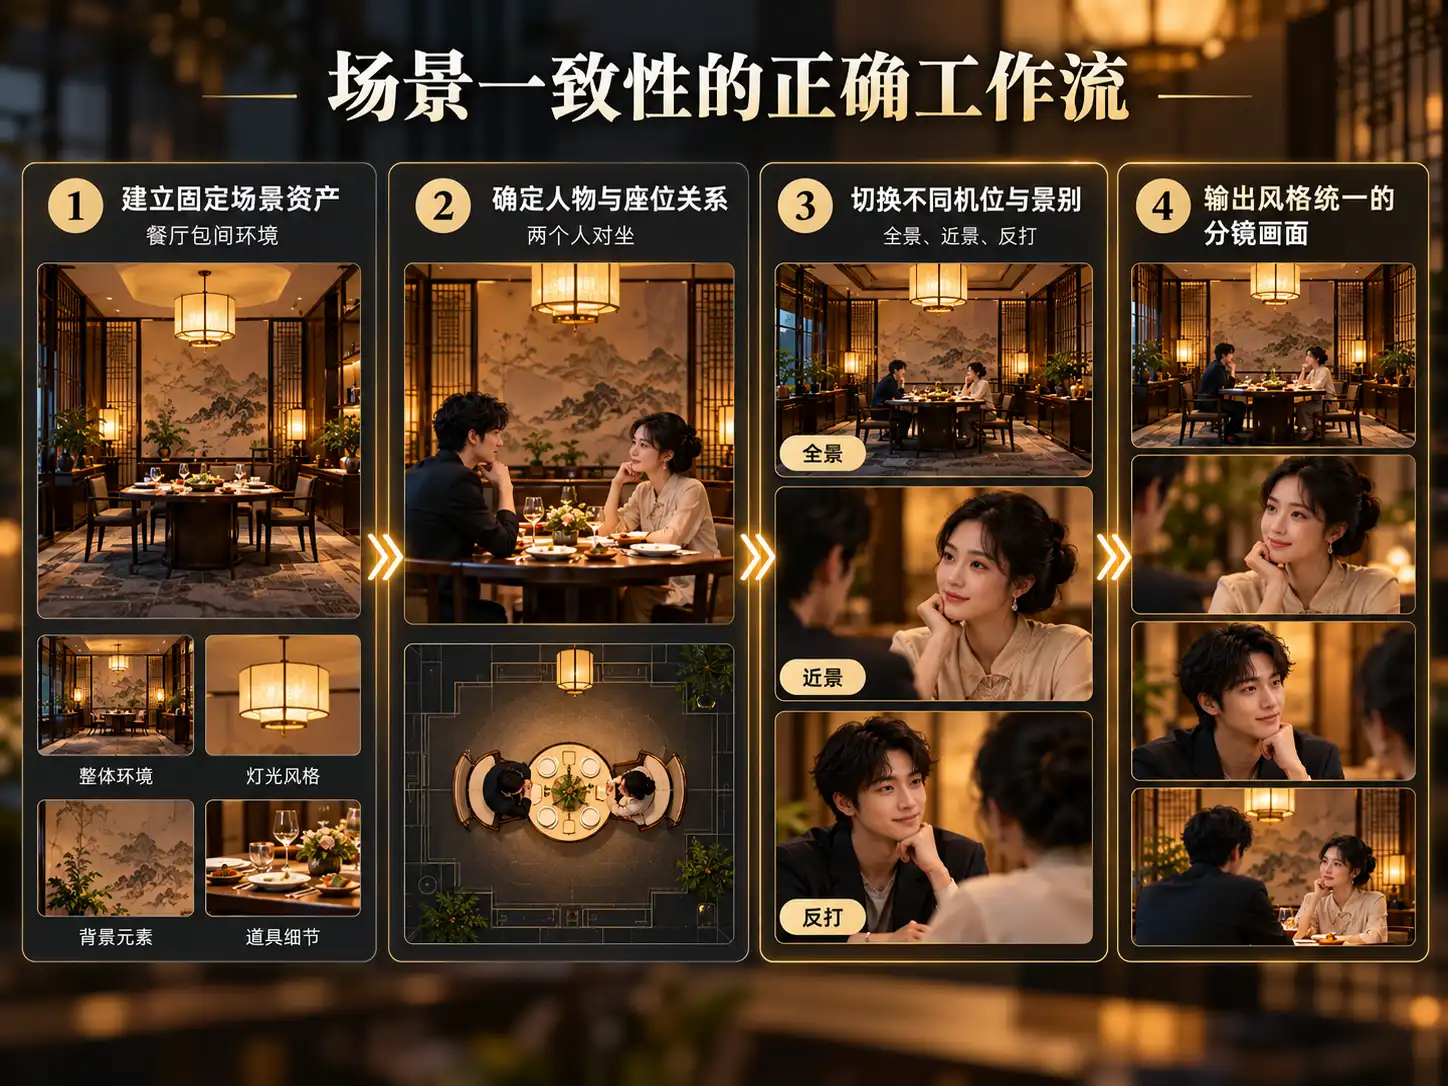
如果一个场景会连续出现很多镜头,我更建议先把它当成一个独立资产处理。也就是说,先确定:
这个地方到底长什么样。
主要家具在哪里。
门在哪里。
窗在哪里。
人物主要活动区域在哪里。
光线从什么方向来。
整体色调是什么。
哪些东西是这个场景里必须一直存在的。
以刚才的餐厅为例,至少可以先确定:
圆桌居中。
包间门位于右后方。
窗户位于左侧墙面。
桌子上固定有茶壶和餐具。
灯光为暖黄色。
墙面主要是深色木饰面。
这些东西一旦确定下来,后面的镜头就不应该每次重新设计。它们应该成为这个场景的“固定条件”。这也是场景资产真正有价值的地方。场景资产不是为了多存一张漂亮的图。而是为了告诉后面的所有镜头:故事现在还发生在这里。
每一个新镜头,应该只描述“这一镜发生了什么变化”
场景已经固定以后,镜头提示的重点就应该发生变化。不要每次都重新描述整个房间。
而是重点描述当前镜头真正变化的部分。例如:
镜头 1:双人全景,两人隔桌而坐,建立整个包间空间。
镜头 2:切男生近景,男生保持坐姿,看向画面右侧的女生。
镜头 3:切女生反打近景,女生看向画面左侧的男生。
镜头 4:回到双人镜头,女生起身离开座位。
这四个镜头里真正变化的是:
景别。
摄影机位置。
人物动作。
人物视线。
而不是:
桌子重新长什么样。
窗户重新放在哪里。
房间重新装修成什么风格。
所以一个很重要的原则是:场景负责固定,镜头负责变化。如果把两件事情都交给每一次新的生成,场景自然就会越来越飘。
参考图的作用,不只是“让画面长得像”
这时候,场景参考图就很重要。很多人理解参考图,只是觉得:
“我喜欢这张图的风格,所以拿来参考。”
但在多镜头制作里,更重要的作用其实是:
给后续镜头一个已经确定的视觉事实。
门就是在这里。
窗户就是在这里。
桌子就是这种形状。
整个房间就是这样的结构。
这样第二镜切近以后,即使画面只能看到房间的一部分,AI 仍然有一个稳定的场景依据。当然,参考图也不是万能的。如果第一张场景图只是一张很近的人物照片,背景本身都看不清楚,那它就很难承担“固定空间”的任务。所以如果一个场景会连续出现很多次,最好至少有一张能够比较清楚说明整个空间的场景参考。
关于角色、场景和站位构图分别应该怎么引用,可以继续看《AI画镜头时,如何引用角色、场景和站位构图?》。
机位变了,不代表空间关系可以跟着乱变
还有一个特别容易混淆的问题。很多人看到第二镜和第一镜不一样,会觉得:是不是不能换摄影机?当然不是。同一个场景完全可以有:
正面。
侧面。
反打。
俯视。
近景。
远景。
摄影机甚至可以移动。
真正需要保持的是:空间关系。例如男生和女生面对面坐着。
第一镜从侧面拍:男生在画面左边,女生在右边。
第二镜切到男生近景。
第三镜切到女生反打。
最终画面里的左右关系可能发生变化,但现实空间里两个人的位置并没有突然交换。门、窗、桌子之间的位置也没有发生变化。所以场景一致性并不是:每一镜必须看起来一模一样。而是:
无论摄影机移动到哪里,大家仍然处在同一个可以解释得通的空间里。
这也是为什么多人镜头继续复杂以后,光有场景参考图还不一定够。还需要知道人物在空间里的位置,以及摄影机到底站在哪里。如果你的主要问题已经不是“房间变了”,而是“人总是站错”,可以继续看《AI 视频多人镜头总是站错位置,怎么解决?》。
场景一致了,前后镜头仍然可能接不上
这里还要再区分一个问题。比如现在:
房间没变。
桌子没变。
窗户也没变。
人物的位置也基本正确。
但两个镜头剪在一起以后,还是觉得“跳”。那问题可能已经不是场景一致性,而是镜头连续性。例如:
上一镜男生已经站起来。
下一镜又重新坐着。
上一镜女生拿着杯子。
下一镜杯子突然回到桌面。
上一镜人物朝右走。
下一镜切换机位以后,看起来突然开始朝左走。
这些属于:前后镜头状态有没有接上。所以真正做一段连续 AI 视频,可以简单理解成三层:
- 第一层:场景要固定。还是不是这个房间。
- 第二层:人物空间关系要固定。谁在哪里。
- 第三层:前后状态要连续。上一镜发生了什么,下一镜从哪里继续。
三层同时成立以后,多镜头视频才会真正开始像一个连续发生的故事。关于第三层,可以继续看《AI视频镜头切换为什么总是跳?前后镜头连续性怎么控制》。
为什么反复复制同一段提示词还是不够
现在再回头看最开始那个方法,每一镜都写:
“高级中式餐厅,圆桌,暖黄色灯光,深色墙面……”
有没有帮助?有。它至少可以减少完全跑到另一个场景的概率。但它解决不了一个关键问题:
文字描述的是属性,不一定描述得清楚空间结构。
“有一扇窗”。
和:
“窗在人物左侧墙面,门在人物右后方”。
已经不是同一种信息。
更别说:
桌子与门相距多少。
人物坐在桌子的哪一边。
摄影机当前位于哪里。
这些很难只靠不断增加形容词解决。
所以当镜头越来越多时,真正需要的往往不是更长的提示词。而是更稳定的场景资料和更明确的空间关系。
在分镜阶段先确定这些,会省很多返工
多镜头场景最好不要等画完以后才发现:“怎么第三镜突然变成另一间房了?”在分镜阶段就可以先确定:
这一段剧情发生在哪个场景。
这个场景会持续多少个镜头。
哪些视觉元素必须固定。
人物最开始分别在哪里。
摄影机会从哪些方向拍。
人物接下来有没有移动。
然后再进入画图。这样你会更容易发现:
哪些东西应该继承。
哪些东西才是这一镜真正要变化的。
一个简单的多镜头场景检查方法
下一次你做同一个场景的多个镜头,可以先看这五件事。
- 场景身份有没有变:还是同一个餐厅、卧室或办公室吗?
- 固定物件有没有变:门、窗、桌椅、灯具的位置还能对得上吗?
- 人物关系有没有变:谁坐在哪里,谁站在哪里,有没有突然交换位置?
- 摄影机变化是否合理:只是换了拍摄位置和景别,还是整个房间也跟着重新设计了?
- 上一镜状态有没有被下一镜继承:动作、视线和道具有没有突然重置?
如果这五件事情能够基本保持,多镜头的一致性通常就会稳定很多。
最后
AI 做单个镜头越来越容易。真正开始困难的,是:
第二个镜头。
第三个镜头。
第四个镜头。
因为从第二镜开始,问题已经不再只是这一张图好不好看。而是它是不是仍然属于上一张图里的那个世界。所以同一个场景做多个镜头时,最重要的思路不是每一镜重新把场景描述得更详细。而是先建立一个稳定的场景,再让摄影机、人物和动作在这个场景里发生变化。场景不要跟着镜头一起重新生成。镜头才应该是变化的那一部分。