两个人对话时,分镜通常还比较容易处理:
一个人说话。
切另一个人的反应。
再切回来。
但人物一旦变成三个人,镜头很容易突然变乱。最常见的做法是:
A 说话,切 A 近景。
B 说话,切 B 近景。
C 说话,再切 C 近景。
接下来 A 又说话,再切回 A。
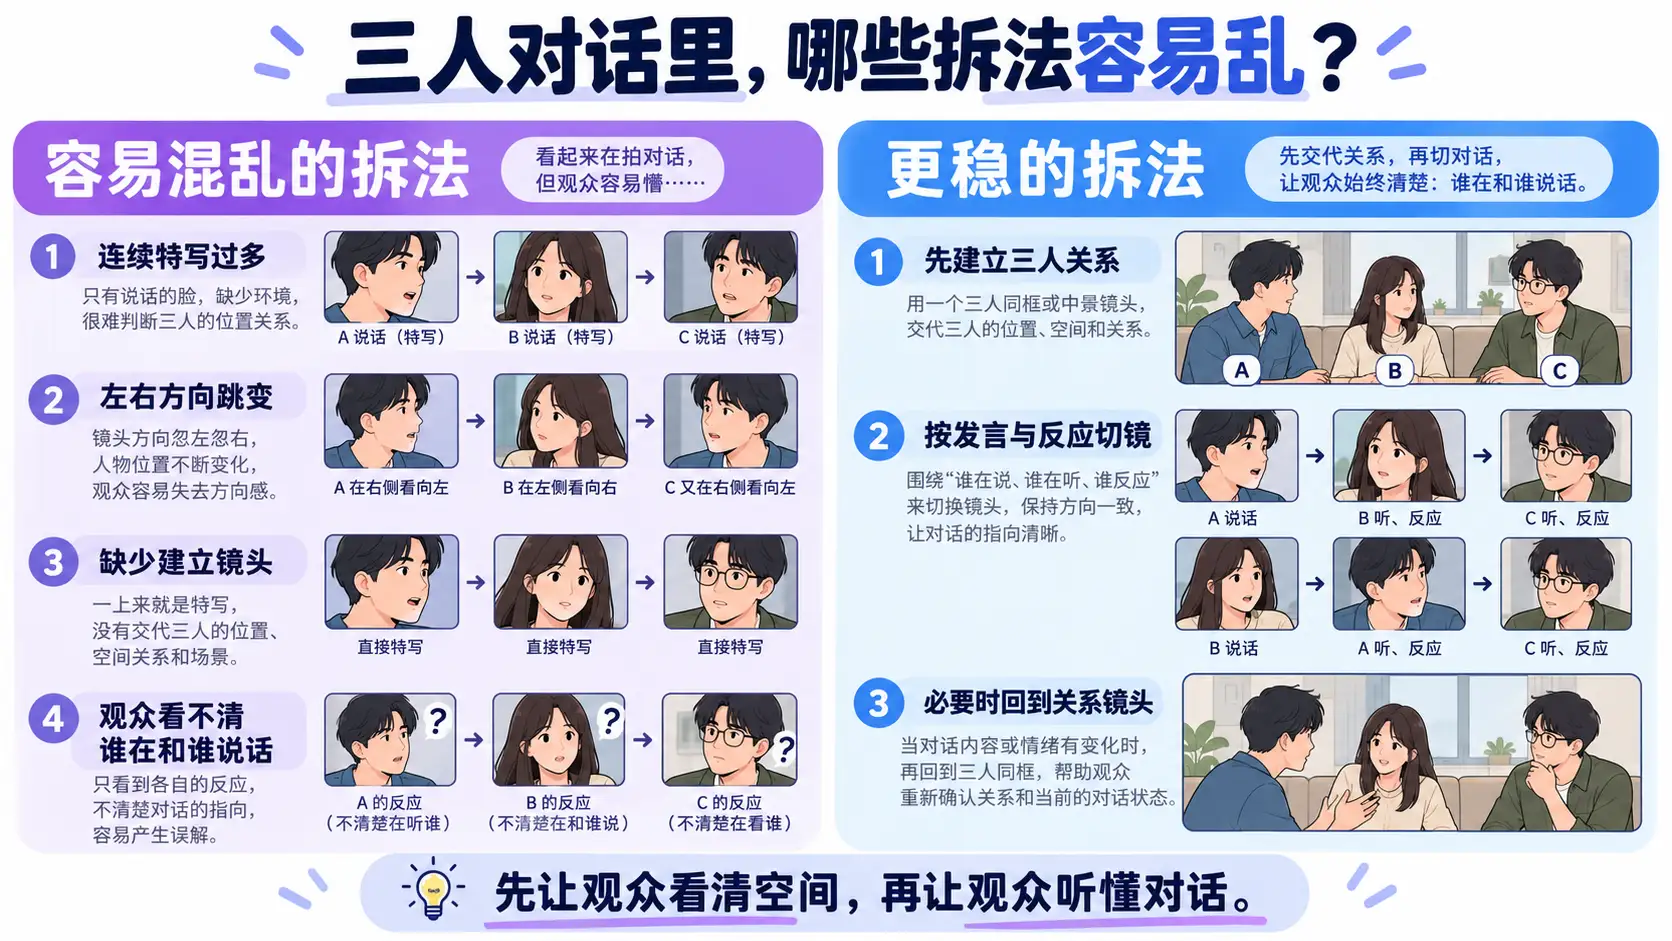
从台词上看完全没错,但做出来以后经常像三个人轮流拍证件照。因为三人对话真正增加的不是“多了一个说话的人”。而是:人物之间的关系变多了。
A 和 B 有关系。
A 和 C 有关系。
B 和 C 也有关系。
摄影机每换一个位置,观众还需要继续知道:
谁坐在哪里。
谁在看谁。
谁正在听。
谁已经准备开口。
所以多人对话拆分镜时,第一步通常不是决定“谁说话给谁镜头”。而是先把三个人的空间关系弄清楚。
先用一个具体场景来看
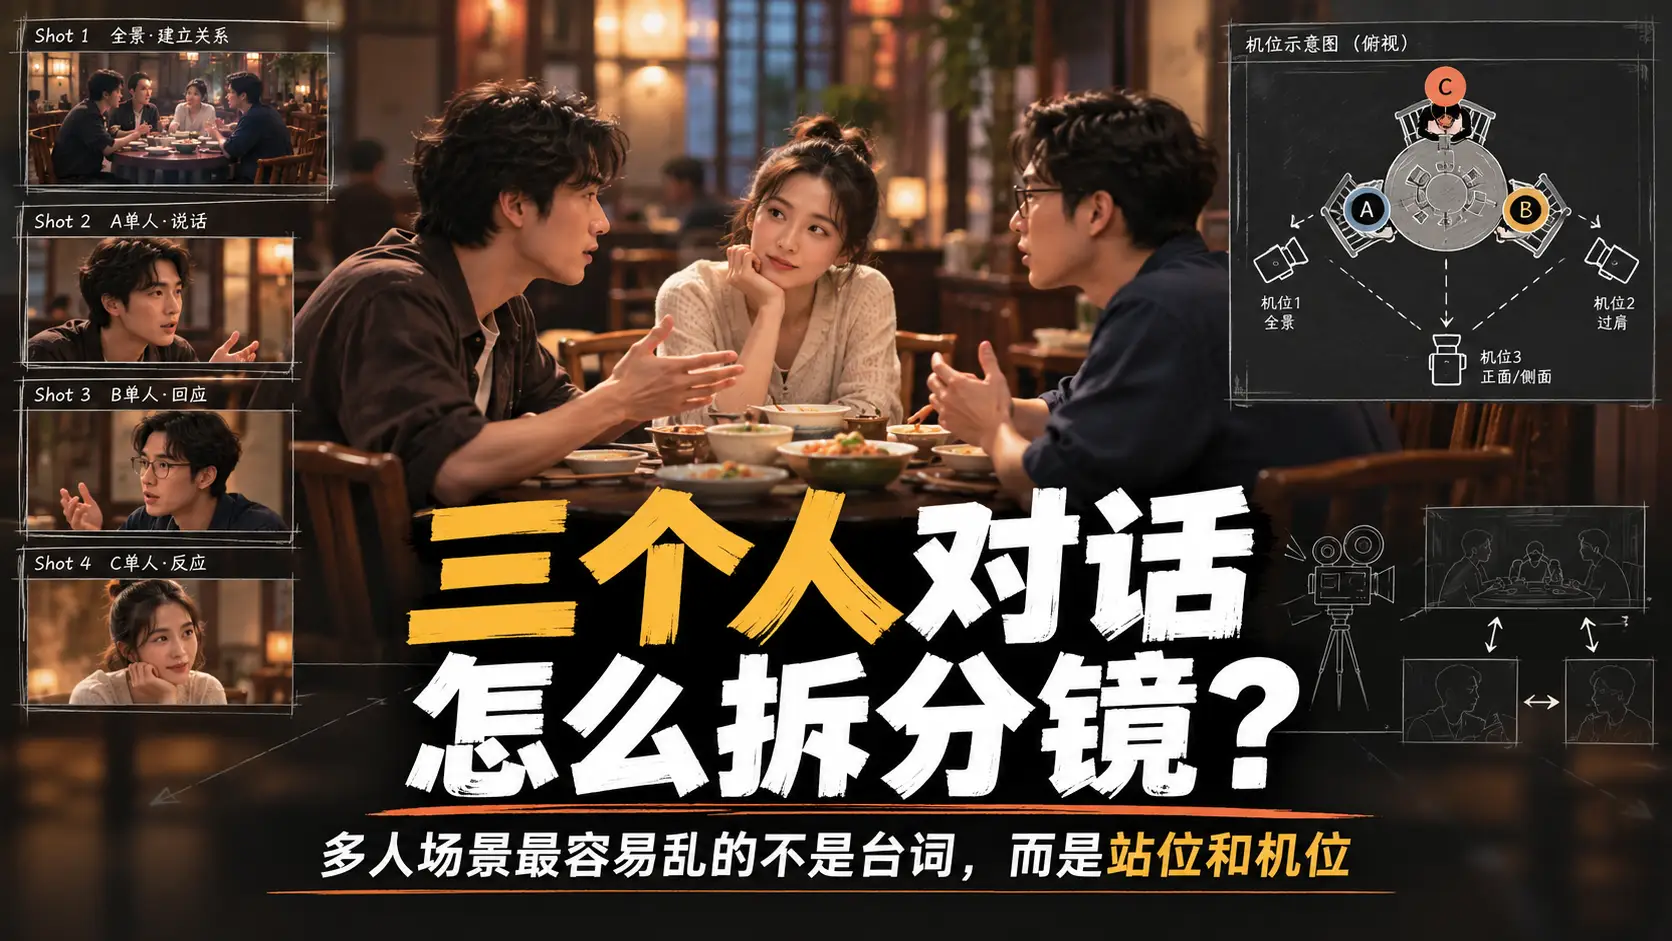
假设三个人坐在饭店圆桌边。
A 和 B 是情侣。C 是 B 的姐姐。
一开始 A 和 B 正在争论一件事情。
C 没有说话,只是在旁边听。
后来 A 说了一句:“这件事跟你没关系。”
这时候 C 抬头,说:“其实,是我让他这么做的。”
这场戏如果只按台词拆:
A 近景。
B 近景。
A 近景。
C 近景。
当然也能讲清剧情。但真正有意思的是:C 在开口以前,其实一直都在场。如果前面的镜头完全没有让观众意识到 C 的存在,那么最后切到 C 开口,就会像突然冒出来一个人。所以第一镜往往就需要先建立三个人的关系。例如:
三人中景或全景。
A 坐左侧。
B 坐右侧。
C 坐在两人侧后方。
这样观众先知道:
房间里有三个人。
接下来才有资格不断切局部。
三人对话不要只盯着“正在说话的人”
对话分镜里一个特别重要的东西是:反应。
谁说话,不代表镜头一定要给谁。比如 A 说:
“这件事跟你没关系。”
真正有价值的镜头可能不是 A 的嘴巴。而是B 听到以后低下头。或者一直沉默的 C 抬起眼睛。因为观众其实已经听见 A 在说什么。这时候画面可以去提供新的信息。所以多人场景里,可以把镜头分成两种:
一种负责交代谁在说什么。
另一种负责交代其他人听到以后发生了什么。
第二种往往更重要。比如这场饭局可以这样拆:
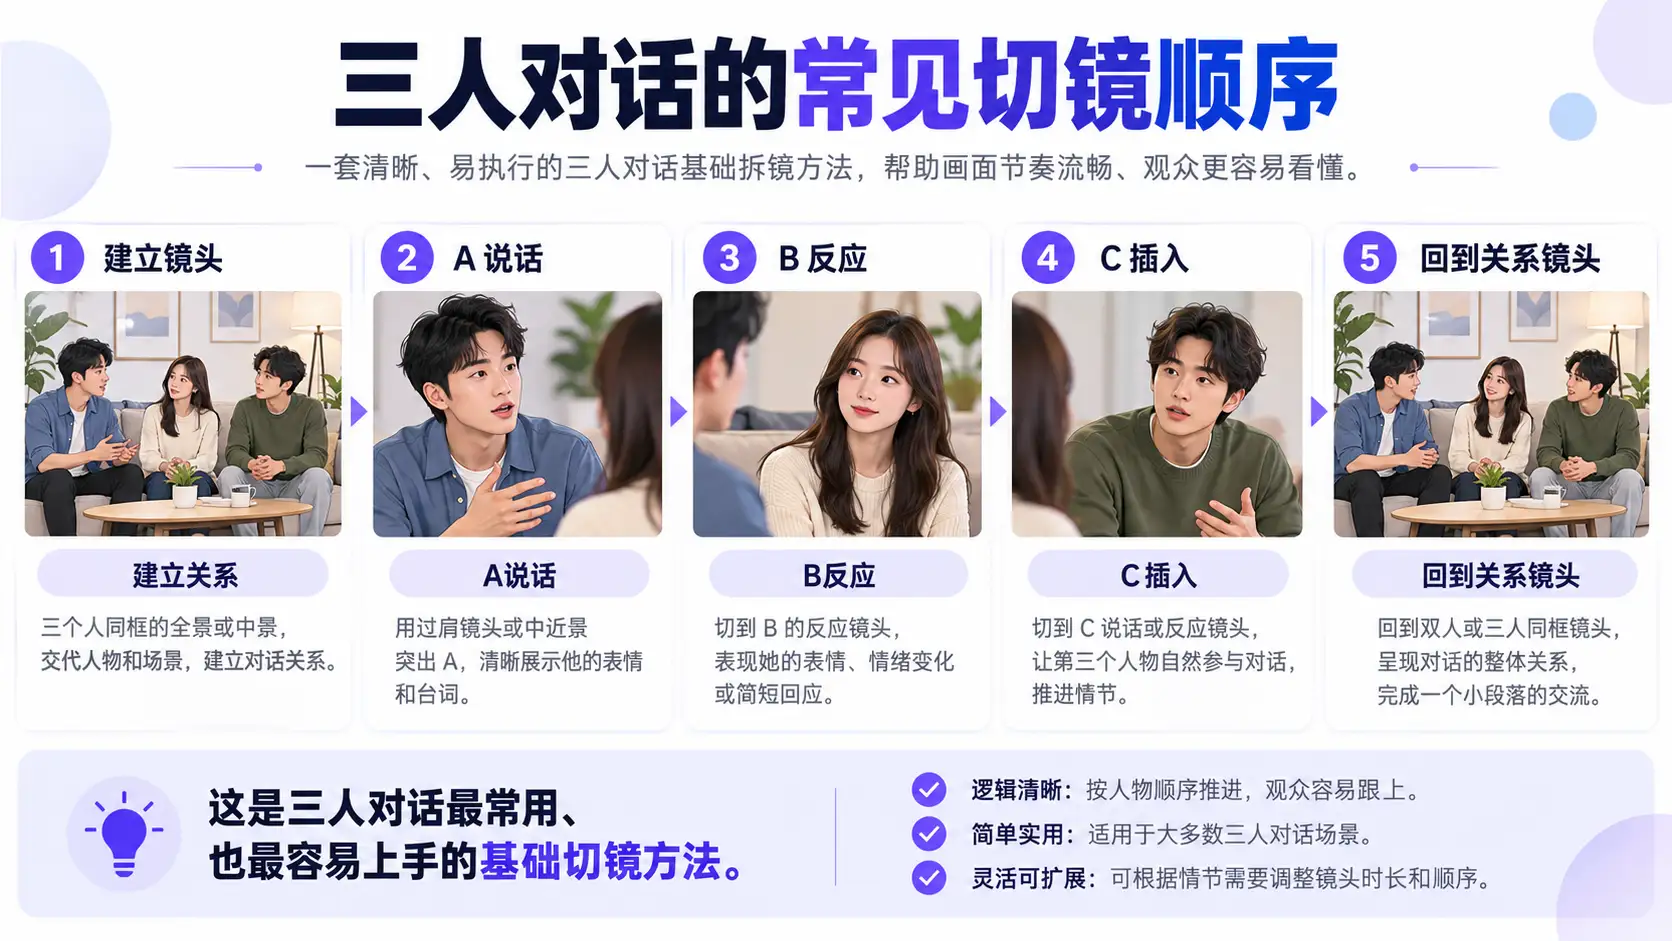
镜头 1:三人中景,建立关系。
镜头 2:A 与 B 双人镜头,两人在争论。
镜头 3:B 近景,听完后沉默。
镜头 4:A 继续说话,但画面仍停在 B 身上。
镜头 5:C 的反应,第一次抬眼。
镜头 6:C 开口。
镜头 7:A 和 B 同时看向 C。
镜头 8:重新回到三人关系镜头。
你会发现:8 个镜头并不是按照“谁说话就拍谁”机械排列。它是在不断移动观众的注意力。
双人镜头在三人场景里特别重要
三个人出现以后,不代表每个镜头都必须同时拍三个人。反而很多时候,双人镜头会变得非常有用。因为它可以告诉观众:这一刻是哪两个人之间的关系最重要。比如 A 和 B 正在争论。可以先用:
A + B 双人镜头。
C 留在画面之外。
这会让观众暂时认为:这是一场属于 A 和 B 的冲突。等到 C 真正介入时,再第一次给 C 一个明确的独立镜头。观众会马上感觉:人物关系发生变化了。
甚至还可以把 C 放在前景虚焦位置。A 和 B 在背景里争论。C 一直没有说话。这样不用台词,观众已经隐约感觉到:这个人可能会参与进来。
这就是多人分镜比“轮流近景”更有意思的地方。镜头不仅记录谁在说话。它还在不断告诉观众:现在应该关注谁和谁之间的关系。
摄影机一换位置,人物关系就不能跟着乱掉
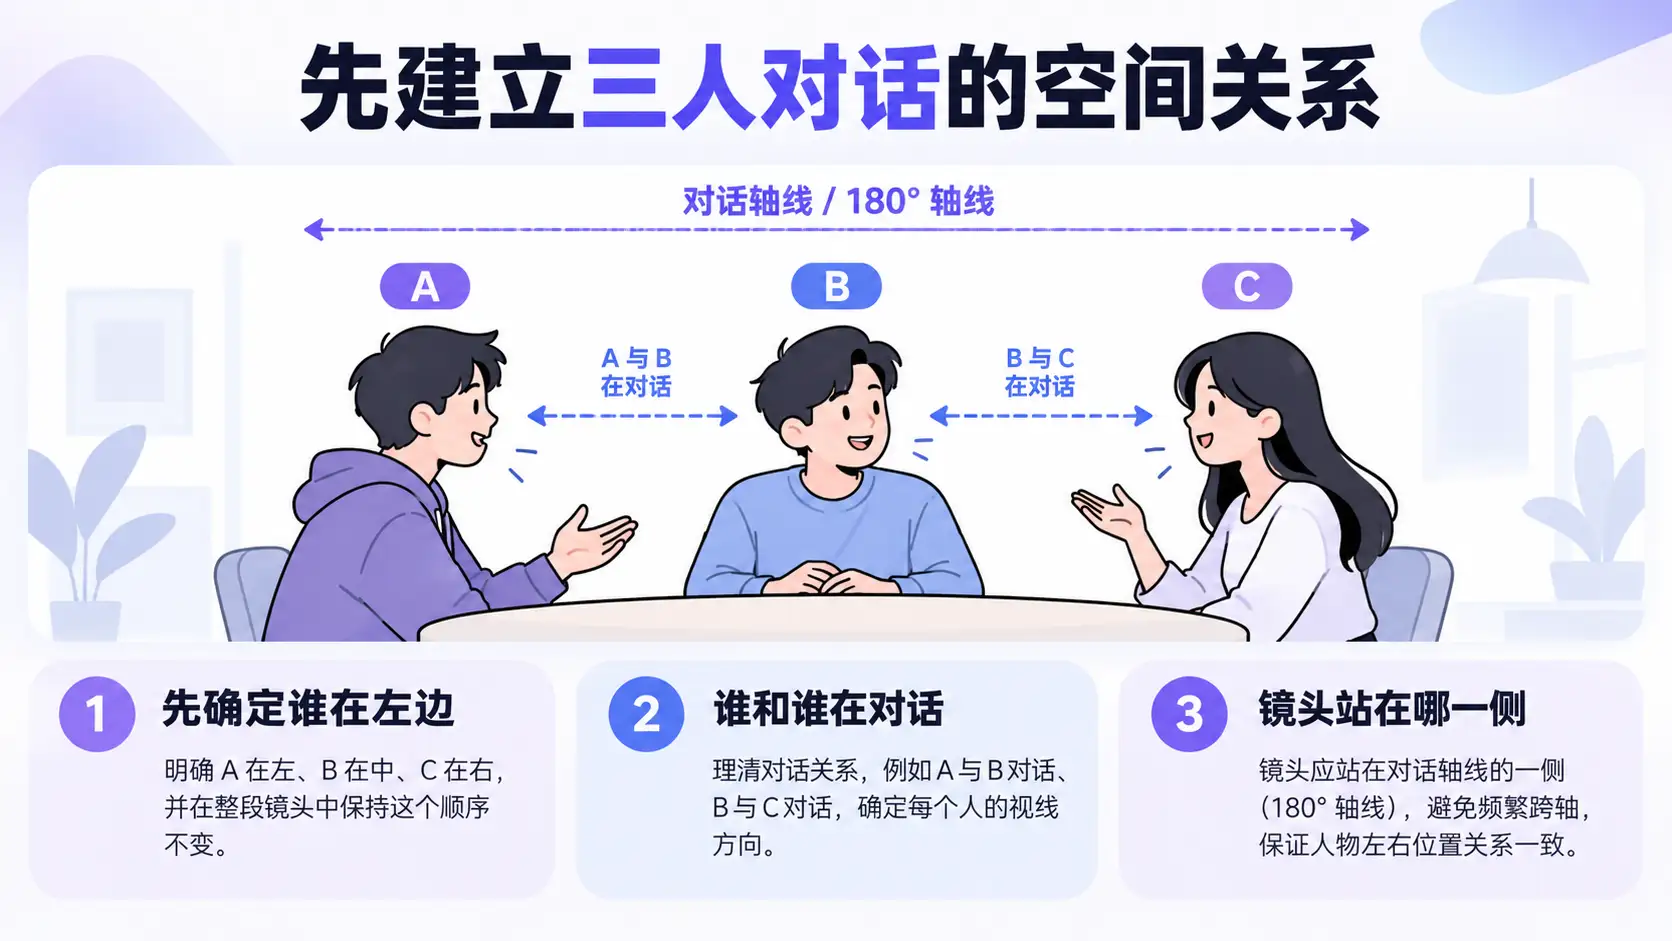
三人场景还有一个很容易出问题的地方:机位。第一镜观众看到:
A 在左。
B 在右。
C 在后方。
下一镜摄影机突然跳到另一侧,如果没有提前考虑空间关系,A 和 B 的左右关系可能马上反过来。再切一次,C 又跑到另一边。
拍真人电影时,这里面会涉及轴线和摄影机位置。到了 AI 视频,这个问题甚至更加明显。因为模型并不天然知道:
上一镜 A 坐在哪里。
摄影机上一镜站在哪里。
现在摄影机换到哪一边。
所以三个人以上以后,最好不要只在脑子里记人物位置。至少先弄清楚:
谁在哪边。
谁面对谁。
谁在前景。
谁在后景。
摄影机主要会从哪几个方向拍。
这也是为什么复杂多人镜头里,站位会开始变得重要。如果你经常遇到:人物应该在左边,却跑到了右边。摄影机一切换,人与人的位置就乱掉。可以继续看《AI 视频多人镜头总是站错位置,怎么解决?》。
人物一旦移动,分镜复杂度会再上一个台阶
刚才三个人都坐着,其实还算简单。如果突然变成:
C 站起来。
A 转头看 C。
B 也跟着站起来。
那问题一下就多了。因为下一镜不仅要保持A、B、C 是谁。还要保持谁已经站起来,谁还坐着,谁面向谁,桌子在哪,摄影机在哪。所以人物开始移动以后,我更建议把动作拆成明确状态。例如:
镜头 6:
C 抬头开口,仍坐在位置上。
镜头 7:
A、B 同时转头看 C。
镜头 8:
C 推开椅子站起。
镜头 9:
三人全景,重新建立站立后的空间关系。
而不是在一个镜头里要求:C 开口 → 起身 → 绕过桌子 → 走向 A → A 站起来 → B 阻止。
这种镜头无论真人拍摄还是 AI 生成,控制难度都会明显上升。如果人物动作和摄影机同时大幅移动,难度还会继续增加。关于人物动作和摄影机运动应该怎么配合,可以继续看《漫剧分镜中的运镜设计方法》。
三人对话还要特别注意“谁在看谁”
多人镜头里,视线也是空间关系的一部分。比如:
A 在看 B。
B 低头。
C 在看 A。
当 C 突然说话以后:
A 和 B 同时转向 C。
这套视线关系实际上非常重要。如果 AI 画出来变成:
A 看左边。
B 看右边。
C 看摄影机。
即使人物长相完全正确,观众仍然会感觉三个人不在同一个场景里交流。所以对话分镜里除了“谁说话”,还可以明确:
谁看谁。
谁回避视线。
谁正在观察别人。
什么时候所有人的注意力发生转移。
有时候真正推动一场对话的,不是台词,而是:视线第一次发生改变。
一个简单的三人对话拆镜方法
如果下次碰到三个人的对话场景,可以先不要急着写:
A 近景。
B 近景。
C 近景。
先问五个问题。
- 第一:三个人分别在哪里?先建立空间。
- 第二:现在主要是哪两个人发生关系?决定需不需要双人镜头。
- 第三:谁虽然没说话,但反应很重要?安排反应镜头。
- 第四:这一句台词说完以后,人物关系有没有变化?关系变化往往就是切镜点。
- 第五:有没有人移动,或者摄影机需要换到另一个方向?一旦有,就重新检查空间关系。
AI 多人镜头为什么特别值得在分镜阶段先解决
AI 视频里多人场景比较难,并不只是因为“AI 不会画三个人”。更大的问题是:连续多个镜头以后,模型需要不断维持人物身份、空间位置、视线、动作和摄影机关系。如果分镜本身都没有把这些事情说明白,再好的 Prompt 也很难完全补回来。所以我的习惯是:
越复杂的多人镜头,越应该把问题往前处理。
先确定:
这个镜头里有哪些人。
他们分别在哪里。
当前是谁和谁发生关系。
摄影机从哪里看。
人物接下来要不要移动。
如果文字已经很难表达,还可以先用站位构图把人物、场景和摄影机简单摆出来,再把它作为后续画图的参考。这样进入 AI 生成以后,模型要猜的东西就少很多。
最后
三个人对话并不是“两个人对话再加一个人”。
从三个人开始,分镜会真正进入:
人物关系 + 空间关系 + 摄影机关系同时存在的状态。
所以最容易出现的问题并不是台词写错。而是:
镜头一直在切人,却没有在切关系。
真正好用的多人分镜,不是 A 说话就拍 A,B 说话就拍 B。
而是每一次切镜都在回答:
这一刻,观众最需要看到什么?
可能是正在说话的人。
可能是另一个人的反应。
可能是两个人之间的关系。
也可能是一直坐在旁边、还没有开口的第三个人。
当你开始按照关系而不是按照台词机械切镜,多人场景才会真正变得清楚。