做 AI 短剧、漫剧或者小说改编视频时,很多人第一次找分镜脚本模板,都会先问:一张标准的分镜表到底应该有哪些栏目?
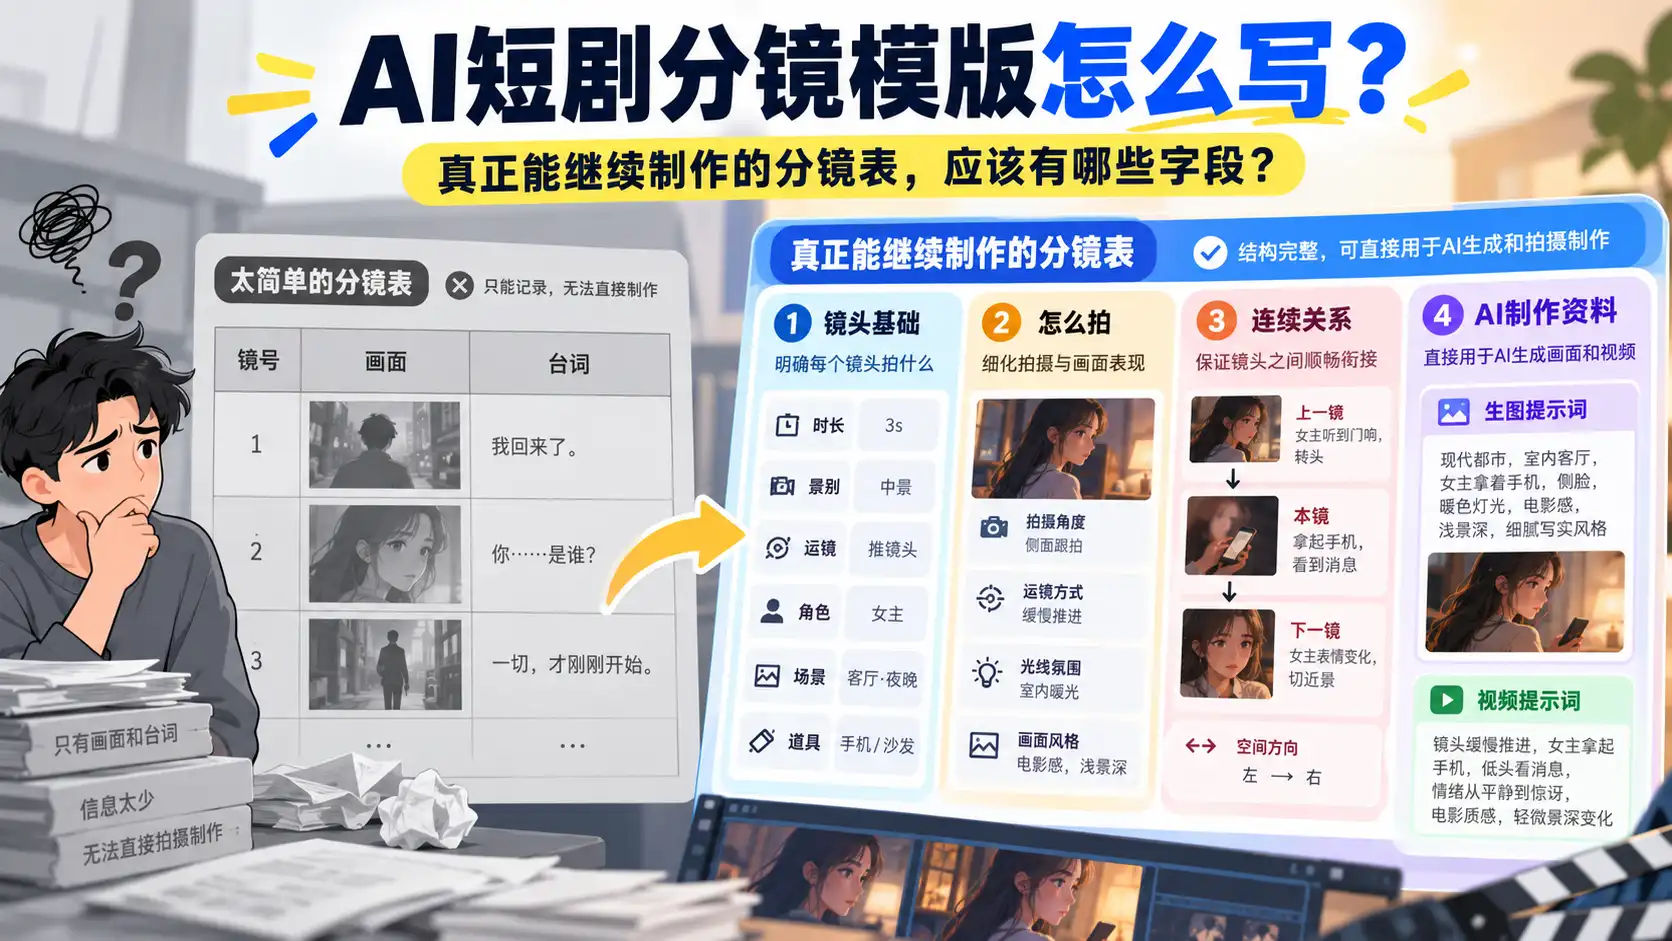
网上很容易找到各种版本。有的只有镜号、画面和台词,有的则一下子列出二十多个字段,从景别、焦段、机位一直写到灯光和声音。字段越多,看起来越专业,但真正开始制作以后会发现,问题并不是“有没有填满表格”,而是这些信息能不能继续服务下一步。
所以一张真正好用的 AI 短剧分镜模板,不应该从“我要放多少个字段”开始设计,而应该先问:从故事拆成镜头以后,我下一步还要做什么?
如果后面还要继续做角色、场景、AI 画图、连续镜头和视频生成,那么分镜表就不能只是一张镜头清单。它应该逐渐变成整个故事的制作结构。
最小可用的分镜模板,其实不用一开始就很复杂
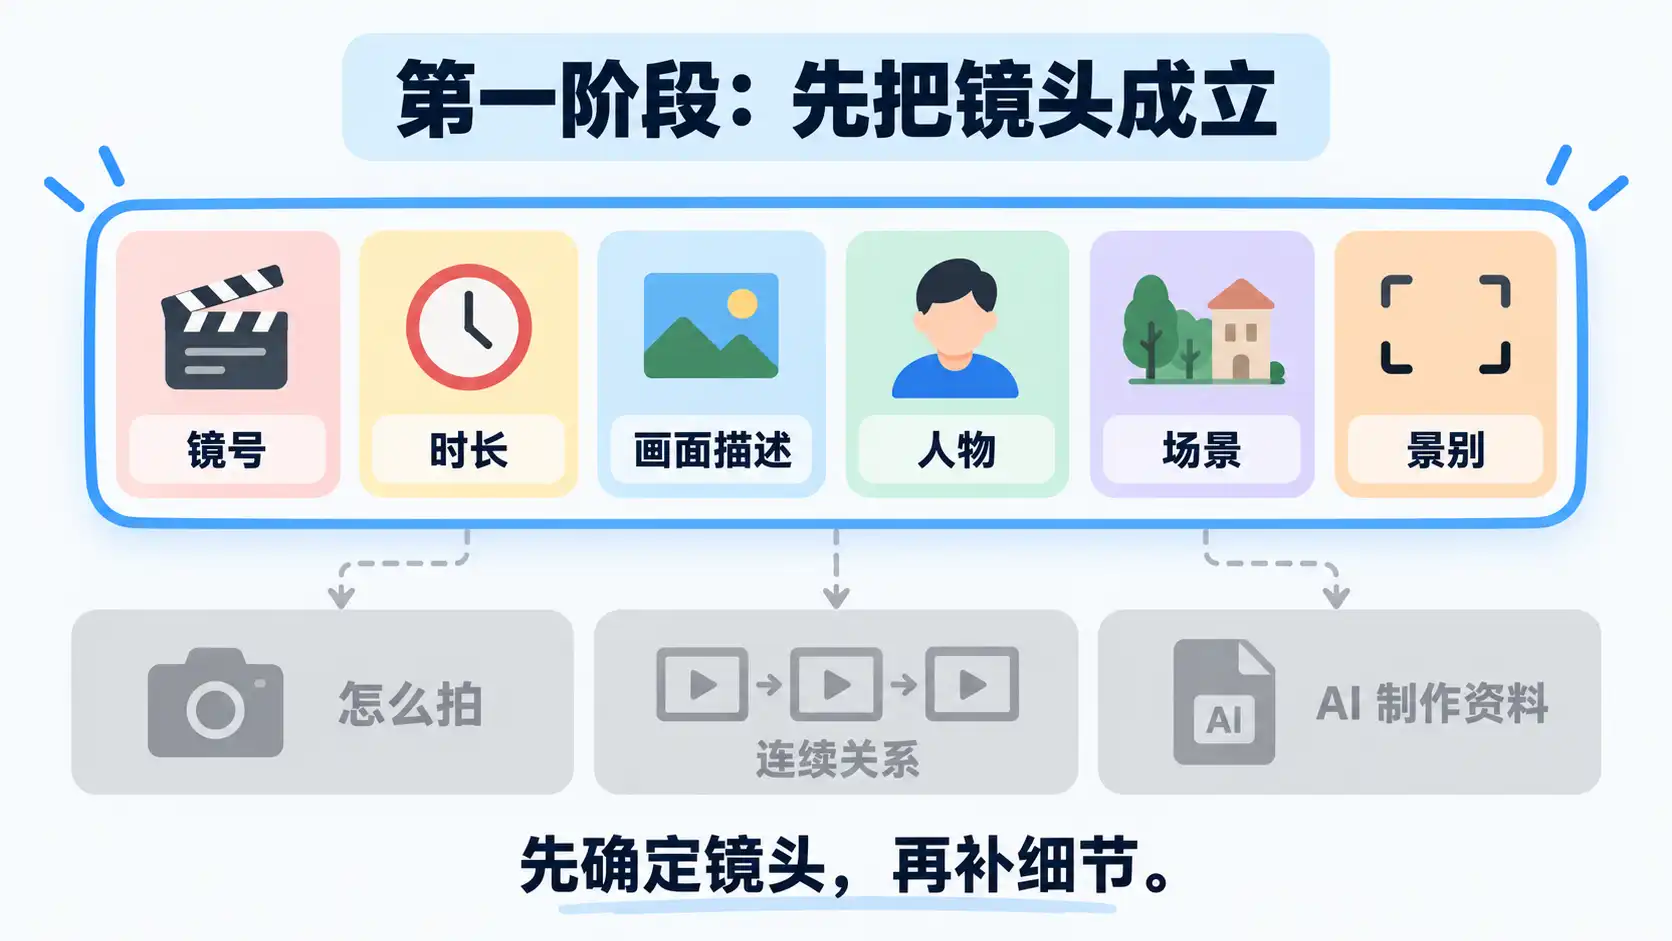
如果只是刚刚把故事拆成镜头,第一版分镜最重要的是先把结构建立起来。
这个阶段,我认为最基础的字段只有几类:
镜号、时长、画面描述、人物、场景、景别。
镜号解决顺序问题,时长告诉你这一镜大概停多久,画面描述说明观众真正会看到什么。人物和场景帮助你知道这一镜用了哪些资产,景别则确定观众从多远的位置看这一刻。
例如:
镜头 01,3 秒,中景。林川推开办公室门停在门口,视线看向桌后的老板。角色:林川、老板。场景:办公室。
到这里,其实已经是一条可以继续讨论和修改的分镜了。
最开始不需要为了“模板完整”强行把灯光、焦段、器材、声音、Prompt 全部填上。因为如果后面发现这一镜本来就不应该存在,前面填得越详细,返工反而越多。
分镜模板第一阶段最重要的,不是完整,而是镜头结构先成立。
第二层才是:这个镜头到底怎么拍
镜头结构确定以后,才值得继续补景别之外的拍摄信息。
这里通常会包括拍摄角度、运镜、焦段,以及必要时使用的器材和布光。
比如同样是“林川发现老板坐在自己的位置上”,可以用中景平视,也可以先用较宽的镜头建立空间,再切近景表现人物反应。镜头可以固定,也可以缓慢推进。
这些字段真正解决的是:
观众应该从哪里、以什么方式看见这件事。
但这里很容易出现一个误区,就是为了让分镜看起来“专业”,每一镜都强行填写复杂运镜、焦段甚至器材。
其实不是所有镜头都需要特别设计。
人物反应可能一个稳定近景就够了;环境建立可能只需要一个固定远景。真正重要的是这些选择能不能帮助剧情,而不是模板里有没有把每一格填满。
所以第二层信息应该在镜头任务已经明确以后再补。
关于镜头本身应该承载多少动作和信息,可以继续看《分镜画面描述怎么写?一个镜头里到底应该写多少动作和信息》。
一张好用的模板,到这里应该已经能够回答两个问题:
这一镜发生什么?
以及:
这一镜准备怎么让观众看到?
第三层决定了它是不是一套“连续分镜”
很多简单的分镜模板到这里就结束了。
但真正进入 AI 短剧、连续漫剧和多镜头视频以后,还会遇到另一类问题:每一镜单独看都对,连起来却不对。
比如前一镜角色在桌子左侧,下一镜突然到了右侧;两个人本来面对面,切近以后视线方向却变得一致;上一镜人物正在向门口移动,下一镜却突然从反方向出现。
所以对于连续剧情,一张真正可用的分镜表还应该逐渐记录:
角色、场景、道具、人物状态,以及必要的空间方向。
这些字段并不是为了增加表格复杂度,而是让你知道哪些东西必须在前后镜头之间保持一致。
例如:
镜头 05:林川站在办公桌左侧,老板坐在右侧。
镜头 06:切林川近景,人物仍面向画面右侧。
镜头 07:老板近景,视线朝画面左侧。
如果只有“林川近景”“老板近景”两句话,单镜完全没问题。但一旦进入连续镜头,左右关系就会开始影响观众是否相信两个人真的在对视。
这也是为什么“连续分镜 AI 工具”和普通“帮我生成几条镜头文字”的工具,本质上解决的不是完全同一件事。
真正连续的分镜,需要记住上一镜留下了什么状态。
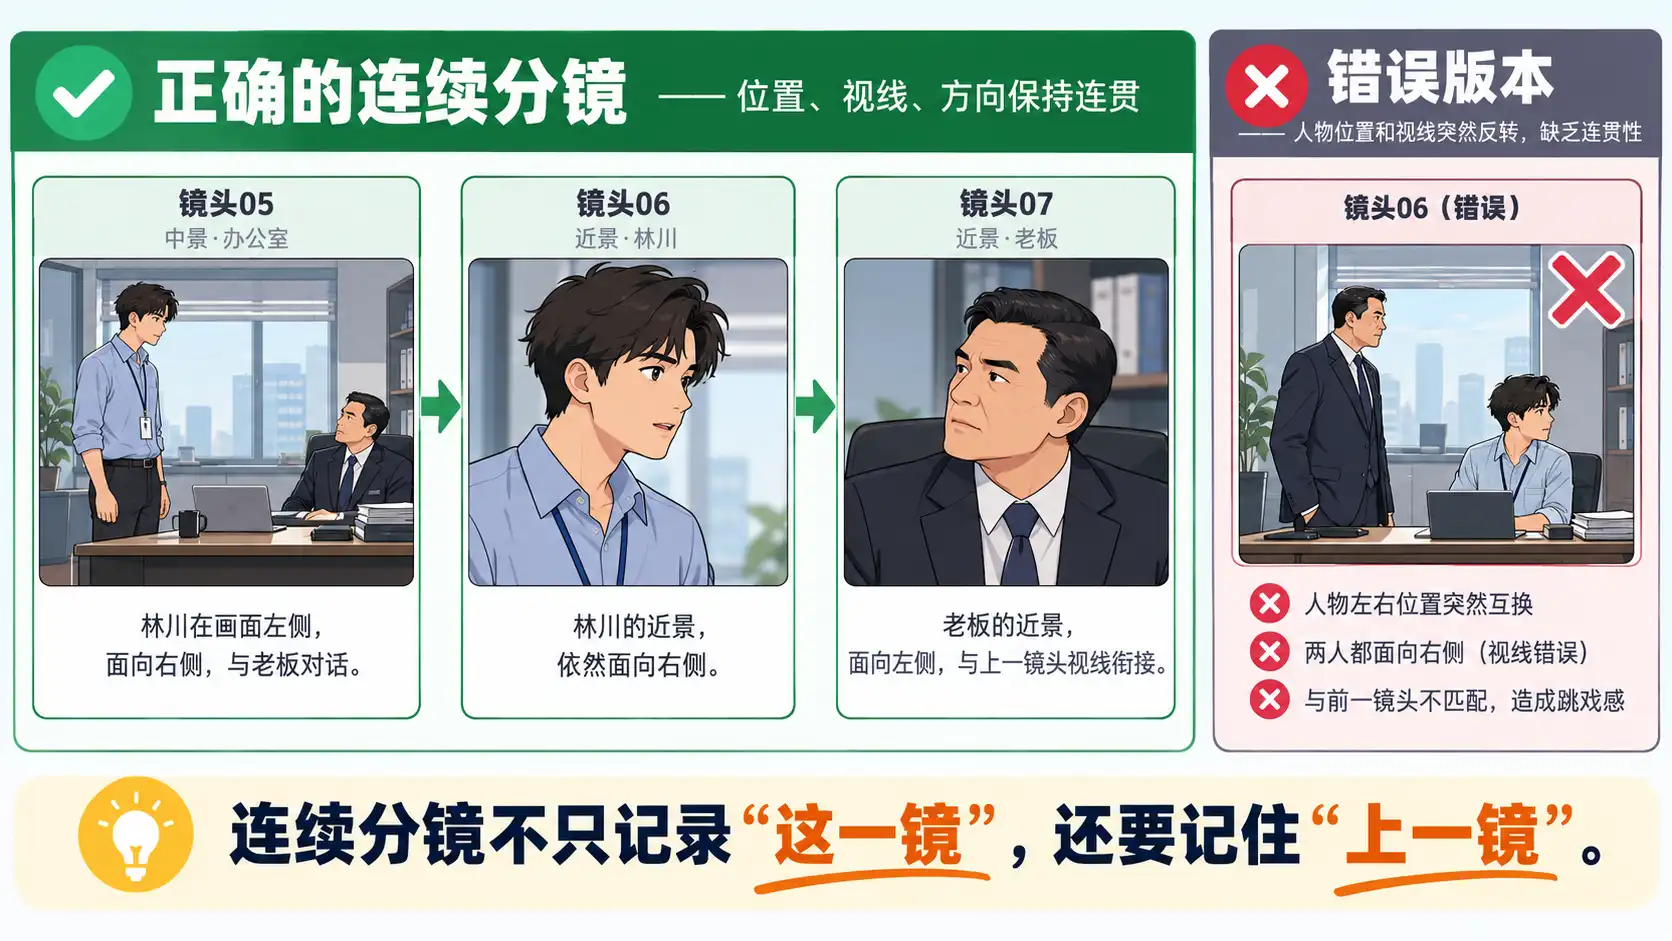
人物站在哪里,朝向哪里,手里拿着什么,道具出现在哪一侧,场景有没有变化,这些信息都可能影响下一镜。
第四层才真正进入 AI 画图和视频制作
如果分镜后面还要继续进入 AI 画图和 AI 视频,这张表还需要承担另外一件事:把每一镜后面需要用到的制作资料连接起来。
这个阶段通常会涉及生图提示词、视频提示词、关键帧、参考图,以及台词、旁白和声音等信息。
但这里同样不应该理解成“每一镜一开始就全部生成”。
更合理的方式是让这些资料跟着镜头逐步建立。
例如一条镜头先确定:
角色:林川。
场景:办公室。
道具:文件。
景别:近景。
画面:林川停在门口,视线落向老板,手里的文件慢慢藏到身后。
当真正准备生成这一镜图片时,再围绕这些已经确定的信息整理生图提示词。
进入视频阶段以后,再重点描述这一镜需要发生的变化,例如人物动作、表情变化、摄影机运动,以及镜头最后停在什么状态。
这样 Prompt 不需要每次重新解释“林川是谁”“办公室长什么样”“手里为什么有文件”。
人物、场景和道具资料负责固定不应该变化的部分,当前镜头的提示词则负责描述这一镜真正要发生什么。
这也是为什么一张面向 AI 制作的分镜表,最终会比传统的“镜号 + 画面 + 台词”多出一层制作资料。
但这些字段出现的时间应该在后面,而不是一开始就全部填满。
用一个完整例子看看这张表是怎么逐渐长出来的
假设原文是:
“女孩推开咖啡店的门,看见男友坐在窗边。她走过去坐下,男友没有说话,只把桌上的戒指盒推到她面前。”
第一版拆镜时,可以先得到:
镜头 01:女孩推门进入咖啡店。
镜头 02:女孩发现窗边的男友。
镜头 03:女孩走到桌边坐下。
镜头 04:男友把戒指盒推到她面前。
镜头 05:女孩看见戒指盒后的反应。
这时先不要急着补所有字段。
确定这五镜结构基本成立以后,再继续补:
镜头 04,2 秒,戒指盒特写。男友的手从画面右侧进入,把盒子缓慢推到女孩面前。道具:戒指盒。场景:咖啡店。人物关系保持上一镜位置。
再到 AI 画图阶段,可以给这一镜绑定男友、咖啡店和戒指盒的参考资料。
进入视频阶段,再增加:
“男友右手轻轻向前推动戒指盒,动作缓慢克制,镜头保持固定,最后停在戒指盒位于桌面中央的状态。”
你会发现,一条镜头不是一开始就写成这么复杂。
它是随着制作阶段逐渐补完整的。
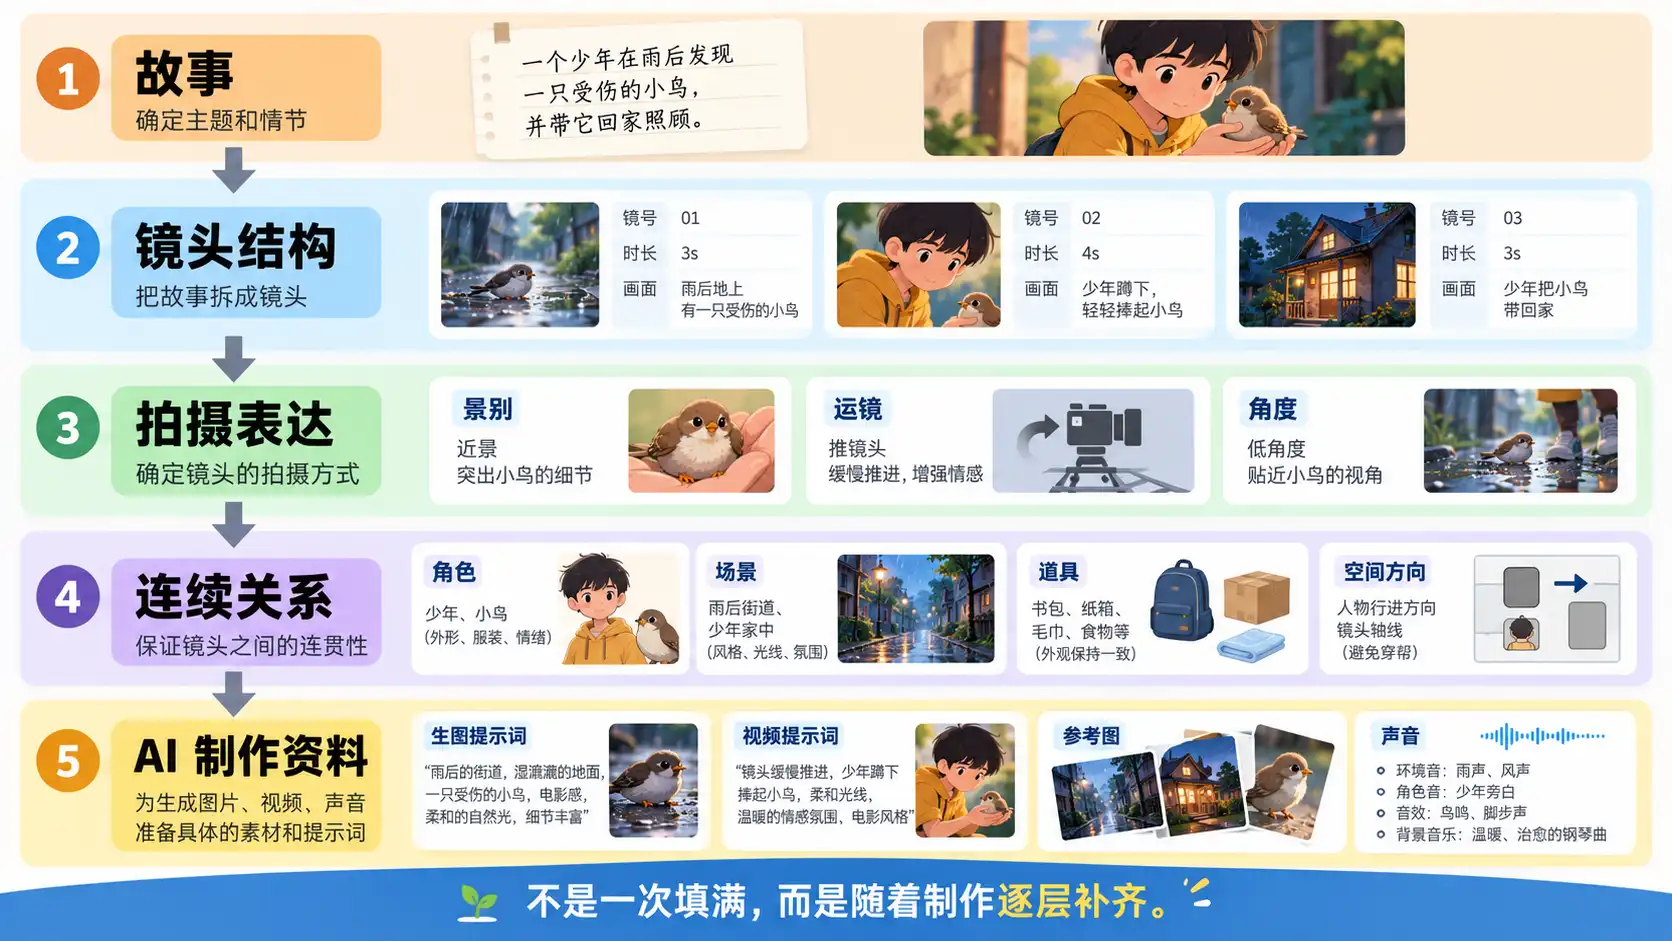
所以真正实用的分镜模板,更像是一套会随着项目推进不断增加信息的结构,而不是一张必须一次性填完的表格。
哪些字段不是每一个项目都必须有
很多人看到专业分镜表以后,会因为没有填写焦段、器材、灯光、机位坐标而觉得自己的分镜“不够专业”。
其实这些字段是不是需要,取决于你后面怎么制作。
如果是 AI 漫剧,角色、场景、道具、画面描述和连续关系往往非常重要。
如果是真人拍摄,器材、焦段、机位和布光可能会变得更重要。
如果主要使用参考图生成视频,那么角色和场景资产、起始画面、人物动作和运镜信息的重要性又会上升。
所以模板不应该强迫每个项目使用同样多的字段。
更实用的方式,是先保证核心字段存在,然后根据后面的制作方式增加信息。
可以把它理解成四层:
第一层:镜头结构
镜号、时长、画面描述。
第二层:拍摄表达
景别、拍摄角度、运镜、必要的焦段和布光。
第三层:连续关系
角色、场景、道具、人物状态、空间方向。
第四层:AI 制作资料
生图提示词、视频提示词、关键帧、参考资料、台词、旁白和声音。
这四层不需要同时完成。
真正高效的顺序应该是:先把上面的结构做对,再逐渐往下补。
最后:真正好用的分镜模板,不是字段最多的那张
如果只是为了保存镜头列表,一张三四列的表格已经够用。
但如果你做的是 AI 短剧、漫剧、小说视频化或者几十个镜头以上的连续内容,分镜很快就会承担更多任务。
它不只是告诉你“下一镜是什么”。
它还需要帮助你记住这个角色是谁、当前在哪个场景、用了哪个道具、人物站在哪里、下一镜要保持什么,以及做图和视频时应该继续使用哪些资料。
所以判断一张 AI 分镜模板好不好,不要只数它有多少字段。
真正应该问的是:
故事拆完以后,这张表能不能让后面的每一步少重新整理一次。
能做到这一点,它才真正从一张分镜表,变成了一套可以继续制作的故事结构。