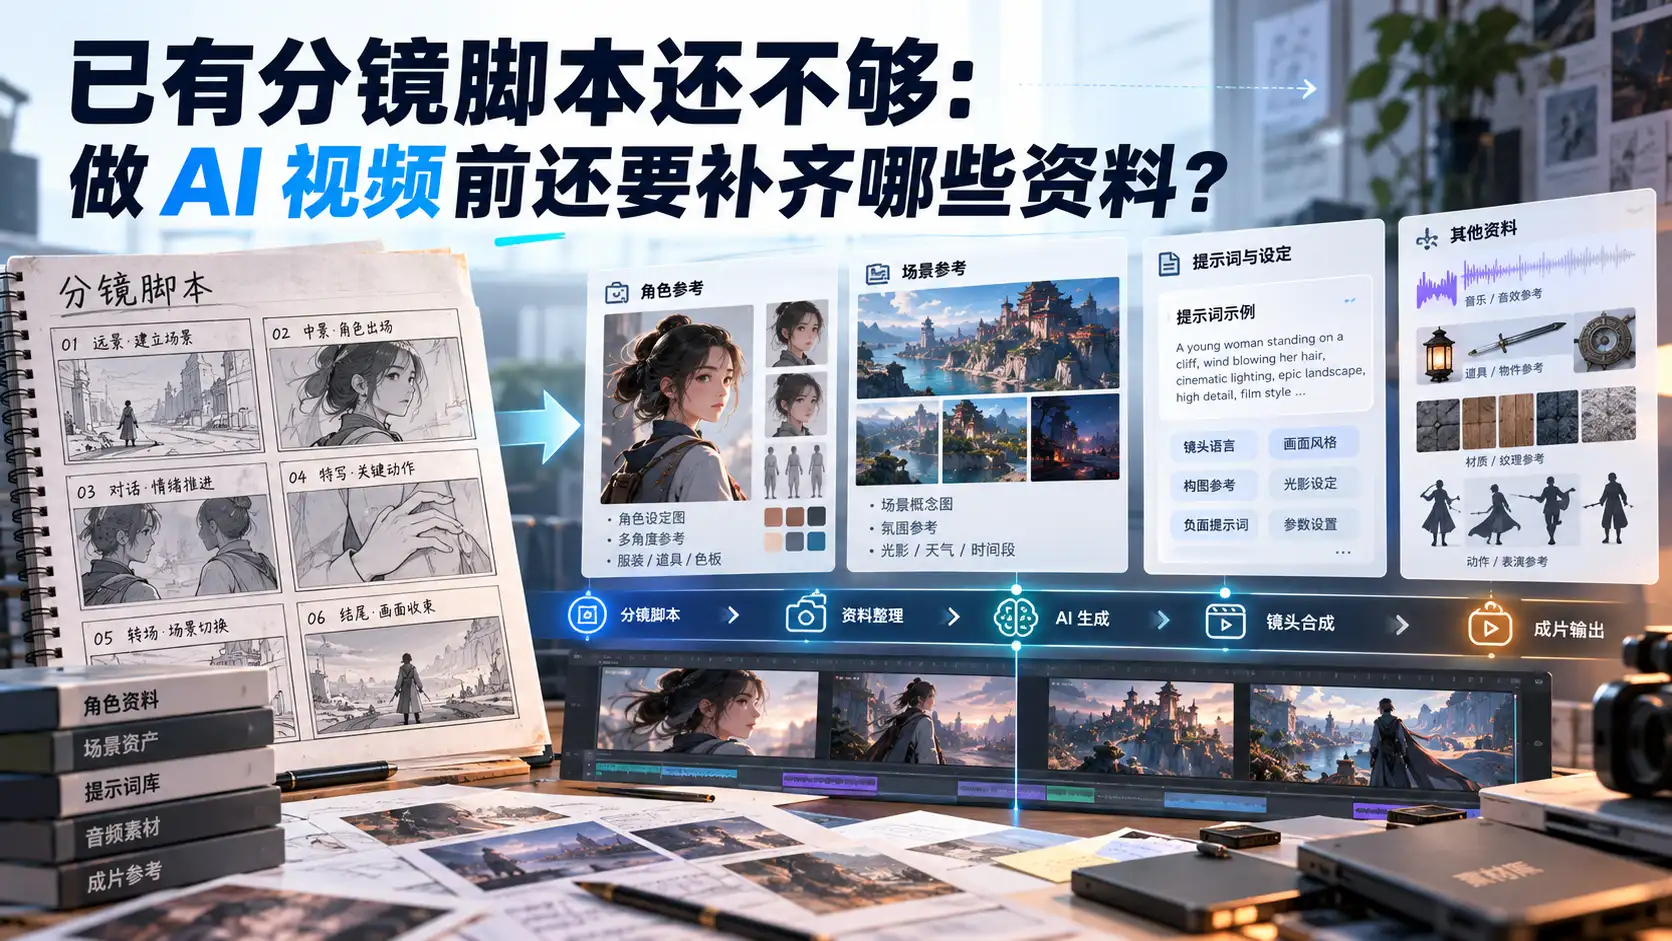
很多人做到 AI 视频这一步时,会遇到一个很实际的问题:分镜已经写好了,下一步到底该干什么?手里可能已经有这样的内容:
镜头 01,全景,饭店走廊,两个人并肩往包间方向走。
镜头 02,中景,男生看向女生说话。
镜头 03,近景,女生有些紧张地笑了一下。
镜头 04,男生伸手推开包间门。
从分镜角度看,这已经是一段完整的镜头设计。但如果现在直接开始做 AI 视频,很快就会发现还有很多问题没有答案。
男生到底长什么样?
女生穿什么衣服?
饭店走廊是什么风格?
包间和走廊之间是什么空间关系?
第三镜应该引用哪张人物图?
第四镜的视频提示词应该怎么写?
上一镜男生伸出的到底是哪只手?
所以:“已经有分镜”和“已经有一套可以继续生成 AI 视频的资料”其实不是一回事。分镜解决的是故事怎么变成镜头。真正进入 AI 视频制作,还需要继续把每个镜头需要使用的资料补齐。
第一类:先确认你的分镜到底已经写到什么程度
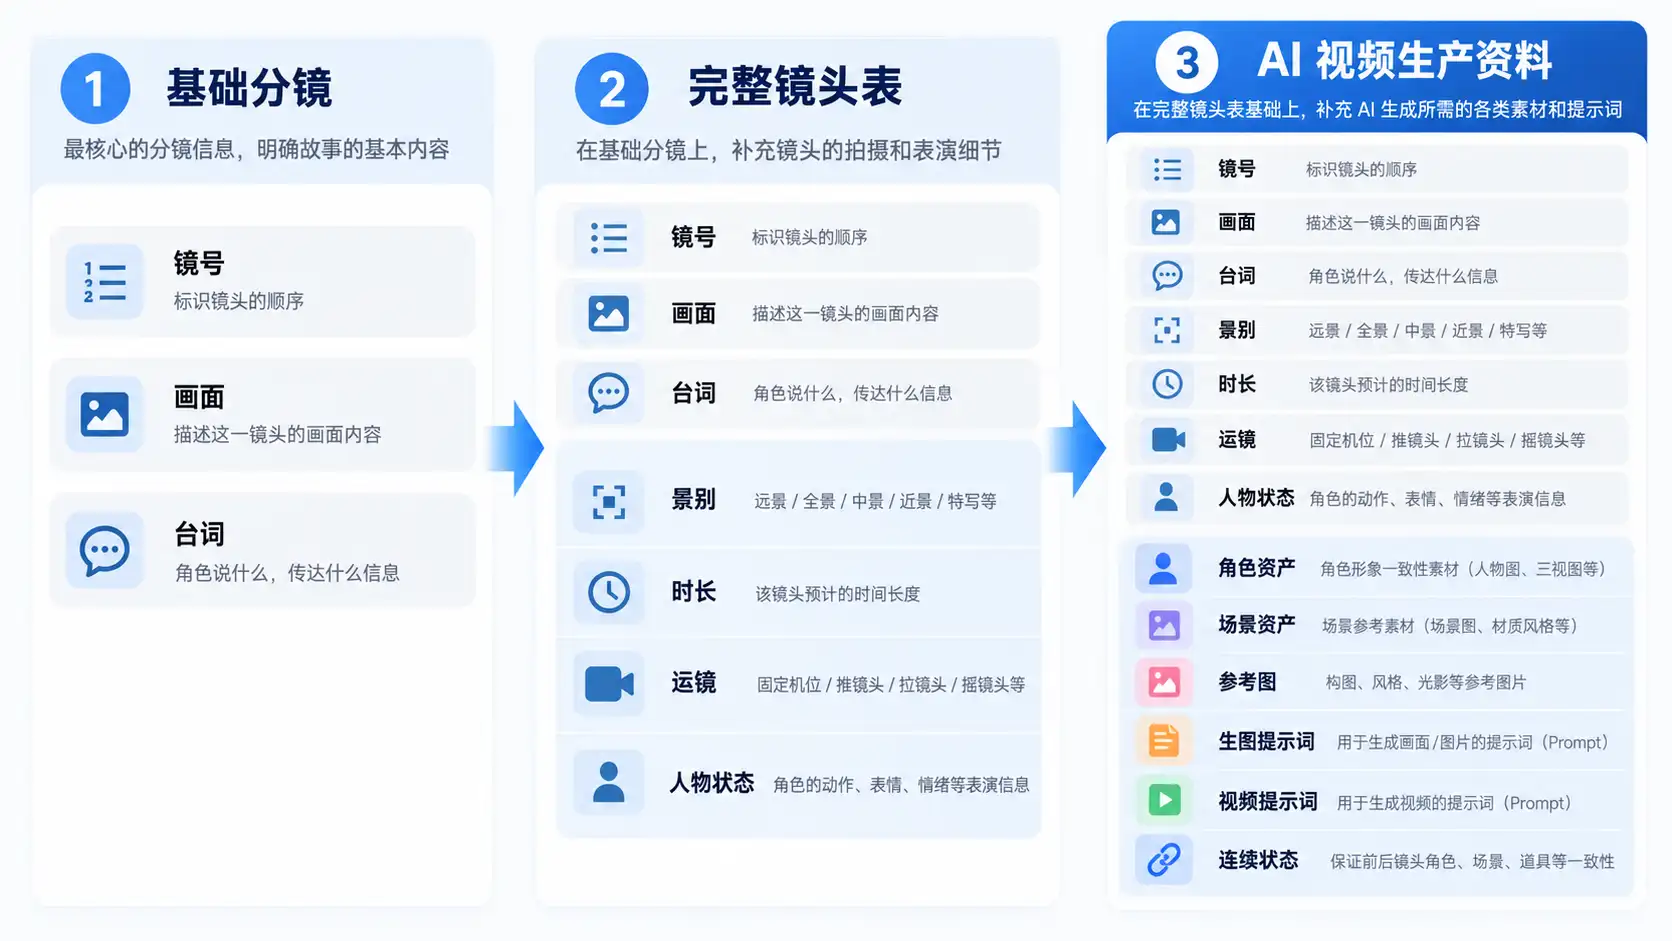
并不是所有“分镜脚本”包含的信息都一样。有的分镜可能只有:
镜号
画面描述
台词
有的已经进一步包含:
景别
时长
运镜
人物状态
声音
拍摄角度
还有一些制作得比较完整的镜头表,甚至已经有:
生图提示词
视频提示词
角色
场景
道具
参考图
所以拿到一份已有分镜以后,第一步不一定是重新生成。更应该先问:现在已经有什么,还缺什么?比如一份已经写得很好的导演分镜,完全没有必要再让 AI 把故事重新拆一次。保留原来的镜号、节奏和镜头设计,把缺少的生产资料继续补上,往往更合理。
第二类:角色资料
如果一个角色只出现一镜,可能问题还不明显。但连续剧情里,同一个人物往往会出现十几个甚至几十个镜头。这时候,只在每一镜里写:
年轻男性,黑色短发,穿黑色外套。
通常是不够的。你至少需要知道:
这个角色的固定外观是什么。
常用服装是什么。
有没有固定配饰。
不同镜头到底应该引用哪张角色参考。
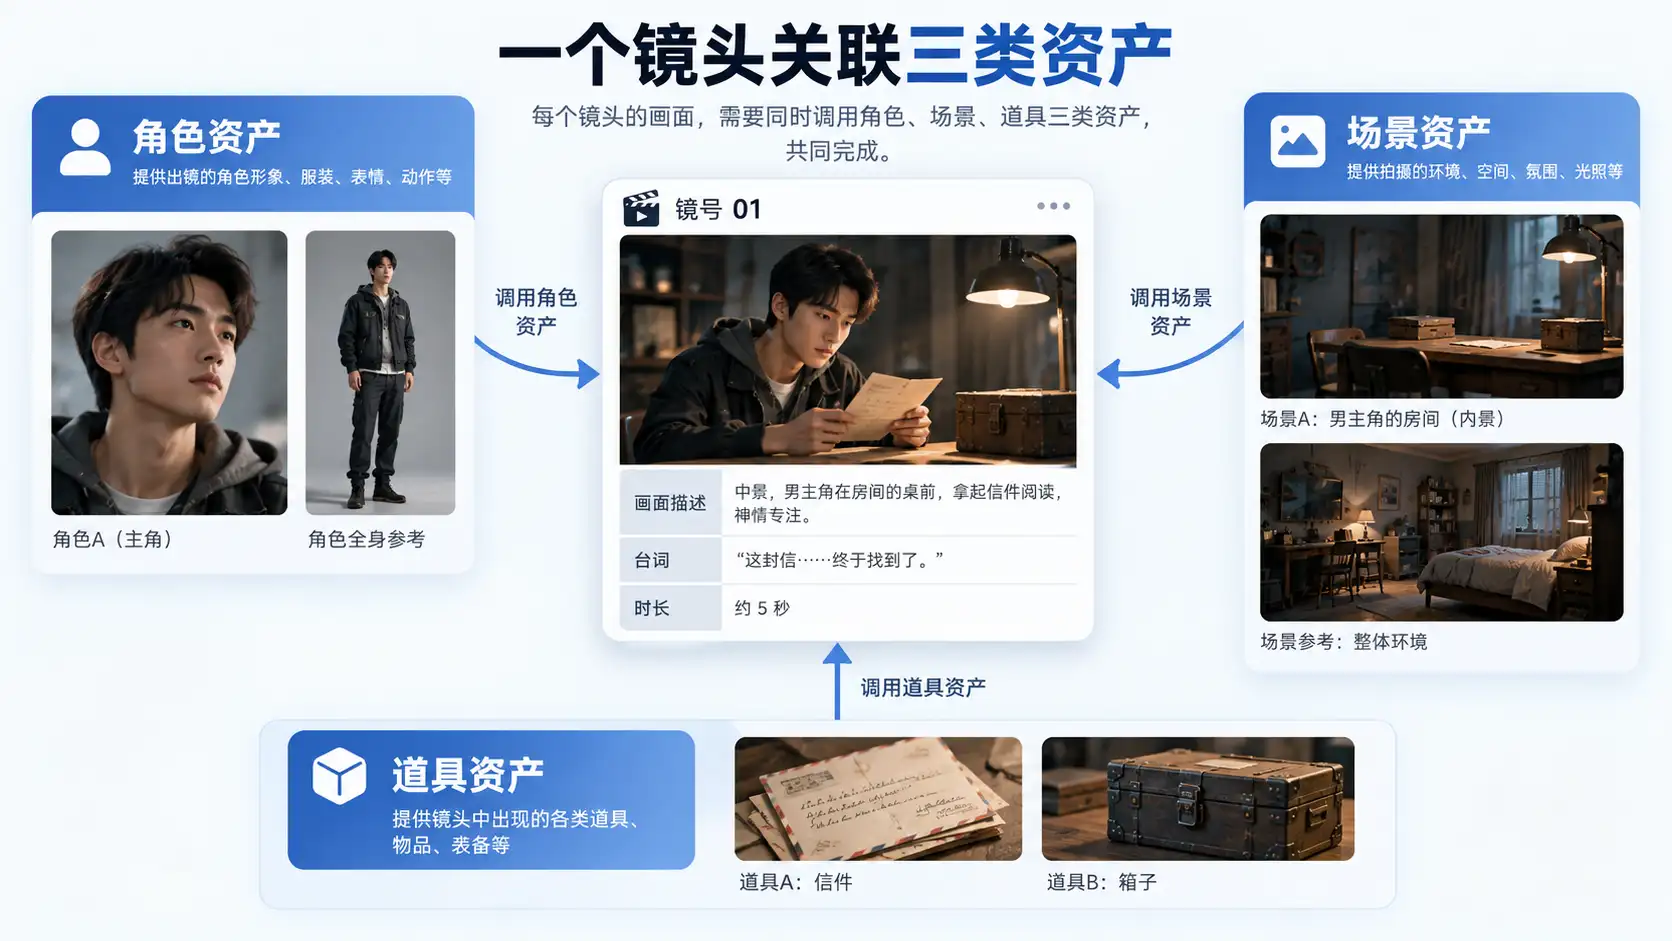
所以角色最好作为独立资产存在,而不是散落在几十条提示词里。角色资料通常可以包括:
角色描述
角色参考图
正面或侧面状态
全身或半身状态
固定服装
关键识别特征
后面的镜头再围绕同一个角色继续生成。关于这部分为什么越做到后面越像资产管理,可以看《AI 视频做到最后,拼的其实是资产管理能力》。
第三类:场景和道具资料
分镜里写一句:
饭店包间。
对导演来说可能已经足够理解剧情。但对 AI 来说,这个信息仍然非常宽。
到底是中式包间还是现代西餐厅?
圆桌还是长桌?
门在哪里?
窗在哪里?
光线是什么颜色?
墙面是什么材质?
如果一个场景会连续出现很多镜头,最好同样把它作为稳定资产准备下来。包括:
场景描述
场景参考图
主要家具
关键道具
固定空间结构
光线和时间状态
道具也一样。如果一个手机、一封信、一把刀、一只箱子会反复影响剧情,就不能每到一个镜头再重新让 AI 设计一次。
第四类:每一镜到底需要引用哪些参考图
资料准备好以后,还有一个更具体的问题:这一镜到底该把什么交给模型?例如两个人在饭店包间里对话。这一镜可能需要:
男主参考图
女主参考图
饭店包间场景图
如果空间关系比较复杂,还可能需要站位构图。
但另一个人物特写镜头,也许根本不需要把所有资料全部塞进去。所以参考图不是越多越好。更合理的思路是:当前镜头需要什么,就引用什么。
角色参考负责告诉模型“是谁”。
场景参考负责告诉模型“在哪里”。
站位构图负责告诉模型“人怎么站、摄影机怎么看”。
关于不同参考资料到底分别负责什么,可以继续看《AI画镜头时,如何引用角色、场景和站位构图?》。
第五类:生图提示词
如果你的工作流是:分镜 → 分镜图 → 图生视频那么在真正生成视频以前,通常还会先经历一轮画图。这时候,已有的“画面描述”不一定能直接等同于生图提示词。例如分镜写的是:
女生看见房间里坐满亲友,表情瞬间僵住。
这是很好的叙事描述。但生成画面时,可能还需要进一步确定:
景别
人物位置
摄影机方向
人物表情
场景里需要看见什么
构图重点
所以生图提示词的任务,是把分镜进一步翻译成:这一张画面应该怎么生成。但已经固定好的角色和场景,不一定还要在提示词里反复从头描述。这也是为什么前面的资产和参考图越稳定,后面的提示词反而可以更聚焦。
第六类:视频提示词
视频提示词和生图提示词又不是一回事。分镜图已经确定以后,视频阶段真正需要解决的是:
人物怎么动。
摄影机怎么动。
这一镜从什么状态开始。
到什么状态结束。
例如一张图里男生已经站在门前,右手放在门把手上。视频提示词更应该描述:
男生缓慢压下门把手,将门向内推开,随后停顿,摄影机轻微向前推进。
而不是再花大量篇幅重新描述:
男生是谁。
饭店长什么样。
门是什么材质。
这些信息如果前面已经确定,就应该尽量继承。关于视频提示词怎么写,可以继续看《AI视频提示词如何设计?》。
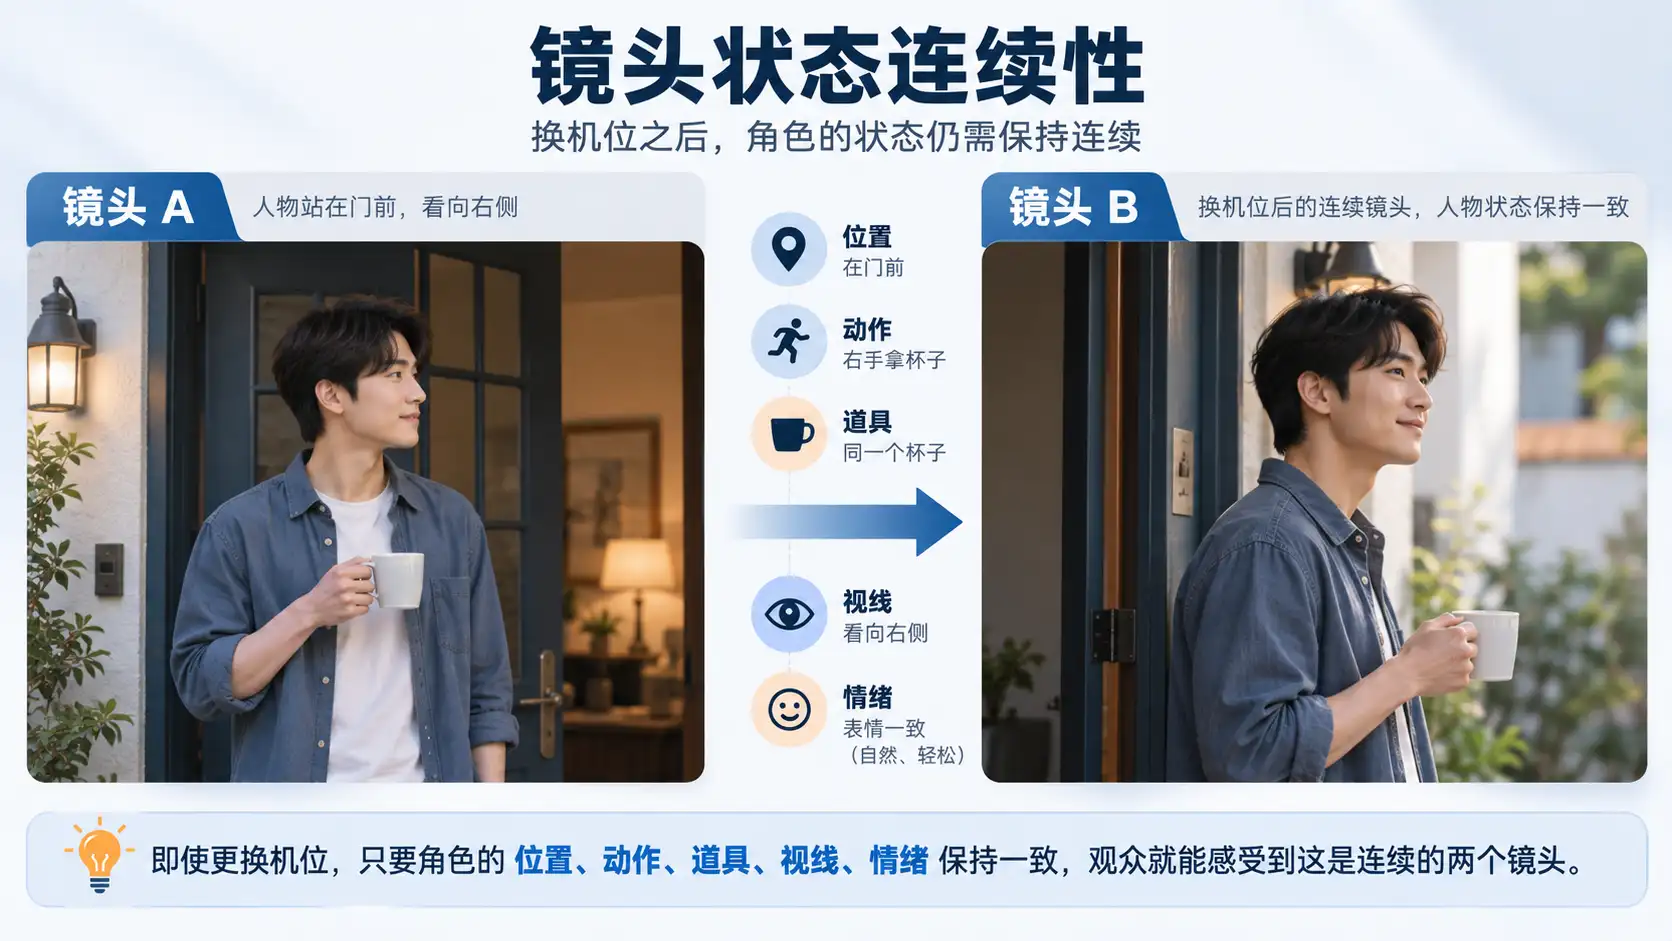
第七类:前后镜头的连续状态
这一步特别容易被忽略。单个镜头的资料已经很完整,并不代表整段视频一定连续。例如:
镜头 5 里女生拿起一个杯子。
镜头 6 切到近景,杯子却又回到了桌面。
或者:
上一镜人物走到了门口。
下一镜换机位以后,人又退回了房间中央。
所以连续剧情还要记录:
人物上一镜在哪里。
正在做什么。
手里拿着什么。
面向哪个方向。
当前情绪状态是什么。
下一镜从哪个状态继续。
这其实已经从“单镜头生成”进入了“连续镜头管理”。当视频越长,这部分的重要性越明显。
有分镜以后,真正需要的是一份“制作资料包”
所以如果把这一整套东西重新整理一下,一份可以真正进入 AI 视频制作的分镜资料,通常会逐渐包含:
镜号和镜头描述。
角色、场景、道具。
景别和运镜。
人物状态和空间关系。
对应参考图。
生图提示词。
视频提示词。
前后镜头连续状态。
当然,并不是每个项目都必须把所有字段填满。一个简单的 15 秒短视频,可能只需要几张参考图和几个动作描述。但项目越长、人物越多、场景越复杂,需要提前固定的资料就越多。真正决定工作量的,往往不是“有多少个镜头”,而是:这些镜头之间有没有大量需要重复保持的东西。
如果你已经有分镜,不一定要重新拆一次
这点很重要。如果手里的分镜已经有镜号、画面、台词、景别和运镜,就没有必要重新把原稿当成小说再拆一遍。更合理的做法是:
保留原来的镜头结构。
检查缺少哪些字段。
补角色和场景资料。
补参考图。
再逐步整理后续生图和视频制作需要的信息。
在小镜故事板里,也可以从空白分镜开始,把已有镜头按原来的结构整理进分镜表,再继续补角色、场景、道具、参考图和后续制作资料。目前小镜故事板并不是自动把你上传的整份现有分镜直接识别并补全,所以这里我更建议把它理解成:把已有分镜继续整理成一套可以往后生产的项目资料。这和“重新帮你拆一次故事”是两件事。
从已有分镜到 AI 视频,可以简单理解成这条链路
已有分镜脚本
↓
检查镜头缺失信息
↓
建立角色 / 场景 / 道具资产
↓
准备当前镜头需要的参考图
↓
生成或整理分镜画面
↓
补视频提示词和人物动作
↓
生成视频
↓
检查前后连续性
↓
剪辑
如果你现在正处在“分镜已经做好,但不知道怎么开始进入可灵、即梦等视频生成工具”的阶段,也可以继续看《分镜怎么生成 AI 视频?从分镜脚本到可灵生成视频的完整流程》。
最后
分镜脚本非常重要。但它解决的主要是:故事应该怎么被拍成一个个镜头。AI 视频生产还需要继续解决另一件事:每个镜头到底拿什么资料去生成,以及这些资料怎样在几十个镜头之间持续保持一致。
所以有分镜以后,不一定马上就要点“生成视频”。先检查一下:
角色有没有固定。
场景有没有固定。
参考图准备好了没有。
每一镜需要引用什么。
生图和视频提示词有没有分开。
前后镜头的动作状态能不能接上。
这些东西补齐以后,一份普通的分镜脚本才真正开始变成:可以继续进入 AI 视频制作的生产资料。